ARTICLE · 1125220
从 PDF 到交互学习页:learn-from-materials 与 opencode 集成全流程
AI 编程助手能写代码、能调试、能重构,但它能"读一本书"吗?
我说的不是把 PDF 丢给大模型,让它吐一段摘要——这种用法你试过,结果往往是"看起来说了很多,但什么也没说"。真正的阅读需要结构化理解:理清概念之间的关系、拆解方法论、标注知识出处、生成可检索的知识库,最后用交互式网页呈现出来,让读者可以按自己的节奏学习。
这周我把一个开源 Agent Skill——learn-from-materialsre——正式集成到 opencode 工作流里,并用一本 331 页的 Terraform 书做了完整 POC 验证。本文记录整个过程。
● ● ●
learn-from-materials 是什么
learn-from-materials 是一个开源 Agent Skill(GitHub 840 Star),设计目标很纯粹:把书籍、课件、文档等学习材料拆解成可追溯的知识库,并生成交互式学习网页。
它的核心理念是"两阶段流程":模型负责理解、提炼和讲解;脚本只负责提取、校验、渲染与交互。换句话说,AI 做内容创作,脚本做工程交付,各司其职。
支持的材料格式覆盖了常见场景:PDF、EPUB、MOBI、DOCX、PPTX、HTML、Markdown、TXT、RTF。输出则是三种形态:可追溯知识库(.learnkb 目录)、交互式学习 HTML、Markdown 版本。
它本身就是一个 Agent Skill——有标准的 SKILL.md 入口,设计为放到 agent skills 目录里直接用。官方支持 WorkBuddy、Codex、Claude Code、GitHub Copilot CLI。opencode 不在官方列表里,但兼容性验证后发现:完美适配。
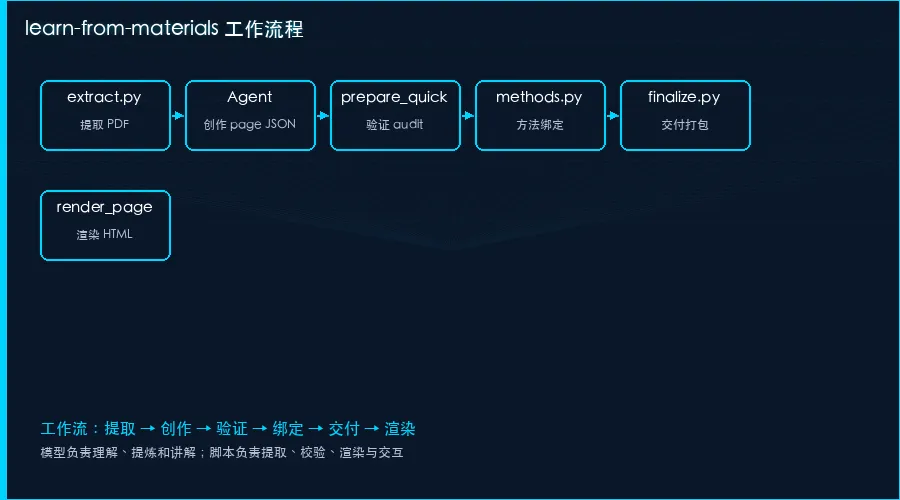
learn-from-materials 工作流程
● ● ●
兼容性评估:能集成吗
集成前先做教研评估,核心问题是:opencode 的 skill 机制能不能兼容 learn-from-materials?
opencode 的 skill 发现机制很直接:扫描 ~/.config/opencode/skills/ 目录下的 SKILL.md 文件,解析 frontmatter 里的 name 和 description 字段。learn-from-materials 的 SKILL.md 有完整的 frontmatter(name + description + metadata),格式完全兼容。
再看依赖:learn-from-materials 用 Python 3.10+,核心脚本 extract.py 依赖 macOS 自带的 PDFKit(可读 PDF 文字层),finalize.py 和 render_page.py 是纯 Python 标准库。不需要额外安装 Node.js 或 Playwright(那是可选的浏览器验证功能)。
最后看工作流兼容性:learn-from-materials 的工作流是 extract.py 提取 → Agent 创作内容 → prepare_quick.py 验证 → methods/methodology 绑定 → finalize.py 交付 → render_page.py 渲染。opencode 的 Agent 可以直接调用这些脚本,中间的内容创作环节由 Agent 完成。整个流程跟 opencode 的"工具+Agent"模型完全契合。
结论:可以集成,兼容性没有障碍。
● ● ●
集成步骤:从安装到交付
1. 安装 Skill
把 learn-from-materials clone 到 opencode 的 skills 目录:
cd ~/.config/opencode/skills/ git clone https://github.com/dmoshehun-prog/learn-from-materials.git安装完成。opencode 会自动发现这个 skill(重启 opencode 后生效)。目录结构包含 36 个脚本、19 个参考文档、SKILL.md 入口文件(48KB)。
2. 提取材料
用 extract.py 提取 PDF:
python3 scripts/extract.py \ /path/to/introduction-terraform-book.pdf \ --mode text --ocr auto \ --output-dir terraform-intro.learnkb17 秒完成。输出一个知识库目录 terraform-intro.learnkb/,包含:
- ●
full_text.md:18322 行完整文本 - ●
full_text.txt:纯文本版(41017 词,约 135K tokens) - ●
source_map.json:331 个 source_id(每页一个),含起止字符位置 - ●
metadata.json:材料元数据
这一步的关键产出是 source_map.json——后续所有内容创作都必须引用这些 source_id,确保知识可追溯。
3. 创作内容 JSON
这一步由 Agent 完成。Agent 读取提取的知识库,创作一个符合 schema 4.3 的 page JSON,包含 8 个模块:
- ●meta
:元信息(语言、schema 版本) - ●hero
:引导页(向导名称、欢迎语) - ●frameworks
:4 个学习框架(IaC 概念、Provider 机制、状态管理、工作流) - ●contentUnits
:5 个内容单元(每个对应一章) - ●glossary
:10 个术语卡 - ●decisionRules
:4 条决策规则 - ●relationships
:5 条关系图 - ●assessment
:3 道自检题
创作过程经历了 4 轮 schema 修复,主要约束:
- ●
glossary 的 category 字段必须是枚举值 - ●
sourceOrder 必须是连续编号 - ●
source 格式为"第X章《章节标题》· PDF第NNN页" - ●
glossary 必须按 firstUnitId 排序
最终产出 29.1KB 的 terraform-page.json。
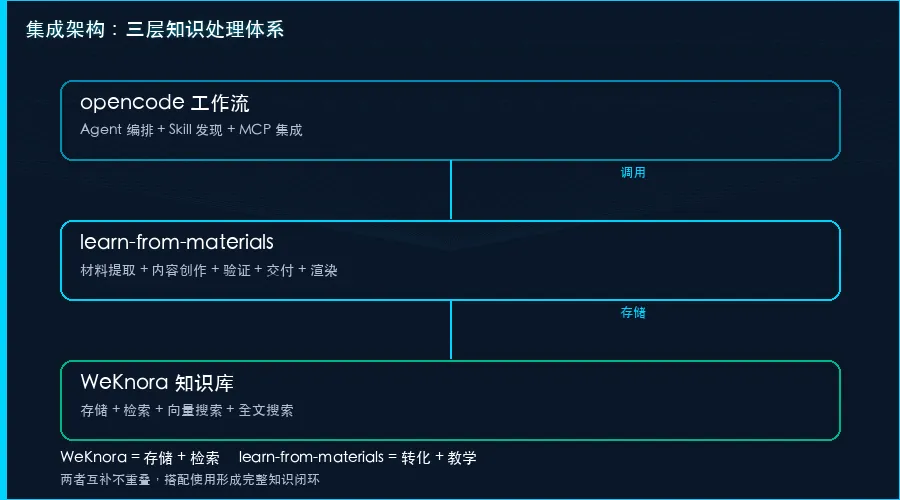
集成架构:opencode + learn-from-materials + WeKnora
4. 验证 quick-audit
quick-audit.json 是一个审计文件,确保内容 JSON 的每个知识点都能追溯到原文。验证规则有三条:
规则一:structure 必须覆盖 source_map 中所有 331 个 source_id——不是只覆盖 page JSON 引用的那些,而是全部。这意味着如果你提取了 331 页材料,审计文件必须为每一页分配到某个章节分组里。
规则二:evidence 中的 quote 字段必须是原文的精确子串。具体来说,quote 的内容必须等于 text[start_char:end_char] 的结果——不能用正则处理空白字符,不能做任何转换。这一条卡得很严,调试了多轮才通过。
规则三:evidence 中引用的 source 集合,必须等于从 page JSON 中递归收集的所有 source 字段(collect_sources 函数的结果)。换句话说,审计文件不能多引用也不能少引用。
最终 quick-audit.json 覆盖 8 个章节分组、331 个 sourceId、14 条 evidence,验证通过。
5. methods + methodology 绑定
learn-from-materials 有两个可选模块:methods(方法卡库)和 methodology(整体方法论结构)。对于技术入门书籍,这两个模块可以用最简占位:
- ●
methods.json: status: "none",methods 数组为空 - ●
methodology.json: status: "not-applicable",structure 为 "none",coverage 中所有 contentUnit 标记为 "context"
绑定命令:
# methods 绑定 python3 scripts/methods.py bind \ --library terraform-intro.learnkb/methods.json \ --knowledge-base terraform-intro.learnkb \ --page terraform-page.json \ --output terraform-page-with-methods.json --replace # methodology 绑定 python3 scripts/methodology.py bind \ --model terraform-intro.learnkb/methodology.json \ --page terraform-page-with-methods.json \ --knowledge-base terraform-intro.learnkb \ --output terraform-page-final.json --replace两步绑定都通过验证。
6. finalize.py 交付
python3 scripts/finalize.py \ terraform-page-final.json \ --knowledge-base terraform-intro.learnkb \ --output-dir delivery \ --name learning-terraform交付产出 6 个文件:
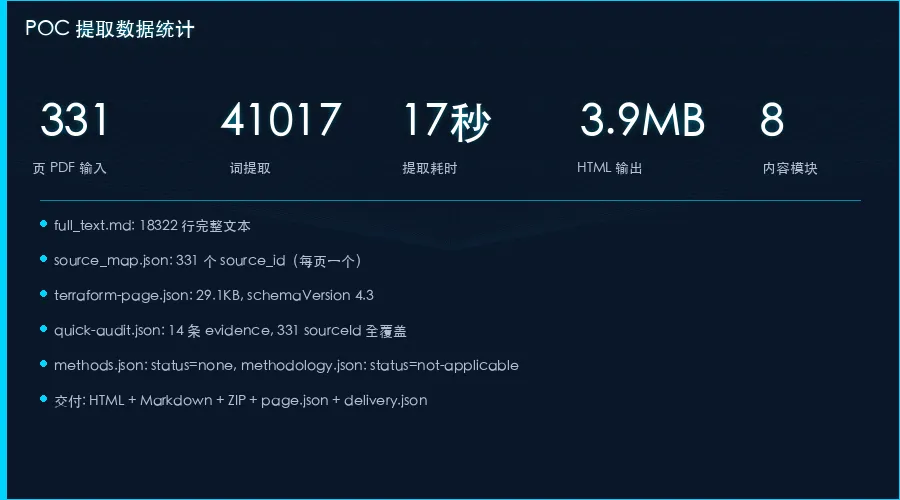
POC 提取数据统计
● ● ●
效果展示
打开 learning-terraform.html,看到一个现代卡片式布局的学习网页:
- ●引导页
:毛玻璃背景,"小巴"向导介绍 6 大功能 - ●6 大功能模块
: - ●
换一种阅读氛围(三套主题切换) - ●
切换学习模块(框架/内容/术语/规则/自检/笔记) - ●
发起动态自检(全部/指定章节/自定义要求) - ●
核对知识出处(查看来源文件和页码) - ●
不懂就问小巴(AI 解释层级:严谨→类比→图片) - ●
保存重点与错题(笔记和错题记录) - ●个性化输入
:职业 + 兴趣,用于定制解释方式
整个页面只有一个 favicon.ico 404 的无关警告,功能完全正常。
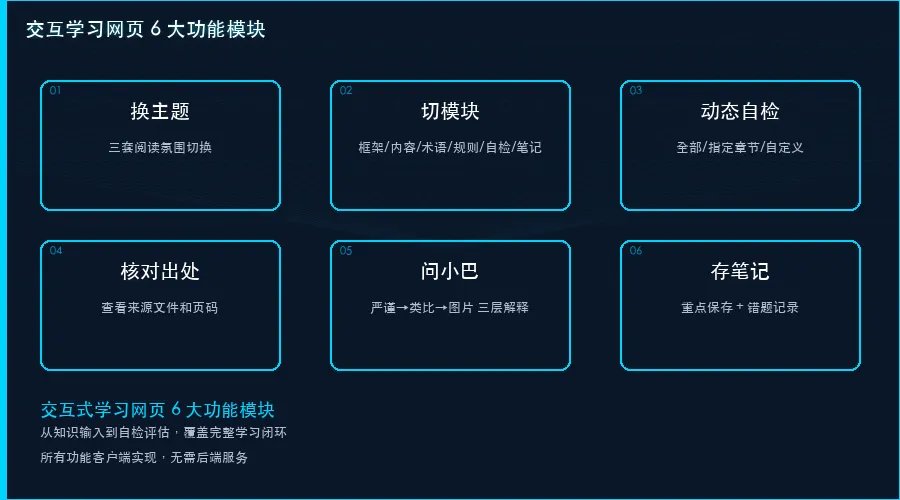
HTML 渲染效果
● ● ●
与 WeKnora 知识库的互补
集成 learn-from-materials 后,opencode 的知识处理能力形成了一个完整闭环:
- ●WeKnora 知识库
:负责存储和检索。所有材料、笔记、决策记录都存到 WeKnora,支持向量搜索和全文搜索。 - ●learn-from-materials
:负责转化和教学。把原始材料变成结构化、可追溯、可交互的学习内容。
两者不重叠:WeKnora 是"存"和"找",learn-from-materials 是"转"和"教"。搭配使用,AI 助手不仅能记住你给它的一切,还能把任何材料变成你可以按自己节奏学习的交互课程。
● ● ●
写在最后
learn-from-materials 的集成过程比预期顺利。最大的卡点在 quick-audit.json 的验证规则——structure 要覆盖全部 source_id、quote 要精确子串、evidence source 集合要完全匹配——这三条规则卡得很严,但也正是这种严格保证了"可追溯"不是一句空话。
如果你也想让 AI 助手学会"读一本书",不妨试试这个工作流。把 skill 装到 opencode skills 目录,丢一本 PDF 进去,17 秒后你就有一个可追溯的知识库和一个交互式学习网页。
关注公众号「AIman」,获取更多 AI 工程实战内容。