ARTICLE · 1125708
重新理解 AI 系列45:AI 说“我记得你”,它到底记住了什么?
副标题:从写入、读取到更新与遗忘,理解长期记忆的工程机制
引言
假设你曾经对 AI 说:“以后回答我的问题时,先给结论,再解释依据。”
这次对话结束后,你又开启了一个新会话。AI 仍然把结论放在最前面,甚至告诉你:“我记得你喜欢结论优先的表达方式。”
这种体验很容易让人觉得,它真的像一个熟悉你的助手一样,在脑海里记住了你。
可这条偏好究竟记在哪里?是模型在上一次对话后改变了自己,还是模型之外的系统保存了一条记录,并在这次回答前重新交给了它?
上一篇《重新理解 AI 系列44:中断之后,Agent 为什么还能接着做?》讨论的是任务状态:同一件事做到哪里,中断后怎样继续。本文转向另一种连续性:一项任务结束以后,哪些信息值得跨任务、跨会话保留,并在未来再次使用。
我希望通过这篇文章,和你一起建立一个基本直觉:多数 AI 应用表现出的“记得”,不是模型拥有了连续意识,而是外部系统在管理信息的写入、读取、更新和遗忘。
一、长期记忆,不等于模型产生了连续意识
要理解 AI 为什么会“记得你”,我们先把四种容易混在一起的东西分开。
模型参数承载模型在训练、微调等过程中形成的通用能力和知识。在大多数常见 AI 产品中,一次普通对话不会直接改写参数。你说“我喜欢结论优先”,通常不等于模型被重新训练了一遍。
当前 Context是这一次模型调用实际收到的输入,可能包含用户问题、系统规则、近期对话、检索资料,以及系统选出的记忆。
Task State回答的是“当前这件事做到哪里了”,例如会议已经创建,但会议室尚未预订。
外部长期记忆则是应用在模型之外保存、未来可能重新取回的信息,例如用户偏好、项目规则、稳定事实和可复用经验。
它们并不是互相隔离的。任务状态和长期记忆都可能经过筛选,进入当前 Context。但三者解决的问题不同:Context 是这一轮看见什么,State 是当前任务进行到哪里,长期 Memory 是哪些信息值得跨任务保留。
这也不是一份全行业统一的术语表。有些框架会把会话内可持久化的状态也称为“短期记忆”。本文把它们分开,是为了先看清各自解决的问题。
CoALA 将语言 Agent 描述为包含模块化记忆、动作与决策循环的认知架构;MemGPT 则借鉴分层内存,在有限上下文和外部存储之间移动信息。实现虽然不同,但都说明:模型当前能“想起”什么,往往取决于外部系统怎样组织和重新提供信息。
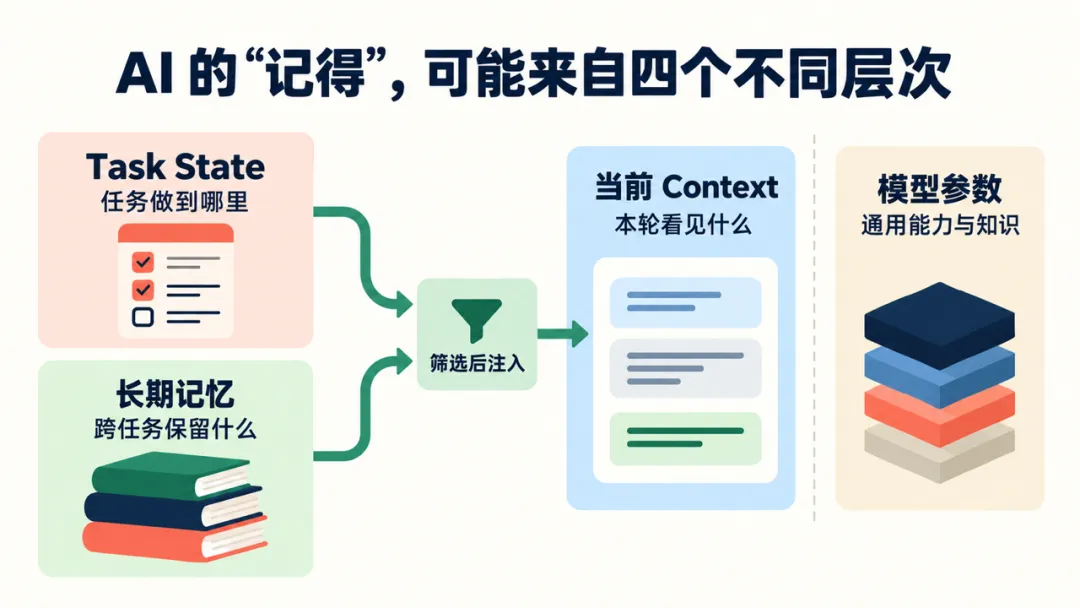
图注:Task State 和长期记忆可以经过筛选进入当前 Context;模型参数承载的是底层通用能力,不能与一次对话中的外部记忆混为一谈。
二、不是所有信息,都值得被记住
知道记忆在模型之外,还只是第一步。更困难的问题是:系统到底应该记什么?
值得长期保留的信息,大致可以分成几类:用户偏好,例如语言和回答风格;经过确认的稳定事实;项目术语、约束和固定决策;以及能在多个任务中复用的方法与教训。
它们的共同点是:不只对眼前这一步有用,未来在相似场景中仍可能产生价值。
反过来,临时任务数据、模型未经确认的推测、很快失效的状态,以及没有明确必要性和权限基础的敏感信息,都不应该轻易进入长期记忆。
所以,记忆写入本身就是一次判断。系统不仅要问“以后可能有用吗”,还要问“它可靠吗”“对谁生效”“保存它是否得到允许”。
写入太少,AI 每次都像第一次见你;写入太多,它又会带着大量陈旧、重复甚至不该保存的信息到处走。长期记忆的第一项能力,不是存储,而是克制。
三、一条记忆,是怎样写进去的
还是回到“结论优先”的例子。
最清楚的写入方式,是用户明确说:“请记住,以后先给我结论。”系统据此保存一条偏好。
系统也可能从对话中提取候选记忆。例如用户连续多次要求缩短回答,系统推测他偏好简洁表达。但“推测”不等于“事实”。更稳妥的做法,是请用户确认,或者至少给它标注较低的可信程度,而不是悄悄把它变成永久规则。
还有一些记忆来自项目或组织,例如统一术语、代码规范和安全边界。它们通常具有更明确的来源和适用范围。
因此,一条可治理的记忆不能只有一句文本。它还需要说明:来自用户确认、项目文件还是系统推断;只对某个用户、项目还是组织生效;何时写入和更新;可信程度如何;谁可以读取、修改和删除。
这不是要求所有系统照抄一套固定字段,而是说明:没有来源、范围、时间和权限的记忆,很难被可靠使用。
四、记忆又是怎样被“想起来”的
信息保存下来,并不意味着每次都要把全部记忆塞给模型。
如果系统把用户多年的偏好、项目和任务记录全部加载,Context 很快就会被无关信息填满。模型看到得更多,也不代表更容易抓住当前重点。
一种常见的工程做法是按需读取:先根据当前用户、项目和任务限定范围;在权限允许的记忆中寻找相关信息;再结合相关性、时间、来源和可信程度筛选;最后把少量必要内容整理后放进当前 Context。
Generative Agents 的经典研究把经历记录为自然语言,再动态检索相关记忆、形成反思并支持后续规划。Anthropic 的 Context Engineering 实践也提到,Agent 可以把笔记保存在上下文窗口之外,需要时再取回。
因此,AI 表现出的“想起”,更像一次检索和重注入:系统找到“这个用户偏好结论优先”,把它放入当前工作集,模型才据此组织回答。
这也连接了第 42 篇:记忆系统负责保存并找出候选信息,Context Engineering 决定哪些内容最终进入模型这一轮有限的注意力空间。
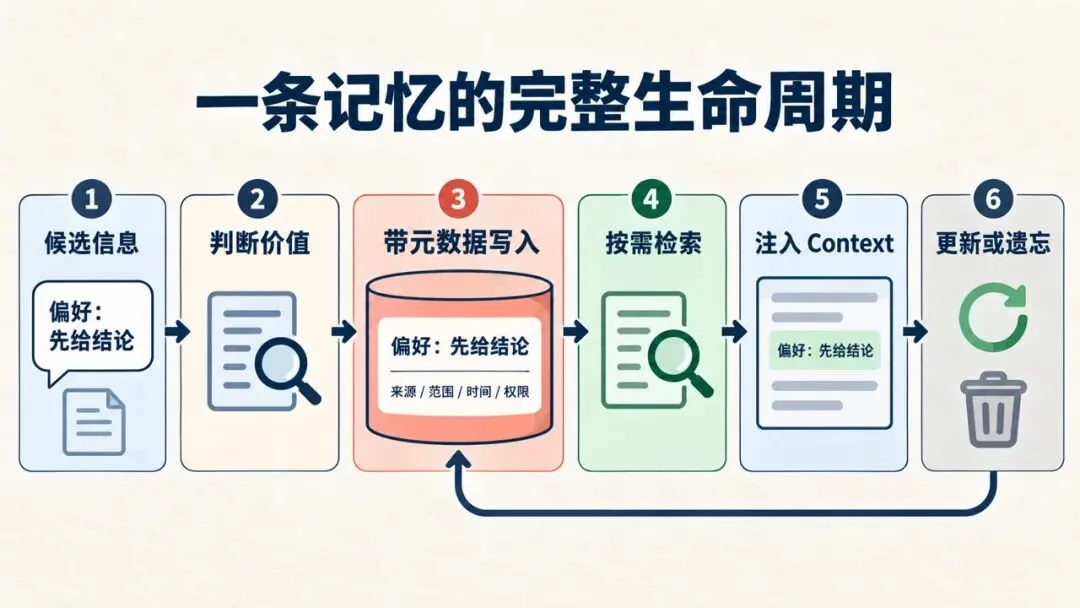
图注:长期记忆不是把对话原样存下来,而是经历价值判断、带元数据写入、按需检索、重新注入,以及后续更新或遗忘。
五、记忆为什么必须能够更新和遗忘
现在,让开头的例子发生一点变化。
用户后来发现,简单问题结论优先很好,但复杂技术问题如果太早给结论,容易跳过关键分析。于是他说:“日常问题继续简洁,技术问题先完整分析。”
如果记忆系统只会追加,就会同时保留两条互相冲突的规则。下一次该听谁的,只能让模型现场猜。
因此,可靠的长期记忆通常还要处理变化:新信息出现时更新旧信息;发生冲突时识别当前有效版本;为有时效的信息设置复核或过期时间;保留必要的变更记录;允许用户查看、更正和删除;清理长期无用或风险过高的内容。
这里最容易被忽略的是“遗忘”。我们常把记得更多理解为能力更强,但一个从不遗忘的系统,也可能变成堆满过期资料的仓库。
遗忘不是记忆系统的失败,而是它保持准确、克制和可控的必要能力。
六、记得越多,为什么不一定越聪明
如果记忆缺少治理,它带来的不只是“偶尔答错”。
一次未经确认的推测被长期保存,可能在未来反复影响回答;早已变化的事实可能继续误导判断;某个项目的信息被带到另一个项目,会造成权限越界;太多无关记忆进入 Context,也会占用有限的注意力。
它还可能带来一种更隐蔽的问题:过度迎合。
如果系统不断强化用户过去的偏好和观点,却忽略变化、反例和不确定性,它可能越来越“懂你”,也越来越不愿意挑战你。长期记忆原本是为了提供连续性,最后却可能把一个人锁在过去的表达和判断里。
所以,好的记忆系统不仅要让 AI 记得,还要让用户知道它记了什么、为什么使用,以及怎样更正或删除。记忆越能影响未来行为,就越需要来源、边界和责任。
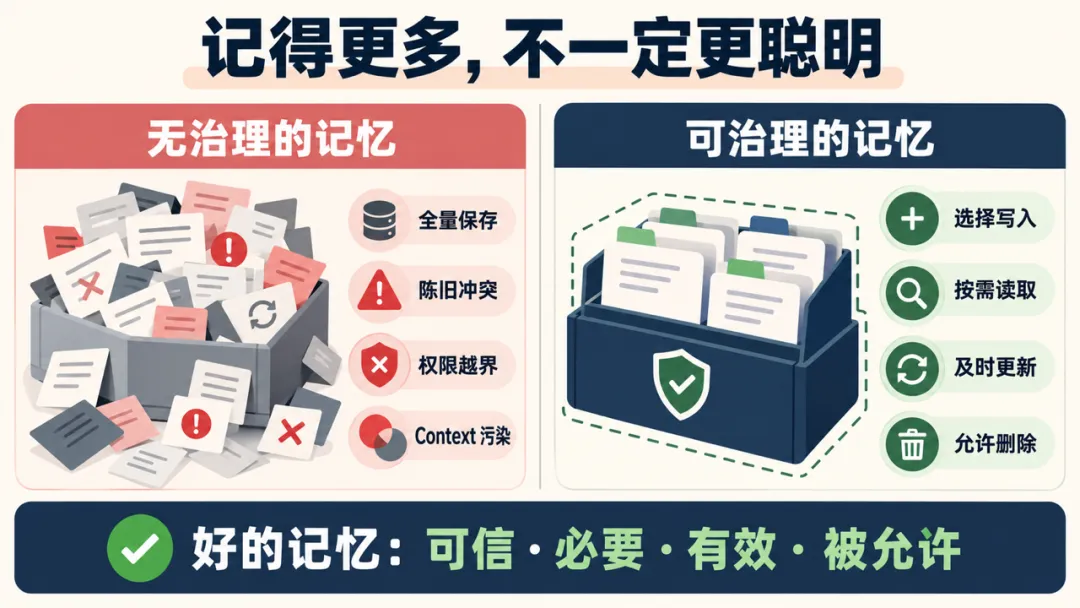
图注:可靠性来自选择、时效、作用域和用户控制。全量保存并不会自动让 AI 更聪明,反而可能制造冲突、越权和 Context 污染。
七、好的长期记忆,至少要回答六个问题
讲到这里,我们可以把长期记忆的工程要求收束成六个问题。这不是一份行业统一标准,而是本文基于前文机制归纳出的一张实用检查表:
1. 为什么要记? 它未来会在哪类任务中产生价值? 2. 到底记了什么? 内容是否明确、最小,没有夹带未经确认的推断? 3. 从哪里来? 用户确认、项目规则和模型推测能否区分? 4. 对谁生效? 用户、项目和组织的范围是否清楚? 5. 什么时候失效? 是否需要更新、复核或者过期? 6. 谁能控制? 谁可以读取、更正和删除?
如果这些问题都答不出来,所谓“记忆能力”就可能只是一种展示效果:看起来很贴心,却不一定准确,也不一定安全。
结语:好的记忆,不是记住一切
在本文中,我们讨论了 AI 为什么会表现得像“记住了你”。
在大多数常见应用中,这种连续性不是模型在每次对话后产生了新的个人记忆,而是外部系统选择性地保存信息,在未来任务中检索出来,再通过 Context 交给模型。
真正困难的,不是存下更多内容,而是持续判断:什么值得写入,什么时候应该读取,旧信息何时需要更新,哪些内容应该被遗忘,以及谁有权决定这一切。
好的 AI 记忆,不是保存得最多,而是在正确的范围内,使用可信、必要、仍然有效且被允许的信息。
参考资料
• Theodore R. Sumers, Shunyu Yao, Karthik Narasimhan, Thomas L. Griffiths, Cognitive Architectures for Language Agents. • Charles Packer et al., MemGPT: Towards LLMs as Operating Systems. • Joon Sung Park et al., Generative Agents: Interactive Simulacra of Human Behavior. • Anthropic, Effective context engineering for AI agents.