ARTICLE · 1127223
别再只给 AI 喂文档了:一文讲透什么是"本体"(Ontology)
大模型不是不够聪明,而是缺一张"人和机器共用的事实地图"
大促零点刚过,订单支付链路突然报错。
技术团队一头扎进上百个微服务里排查。商品、库存、优惠券、订单、物流、对账,日志刷得像瀑布,可就是定位不到是哪一环出了问题。翻内部 Wiki,最后更新时间停在十个月前。打电话问供应商:"当年那个优惠券能不能和满减叠加的逻辑,为什么那么写?"对面沉默了半天,也没给出确定的答复。
最后没办法,只能先外挂一个补丁把故障压下去。问题暂时解决了,隐患还埋在那儿。
这个场景,是我在跟一家零售电商企业聊方案时听得最有共鸣的一段。他们线上商城、门店、小程序、直播带货全线覆盖,系统跑了好几年,微服务架构、上百个代码仓库、分散在好几个团队手里。他们特别想建一个系统知识库,可试过之后发现:传统的 RAG,解决不了这个问题。
为什么?这就要聊到今天的主角,本体(Ontology)。
一、真正的瓶颈,不是"没文档"
表面上,问题是"文档没人写"。拆开看,其实是三个"没人知道":
知识在人脑里。关键设计决策只有当年那几个工程师清楚,人一走,上下文直接清零。 知识在代码里。业务规则埋在几千个 if-else 深处,谁都不敢动。 知识在接口里。几百条调用链,改一个字段,不知道会震塌哪堵墙。
常规解法是"补文档"。但文档有三个死穴:写完就过时、搜索找不到、就算 AI 读了也没法照着行动。
所以真正要建的,不是又一个文档库,而是一套人和 AI 能共用的事实骨架。
传统的知识库,是"给人看的说明书";企业 AI 需要的,是"人和机器共用的地图"。
二、什么是本体?一张"中台地图"就够了
先别被"本体"这个哲学味儿的词吓到。落到工程上,它只做一件事:
把业务世界里的"东西"和"它们之间的关系",用一张显式的地图画出来,让人和 AI 共用。
打个比方。大模型像一个刚入职的天才运营:电商知识满分,学习能力惊人。但他第一天走进这家公司,不知道优惠券能不能和满减叠加,不知道超卖拦截设在哪一道闸,也不知道预售商品几天内必须发货。
这时候你有两种"带教"方式:
裸代码模式。把一摞业务规则和代码原文甩给他,"自己翻吧"。他大概率能答上来,但也可能记错、猜错、好心办坏事。 本体模式。先给他一张中台地图:有哪些业务对象、彼此怎么流转、每个字段从哪张表来、有哪些红线不能碰、哪些操作必须审批、每个真实订单现在在哪。
本体就是那张地图。模型还是同一个模型,但它不再靠猜,而是沿着结构走。 目的很明确:控制语义理解,减少幻觉,增加确定性。
这张地图上到底有什么?我们把它拆成六个要素,叫"本体六大件"。
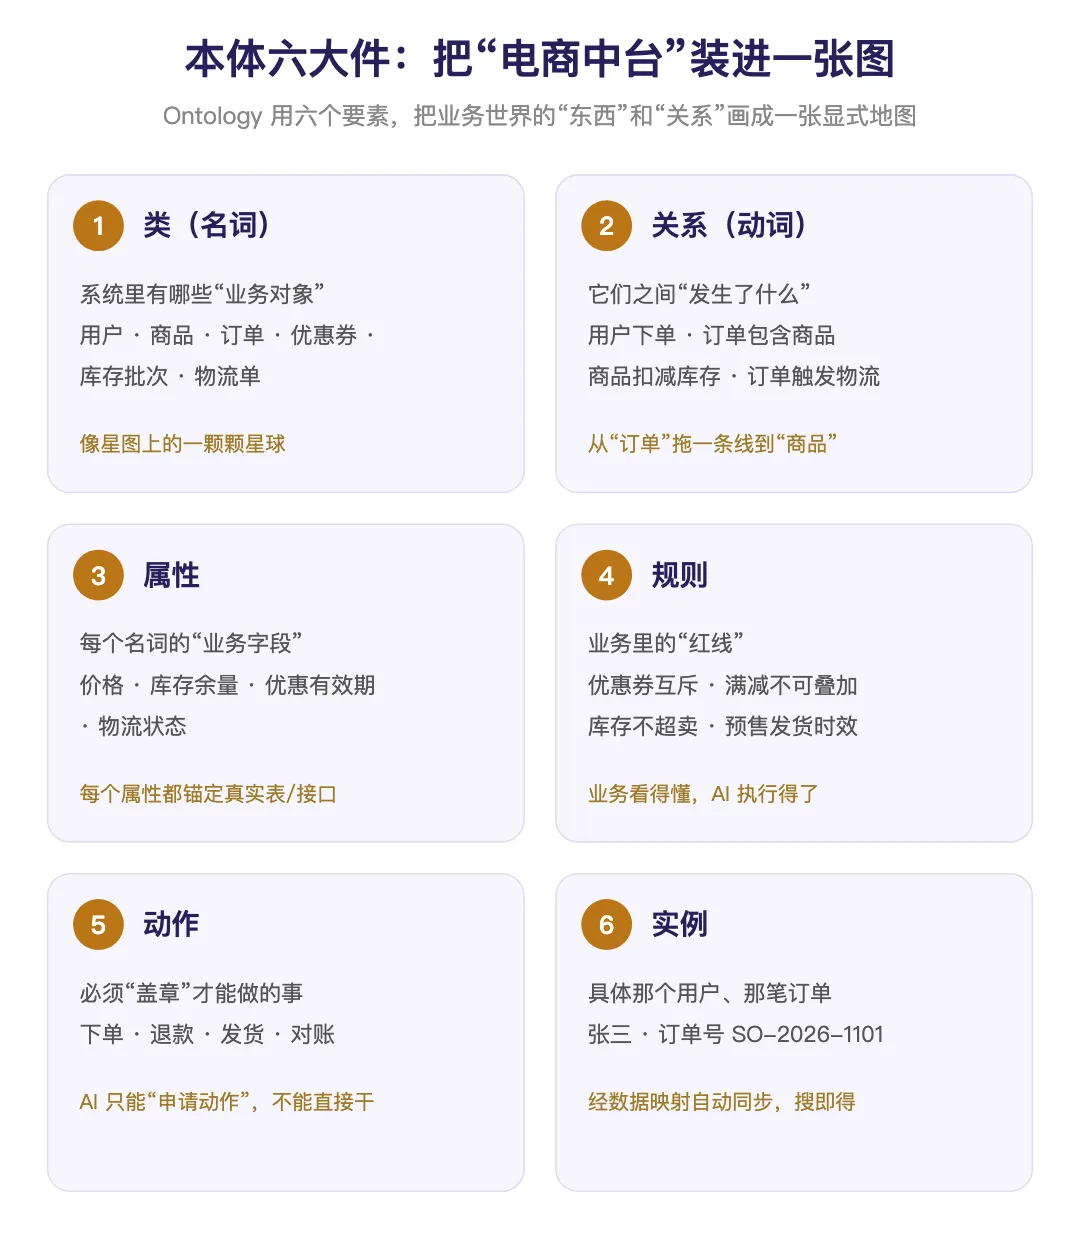
图 1 · 本体六大件:类、关系、属性、规则、动作、实例
三、六大件:把"电商中台"装进一张图
- 类,也就是"名词"。
用户、商品、订单、优惠券、库存批次、物流单……每个类填上名称、编码、中文释义,就像星图上一颗颗星球。 - 关系,也就是"动词"。
用户下单,订单包含商品,商品扣减库存,订单触发物流。在图上就是从"订单"拖一条线到"商品",标好关系类型和基数(一张订单 1:N 种商品)。 - 属性。
每个名词都有自己的"业务字段":商品有价格、库存余量,优惠券有优惠有效期、门槛,物流单有状态。关键在于,每个属性都锚定到具体是哪张表、哪个接口,点一下"库存余量",能看到它来自哪个服务的哪个字段,可以回源核对。知识不再是"据说",而是"有凭据"。 - 规则,也就是业务里的"红线"。
比如"优惠券和满减互斥,不可叠加""库存不超卖,超卖即拦截""预售商品须在规定时效内发货"。规则在界面上像填表单一样配置,业务人员看得懂,架构师审得过,AI 也执行得了。 - 动作,必须"盖章"才能做的事。
下单、退款、发货、对账……这是本体最特别的一件:动作不是查询,而是会改变系统状态的操作。每个动作绑定真实的代码入口,还必须声明前置条件、影响面和回滚方式。 - 实例,具体那个用户、那笔订单。
用户"张三"、订单号 SO-2026-1101、某批库存批次。实例不用手工录入,本体通过数据映射锚定真实数据源,自动同步。
这六件凑齐了,业务世界才算真正被"装进"了一张图。
四、它和"把代码注释整理成 Wiki"到底差在哪
这是最容易混淆的地方。本体看起来也像一套文档,但有三处本质不同。
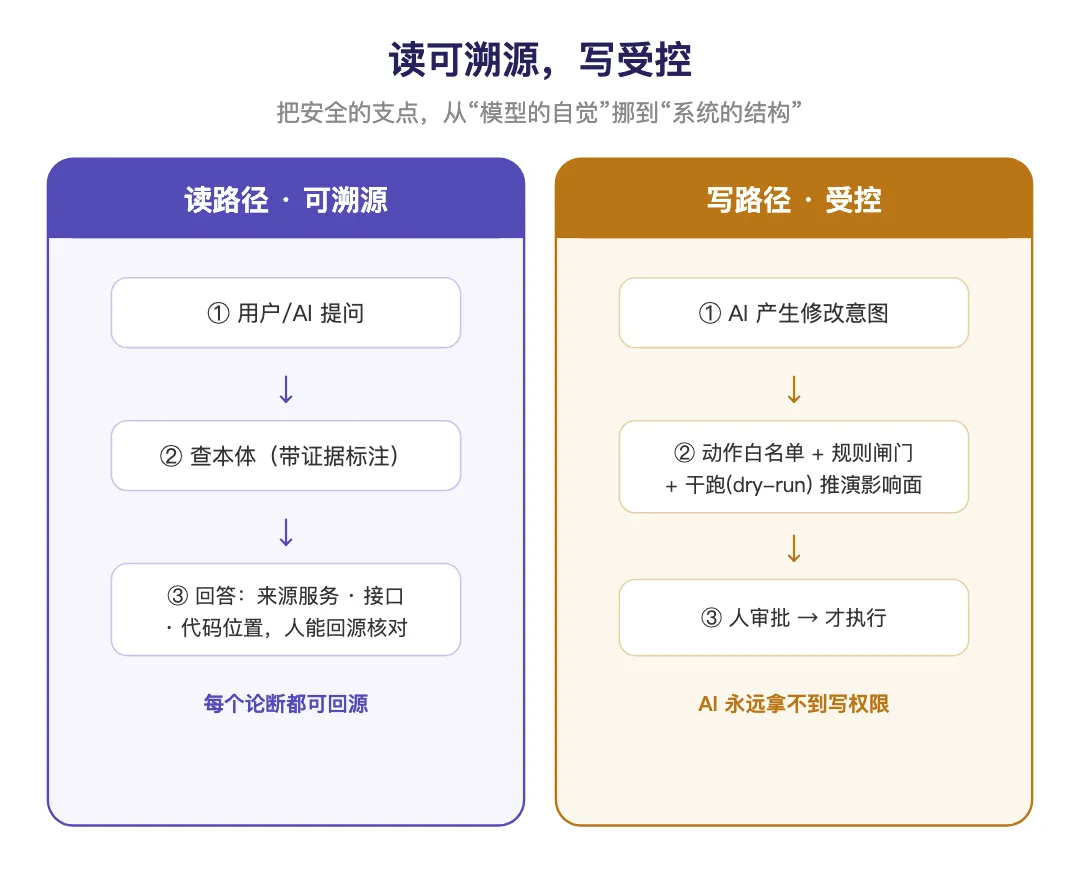
图 2 · 读路径可溯源,写路径受控
1. 锚定的不是"数据库表",而是"代码资产"。
传统本体把"类"映射到表和列;在代码知识库里,我们把它映射到服务、接口、函数、消息 Topic:
- 名词"订单" → order-service 的 createOrder 接口
- 动词"下单" → 上面这个接口,加上事件 topic "order.created"
- 动作"退款" → order-service 的 refund 接口,加回滚补偿逻辑
于是 AI 查"订单是怎么创建的",拿到的是一个语义入口,顺着入口就能拿到契约、代码摘要、调用方清单,而不是在上百个仓库里做全文检索。
2. 读路径可溯源,写路径受控。
读的时候,AI 的每个论断都带"证据标注"(来源服务、接口、代码位置),人能回源核对。写的时候,AI 的任何修改意图都必须过三关:动作白名单、规则闸门、干跑(dry-run)。比如它想调整"退款"逻辑,先走一遍干跑,系统推演出这次变更会触碰哪些调用方、哪几条业务规则,生成报告交给人审批。
把安全的支点,从"模型的自觉",挪到"系统的结构"。
3. 人看的和 AI 用的是同一份。
不维护两套。星图对人就是架构导航图,对 AI 就是工具调用清单;规则对人就是业务红线,对 AI 就是闸门。文档也不会再"写完就过时",因为本体和代码之间是映射关系,代码一变,校验就会报警。
五、最容易被忽视、却最致命的一环:版本管理
本体本身也是资产,必须版本化。我们把它当"语义契约"来管,规格跟代码一个待遇。
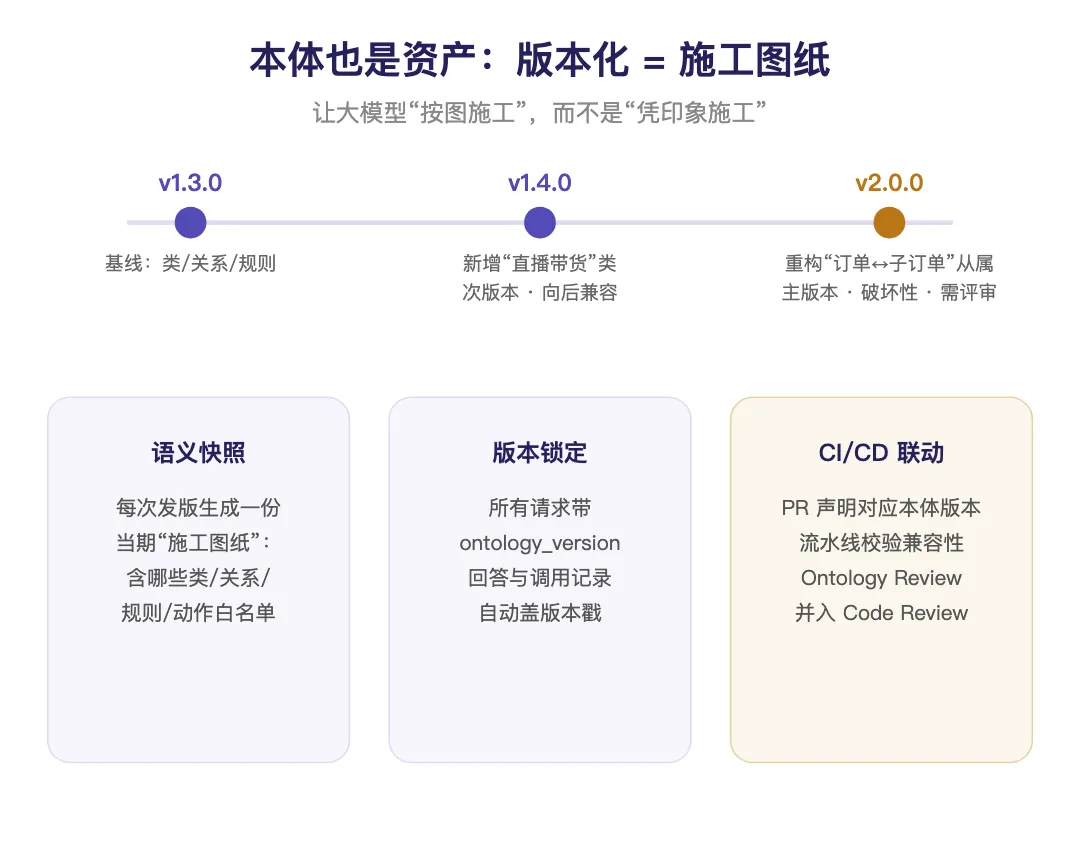
图 3 ·把本体当语义契约,版本化、可审计、与 CI/CD 联动
- 语义化版本。
v1.3.0 到 v1.4.0 新增一个类,是向后兼容的次版本;v2.0.0 重构了类之间的从属关系,是破坏性变更,必须走迁移评审。 - 每次发版生成"语义快照"。
这个版本包含哪些类、关系、规则、动作白名单,相当于给大模型一张当期施工图纸。 - 模型调用锁定版本。
AI 的所有请求都必须带 ontology_version 参数,回答和调用记录自动盖版本戳。三个月后审计"AI 当时为什么这么答",能精确还原它看到的是哪张图,不会出现"模型按老规矩答新业务"的灵异事件。 - 与 CI/CD 联动。
代码 PR 里声明对应的本体版本,部署流水线校验兼容性。服务还在用旧契约调用已被重构的动作,流水线直接拦住。本体评审和代码评审,合并成同一张单子。
让大模型"按图施工",而不是"凭印象施工"。
写在最后
回到最初那个大促报错的场景。如果这家电商真的有了这张"地图",那个问题可能根本不需要打补丁。AI 顺着本体查到"支付对账"这条链路,带着证据告诉工程师:规则在哪个服务的哪个函数、会波及哪些调用方、改动要不要走审批。人一看,就知道该动哪、不该动哪。
本体不是什么新概念,它更接近一种把隐性知识显性化的老办法。只是到了大模型时代,这份"显性化"第一次有了第二个读者,AI。而企业 AI 能不能真正落地,很多时候就差这一步:不是给模型喂更多数据,而是给它一张结构清晰、可溯源、可受控的地图。
一句话收尾:AI 的可靠性,从来不是靠模型更自觉,而是靠系统更结构化。
如果你也在做企业 AI 落地,尤其是知识库、智能体这条线,欢迎留言聊聊你的坑。