ARTICLE · 1127584
MetaApp 前端 AI 面
一、这场 AI 面试是怎么考的
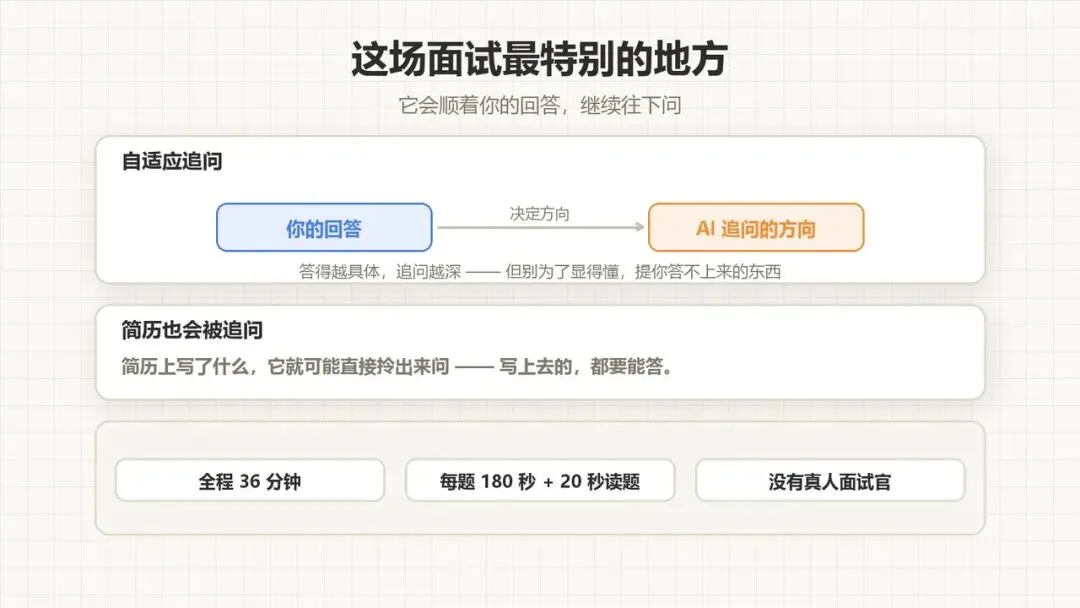
用的是北森的 AI 面试系统,有几个硬性设定值得提前知道:
▪︎ 总时长 36 分钟,没有真人面试官,全程录像录音
▪︎ 每道题 180 秒作答,另有 20 秒读题时间
▪︎ 自适应出题:AI 会根据你前面的回答调整后面的方向
▪︎ 简历会被追问:除了系统里的题,还会针对简历上的内容提问
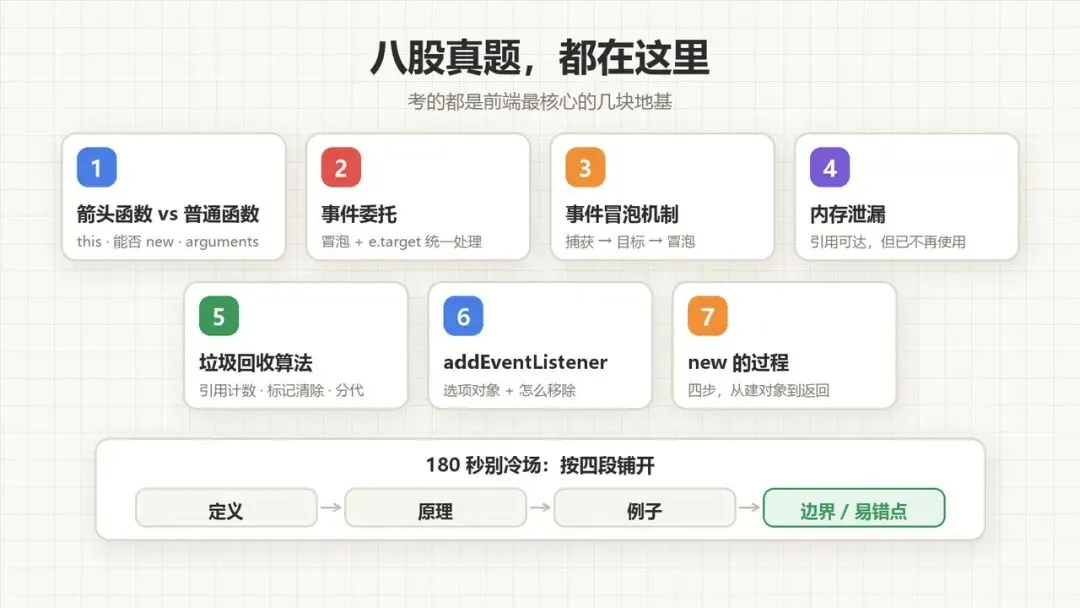
二、八股真题 + 答题要点
下面是这次考到的题,以及每题我整理的答题要点。
2.1 箭头函数和普通函数的区别
核心差异是四件事:
▪︎ this:箭头函数没有自己的 this,它在定义时就捕获外层作用域的 this,而且用 call / apply / bind 也改不了;普通函数的 this 由调用方式决定(默认绑定、隐式绑定、显式绑定、new 绑定)。
▪︎ 能不能 new:箭头函数没有 [[Construct]],当构造函数用会直接报错,它也没有 prototype 属性。
▪︎ arguments:箭头函数没有自己的 arguments,要用 rest 参数代替。
▪︎ 其他:箭头函数不能做 Generator(不能用 yield),也没有自己的 super 和 new.target。
适用场景:回调、需要在回调里保留外层 this 的地方(比如 setTimeout、数组方法)。
不适用的场景:对象的方法(this 不会指向这个对象)、需要动态 this 的场景、构造函数、原型方法。
加分点:箭头函数的 this 是“词法”决定的,跟运行时无关——所以就算你 bind 它,也改不了。
2.2 什么是事件委托,有什么好处
定义:不把监听器绑到每个子元素上,而是绑在它们的父元素上,利用事件冒泡,在父元素里统一处理,再用 event.target 判断到底是哪个子元素触发的。
三个好处:
▪︎ 省内存、少监听器:一个长列表如果每个 li 都绑一次,就是几百个监听器;委托只需要一个。
▪︎ 动态元素自动生效:后面新增的子元素不用重新绑定。
▪︎ 逻辑集中:所有相关处理都在一处,好维护。
要注意的边界:不是所有事件都冒泡(focus / blur 不冒泡,得用 focusin / focusout);event.target 可能是很深的子节点,通常要配 closest() 找真正的目标;如果你在子元素里阻止了冒泡,委托就失效了。
2.3 讲讲浏览器的事件冒泡机制
事件流分三个阶段:捕获 → 目标 → 冒泡。
捕获阶段:从 window / document 一路往下传到目标元素; 目标阶段:事件到达目标元素; 冒泡阶段:从目标元素一路往上回到 document / window。
addEventListener 的第三个参数决定了你在哪个阶段监听:true 或 {capture: true} 是在捕获阶段。
三个容易混的 API,一定要分清:
▪︎ stopPropagation():阻止事件继续传播(捕获和冒泡都会被截断);
▪︎ stopImmediatePropagation():连当前元素上后注册的监听器也一起阻止;
▪︎ preventDefault():阻止的是默认行为,跟传播没关系,两者不要混。
两个容易混的属性:event.target 是实际触发事件的元素,event.currentTarget 是当前监听器绑定的元素(非箭头函数里 this 就等于它)。
不冒泡的事件:focus、blur、mouseenter、mouseleave、load 等;其中 focus / blur 可以用 focusin / focusout 替代。
2.4 什么是内存泄漏,什么情况下会造成内存泄漏
定义:对象已经不再被使用了,但因为还有引用能到达它(可达),垃圾回收器不敢回收,这块内存就一直占着。
常见成因(按出现频率排):
▪︎ 意外的全局变量:忘记声明就赋值,或者 this 指向了 window;
▪︎ 没清掉的定时器:setInterval 一直在跑,回调里又引用着大对象;
▪︎ 没解绑的事件监听:尤其是绑在 window / document 上的,组件卸载了没 removeEventListener;React 里就是 useEffect 没写清理函数;
▪︎ 闭包持有大对象:闭包把外层的变量一直留住;
▪︎ DOM 引用泄漏:节点已经从页面移除了,但 JS 里还留着引用(detached DOM),反过来也成立;
▪︎ 缓存只进不出:用 Map 或数组当缓存,没有淘汰策略;
▪︎ 没取消的订阅:WebSocket、EventBus、没取消的请求。
怎么定位:Chrome DevTools 的 Memory 面板做堆快照对比,看两次快照间“该消失却没消失”的对象;也可以开 Performance monitor 看内存曲线是不是一路往上不回落。
2.5 垃圾回收机制的算法有哪些
引用计数:记录每个对象被引用的次数,归零就回收。致命缺陷是循环引用——两个对象互相引用,计数永远不为零,就漏了。这是 IE 时代内存泄漏的经典来源,现在基本不用它了。
标记-清除:从根(全局对象、调用栈)出发,把所有能到达的对象标记出来,没被标记的就是垃圾,清掉。它解决了循环引用问题,是现在的主流思路(V8 就用这个思路)。
标记-整理:标记完之后,把存活对象往一端挪紧,清掉碎片——解决标记-清除留下的内存碎片问题。
分代回收:按对象活得久不久分成新生代和老生代,用不同策略:
▪︎ 新生代用 Scavenge(Cheney 算法):把空间分成 from / to 两块,存活对象复制到 to,然后交换;活得够久的那批会被“晋升”到老生代;
▪︎ 老生代用标记-清除 / 标记-整理,配合增量标记把一次长停顿拆成多次短停顿,避免卡顿。
一个容易被忽略的点:JS 的 GC 是非确定性的,你没法精确知道它什么时候回收;想让某个引用“不阻止回收”,就用 WeakMap / WeakSet。
2.6 讲一讲 addEventListener
基本语法:target.addEventListener(type, listener, options),第三个参数既可以是布尔值(是否捕获),也可以是一个选项对象。
选项对象里最实用的三个:
▪︎ capture:在捕获阶段监听;
▪︎ once: true:触发一次后自动移除,省掉手动解绑;
▪︎ passive: true:承诺回调里不会调用 preventDefault(),浏览器就能立刻滚动,在 touchmove / wheel 这类高频事件里对滚动性能提升很明显。
和 onclick 的区别:onclick 一个元素只能绑一个(后写的覆盖前面的);addEventListener 可以绑多个,按注册顺序执行,而且能选捕获还是冒泡。
移除时的坑:removeEventListener 必须传同一个函数引用、并且 capture 选项要一致,所以匿名函数是移除不掉的——这也是为什么回调最好具名或者存起来。
加分点:可以用 AbortSignal 一次性移除一批监听器——把 { signal: controller.signal } 传进去,之后 controller.abort() 就能全部解绑。
2.7 new 经过了哪些过程操作
四步:
▪︎ 建对象:创建一个新对象,并把它和构造函数的 prototype 关联起来(原型指向它);
▪︎ 绑 this:让构造函数里的 this 指向这个新对象;
▪︎ 执行:跑构造函数里的代码,给 this 加属性;
▪︎ 返回:如果构造函数显式返回了一个对象,就返回那个对象;否则忽略返回值,返回这个新对象(返回原始值会被忽略)。
手写实现就三句话:Object.create(Ctor.prototype) 建对象 → Ctor.apply(obj, args) 执行构造函数 → 判断返回值是不是对象,是就返回它,否则返回 obj。
加分点:箭头函数不能被 new,因为它没有 [[Construct]];另外 prototype 上的 constructor 属性会指回构造函数本身。
三、行为题
3.1 近两三年,说说超越自我的一件事,过程怎么样,到达什么效果
这道题的判分点其实是“超越”两个字,所以选材比表达更重要:▪︎ 起点要低:得先讲清楚“原来的我会到哪、原来的预期是什么”,后面的超越才成立;▪︎ 要有难点和转折:一路顺风顺水的事,撑不起“超越自我”这个题眼;▪︎ 必须有量化结果:没有数字的成果,在面试官眼里约等于平淡;▪︎ 必须有你个人不可替代的动作:别把团队的功劳说成自己的。表达上,我会把“结果”讲成对比:不是“我做到了 X”,而是“原来要 A 时间 / A 方式,现在变成 B”——让超越看得见。
示例:
情境:大二那年,我连一个完整项目都没独立做过,课程作业基本都是跟着教程一步步敲。
目标:学院要做一个“实验室设备预约”的小系统,一直没人接。我把它接了下来,目标是在两周内独立交付一个真能跑、能给人用的系统——对一个没写过真实项目的人来说,这本身就超出预期。
行动:我把两周切成三段——前 3 天啃框架文档和数据库设计,中间 6 天写功能,最后 5 天联调修 bug。中途卡在“同一时段被两个人约走”的并发问题上,我没去找现成答案,而是回头读了一遍官方文档里的锁和事务,最后用乐观锁加唯一索引解决。每天晚上我都把进度和卡点记进一个文档,防止自己跑偏。
结果:系统按期上线,被 3 个实验室、前后约 200 名同学用了一整个学期。后来我把踩过的坑整理成一份部署文档,成了下一届学弟学妹的直接参考。
收尾:从“跟着教程走”到“独立交付一个真被人用的系统”,这是我这两三年里最大的一次跨越。
3.2 说说你大学中遇到的比较深刻的团队协作,你是如何协调不同的人合作,你用了什么方法,最终怎么样
这道题的题眼是“协调”和“方法”,不是“协作”本身。▪︎ 要有冲突:全是顺风顺水的团队,反而拿不到分。分歧、拖延、能力不均是更好的素材;▪︎ 行动部分要给出具体机制:不是“多沟通”,而是“每周一次同步会 + 看板认领 + 分歧用数据投票”这种能复用的做法;▪︎ 说清你的角色:不一定是队长,但要有别人替代不了的贡献;▪︎ 结果之后加一句反思:如果重来会怎么改——这一步很能拉开差距。
示例:
复盘
第一,考的不是偏题,而是地基。箭头函数的 this、事件流三阶段、内存泄漏、GC 算法、new 的过程——这些不是冷门知识,反而是最该背熟的。前端实习的筛选线,就划在“基础扎不扎实”上。
第二,自适应面试要主动“给钩子”。既然它会顺着你的回答追问,那你的每一句回答其实都在为后面出题。主动提你熟的领域,把追问引到你有利的地方;但别为了显得懂而提你答不上来的东西——那等于自己给自己挖坑。
第三,180 秒要练“有结构地铺满”。定义 → 原理 → 例子 → 边界,这套结构不只适用于这场面试,它其实是所有技术口述题的通解。
最后一点:AI 面试没有表情反馈,你永远不知道对面“满不满意”,所以卡壳的时候不要慌,把问题复述一遍、分点作答,比硬撑着沉默好得多。
一句话总结:这场 AI 面试考的不是你会不会聊天,而是你的基础知识能不能在被追问的情况下站得住。