ARTICLE · 1130596
pdf-inspector:先看清 PDF 里有没有字,再决定要不要花钱做 OCR
今天给大家推荐的项目是 pdf-inspector。
它是一个用 Rust 写成的 PDF 解析工具:把自带文字层的 PDF 在本机转成结构干净的 Markdown,并且先判断这份文件到底需不需要 OCR。最大的亮点是快——官方基准里 200 份文档跑完只需 0.47 秒,全程不上传文件。如果你经常整理资料、搭建知识库,或者维护文档处理流水线,它解决的是一个非常具体的成本问题。
❝项目名称:pdf-inspector主要语言:Rust、PythonStars:19.5kForks:1.3k项目链接:https://github.com/firecrawl/pdf-inspector
下载了 PDF,却复制不出能用的文字
你一定遇到过这种场面:从官网存下一份年报或论文,想引用其中一段,复制出来却是一团错行;表格粘进笔记后变成孤零零一列数字,标题和正文糊在一起;想交给 AI 处理,还得先手工梳理一遍。
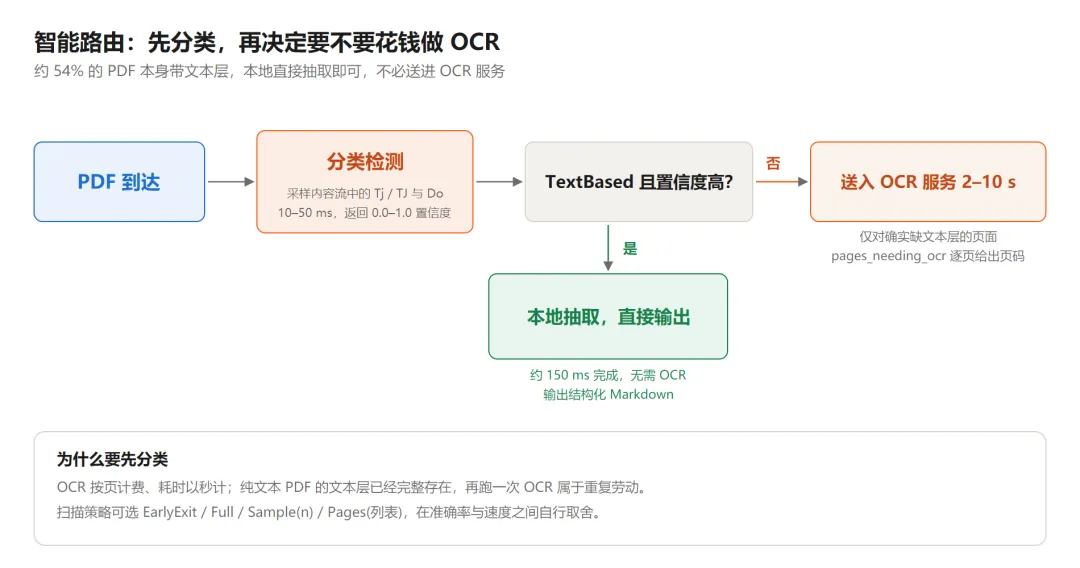
于是很多人转向 OCR。但在这背后有个常被忽略的事实:大多数 PDF 本身带着完整的文字层,只是排版信息散落在坐标、字号和字体编码里。按官方 README 的口径,约 54% 的 PDF 根本不需要 OCR。把它们一律送进识别服务,等于为同一件事付两次钱,还要多等几秒到十几秒。
pdf-inspector 的做法是把这一步拆开:先分类,再决定怎么处理。
智能分类:10–50 毫秒判断该不该做 OCR
它只采样 PDF 内容流里的文字算子与图片算子,不加载整份文档,就能在 10–50 毫秒内给出 text_based、scanned、image_based 或 mixed 的判断,并附带 0.0–1.0 的置信度。
更实用的是,它返回一份 pages_needing_ocr 页码清单。通俗地说,路由粒度从“整份文件”细到了“具体哪一页”,混合型 PDF 里那几页真正的扫描件单独送去识别,其余页面本地直接抽。扫描策略还提供 EarlyExit、Full、Sample(n)、Pages(列表) 四种,让你在准确率和速度之间自己取舍。
表格与分栏:从绘图指令和文字对齐两头下手
表格是 PDF 转 Markdown 最容易翻车的地方。这个项目用了双路判定:一路读取 PDF 的绘图指令,按矩形框还原单元格;另一路从文字对齐关系反推行列。两路结果合并后输出 Markdown 表格,还能处理跨页续表和财务文档里的数字拆分。
多栏排版同样被单独对待。分栏检测、行归组、阅读顺序是一整条独立链路,报纸式双栏不会被读成左右穿插的一行。旋转的文字(页边印章、图表坐标轴标题)会保留真实旋转角度,不会塌成零宽度。
选择性 OCR:默认不装,用到才加载
OCR 在这套设计里是可选能力,不是默认负担。auto 只识别被原生抽取拒绝的页面,force 强制识别所选页,off 则保留结果与来源信息但完全不调用外部运行时。
它的一个重要取舍是:默认构建是纯抽取,不含 PDFium、ONNX Runtime 和模型文件。只有真的有页面被路由到 OCR,才会去加载这些依赖。这意味着干净的文本 PDF 永远不会因为“装了个重量级组件”而变慢。
一次解析,四种语言调用
文档只加载一次,检测、抽取、版面、表格、Markdown 五个阶段共享同一份内存结构,避免了重复解析——这是它速度优势的来源。
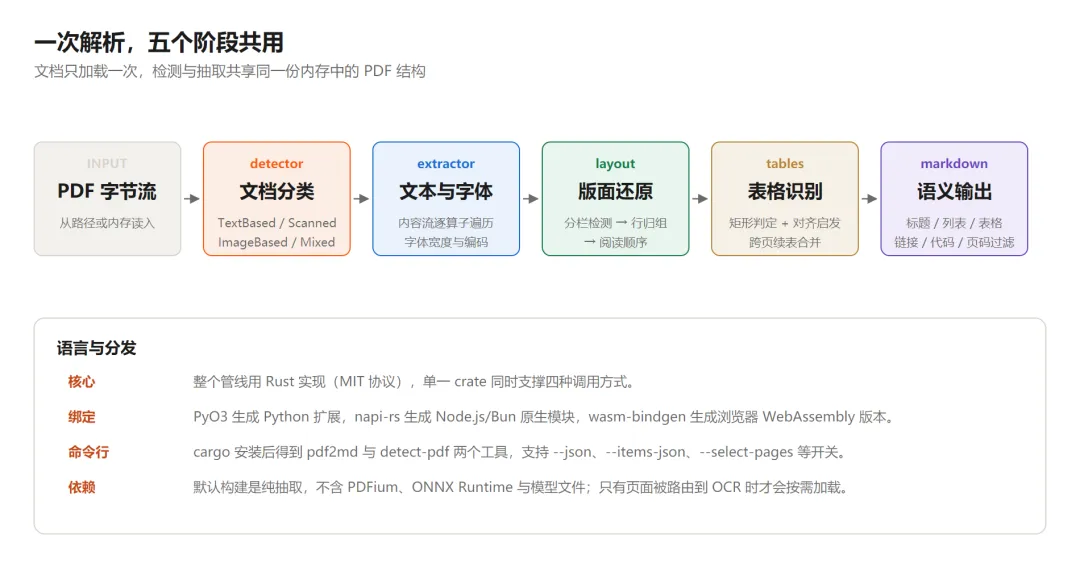
核心管线全部用 Rust 实现,再通过三层绑定分发出去:PyO3 生成 Python 扩展,napi-rs 生成 Node.js/Bun 原生模块,wasm-bindgen 生成浏览器 WebAssembly 版本。命令行侧提供 pdf2md 和 detect-pdf 两个工具,支持 --json、--items-json、--select-pages 等开关。
上手只要一行:
pip install pdf-inspector安装 Python 包,Node 用npm i @firecrawl/pdf-inspector,Rust 用cargo add pdf-inspector。调用 process_pdf("document.pdf"),读取返回的pdf_type、confidence和markdown。需要处理扫描页时再调 process_pdf_with_ocr,配置PDFIUM_LIB_PATH与ORT_DYLIB_PATH指向本地库文件。
预编译包覆盖 CPython 3.8 以上的 Linux(x86_64、aarch64)、macOS(Intel 与 Apple Silicon)和 Windows(x64)。浏览器版则把同一个 Rust 解析器编译成 WebAssembly,官方站点上就有可以直接拖入 PDF 的演示,文件不出本机标签页。
它的边界在哪里
性能数字需要说明出处:官方基准在 opendataloader-bench 的 200 份 PDF 语料上评测,OCR 关闭,环境是 Apple M4 Pro,取五轮完整运行的中间值,结果刷新于 2026 年 7 月 31 日。这是单一平台的测试结果,不宜直接推广到所有硬件。
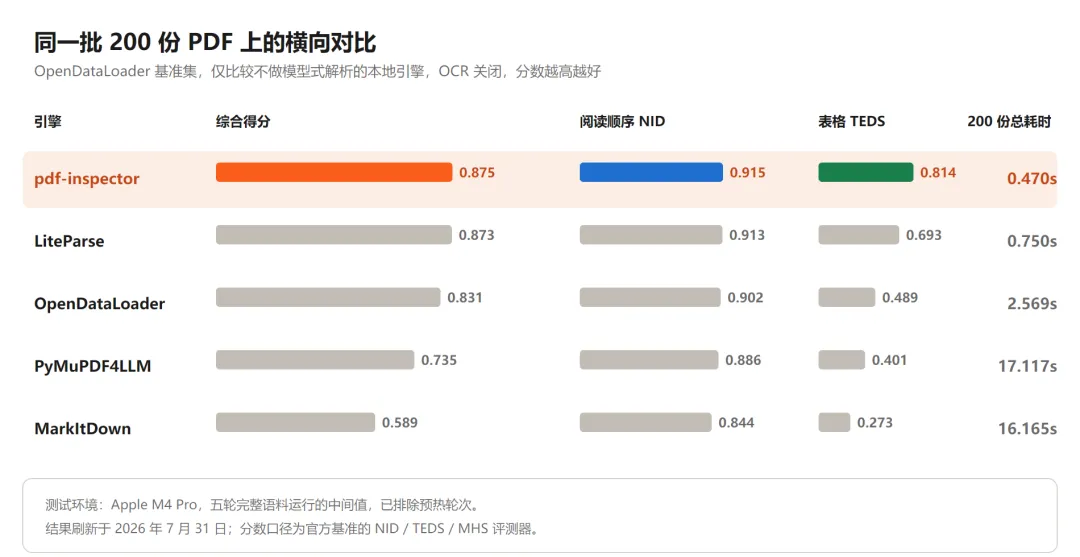
同一批文档上,pdf-inspector 综合得分 0.875、阅读顺序 0.915、表格 0.814,200 份总耗时 0.470 秒;对比项里 LiteParse 综合 0.873(0.750 秒)、OpenDataLoader 0.831(2.569 秒)、PyMuPDF4LLM 0.735、MarkItDown 0.589。
需要提前知道的限制也有两条:它最适合原生文本 PDF,纯扫描件仍要走 OCR 路径;另外 ONNX Runtime 1.27.0 没有发布 Intel macOS 的归档,该平台上本地 OCR 需要自行准备兼容构建。
立刻上手
pdf-inspector 最值得关注的地方,是把“要不要 OCR”从判断题变成了可编程的分支,并且把解析速度压进了毫秒级。它不追求做一个全能阅读器,而是把自己定位成流水线里的一环。
最适合三类人:需要批量处理报告、发票、合同的后端开发者,做文档问答和知识库的内容团队,以及希望文档不外传的个人用户。项目使用 MIT 协议,最新正式版 v1.25.2 发布于 2026 年 9 月 28 日,仓库提交活跃,可以放心试用。
GitHub 仓库:https://github.com/firecrawl/pdf-inspector
资料来源
GitHub Trending(Daily):https://github.com/trending 项目仓库与 README:https://github.com/firecrawl/pdf-inspector 官方文档站点:https://firecrawl.github.io/pdf-inspector/ Python 绑定文档:https://github.com/firecrawl/pdf-inspector/blob/main/docs/python.md OCR 运行时配置指南:https://github.com/firecrawl/pdf-inspector/blob/main/docs/ocr-runtime.md 发布版本页:https://github.com/firecrawl/pdf-inspector/releases 基准语料仓库:https://github.com/opendataloader-project/opendataloader-bench PyPI 包页:https://pypi.org/project/pdf-inspector/