ARTICLE · 1138508
安卓版Ollama杀疯了:6GB旧手机跑大模型,OpenAI接口随便调
安卓版Ollama杀疯了:6GB旧手机跑大模型,OpenAI接口随便调
把旧手机变成一台本地模型服务器,这事比想象中简单。 每天总有那么几件碎活要处理:抓取几个RSS源、整理相册照片的标签、接几条智能家居的控制指令。 每次耗时不过几秒钟,但需要有个东西一直挂着。专门为这点事开一台电脑,怎么算都不划算。 最近在GitHub上发现一个项目,思路挺巧:把闲置的安卓手机变成一台本地推理服务器。 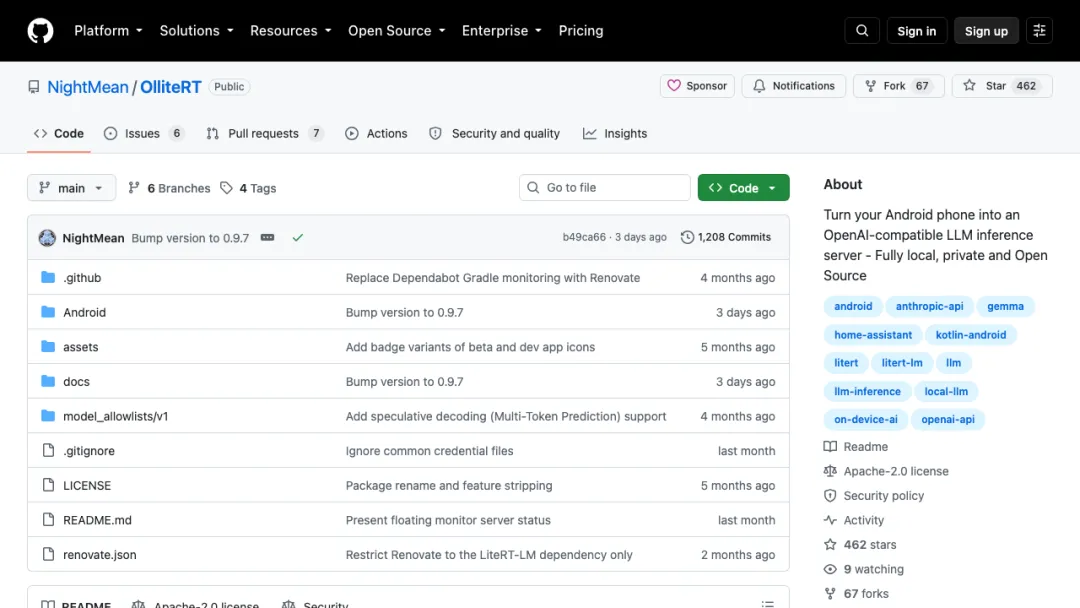
项目叫OlliteRT,作者对标的是Ollama的体验——在手机上跑模型,同时开一个兼容OpenAI的HTTP接口,局域网里其他设备填个地址就能调用。 
01 它靠什么跑起来 
底层用的是谷歌的LiteRT-LM运行时,推理直接调用手机自身的GPU或CPU。对外暴露一个HTTP服务,Apache-2.0协议开源。 项目本身基于谷歌的AI Edge Gallery改造,不是从零手搓。 模型下载完成后,断网也能正常使用。数据全部在手机本地处理,官方明确表示不收集数据,代码里也没有统计逻辑。 
02 模型选择:先看手机内存够不够 
模型来源有三种方式: 内置清单目前有七个模型可选:
这里有个容易误判的地方。标题说6GB内存能跑,指的是最低门槛,只有最下面三个小模型符合。官方推荐的Gemma 4 E2B最低要8GB,E4B要12GB——这两个支持多模态,能看图、能听音频,回答前还会先输出一段推理过程。 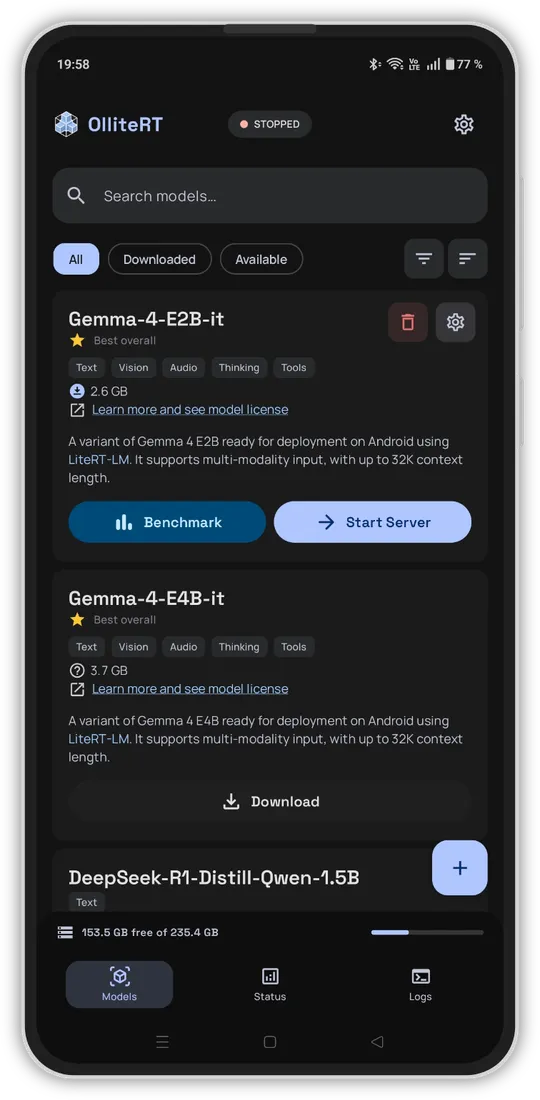
手机内存只有6GB的话,别一上来就选E2B。 Gemma 4还有个MTP功能,一次预测多个词,出字速度会明显提升,需要在模型设置里手动开启。 
03 客户端基本不用改 
这是它做得比较到位的地方。 OpenAI的chat/completions、completions、responses全都支持,音频转写接口也有,连Anthropic的messages接口都兼容了,流式和非流式都能用。模型列表和健康检查端点也齐了。 所以手头现成的工具基本不用动: 有人把NAS上几个定时任务的接口地址改了一下,任务直接跑起来了。 两个需要注意的点 工具调用目前是实验性质,在Gemma 4上效果最好,小模型不一定能稳定按格式返回。默认走schema注入,不行可以在设置里关掉,退回提示词解析的方式。 Home Assistant还需要额外配置,要装自定义集成,语音指令还要再配一个转写组件,不是填个地址就能用。 
04 状态、日志、指标一应俱全 
服务跑起来后,状态页上有实时数据:运行时长、请求数、输入输出token、出字速度和峰值、首字延迟、成功率。 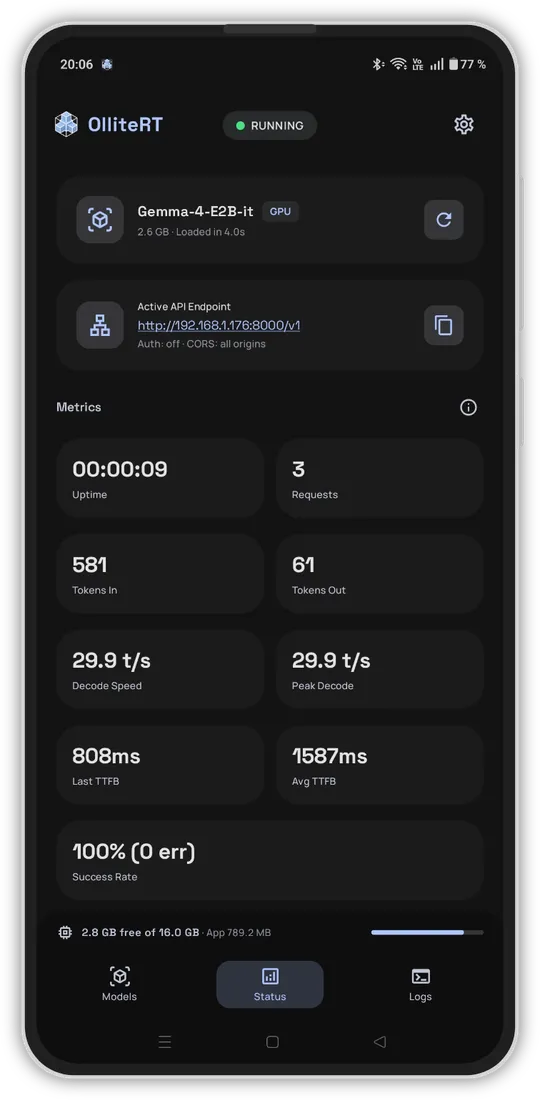
还有一个可拖动的悬浮窗,手机放在一边当服务器时,瞟一眼就知道服务是否还在跑。 日志页记录每次请求和响应,支持按方法或状态码过滤,能搜关键词,JSON带语法高亮。每条日志下方有一排标记:耗时、是否流式、是否开启思考、输入token占上下文比例——快满时数字会变黄变红。 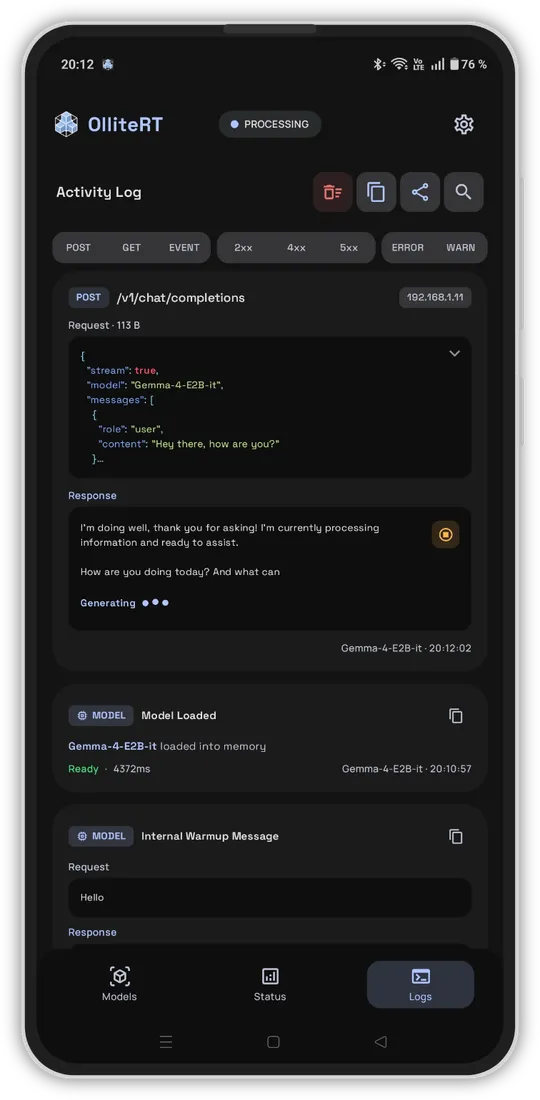
除了应用内的界面,它还有/metrics端点,输出29个Prometheus格式指标,家里跑Grafana可以直接接入。 Home Assistant除了调用模型,还能通过内置REST接口远程查看状态、切换模型、修改设置。 内置的Benchmark功能,可以在同一台手机上把几个模型挨个测一遍,比较长输入处理速度、出字速度和加载速度。 
05 常驻运行的几个关键开关 
每个模型可以单独保存推理参数,温度、top-k、top-p、最大输出长度都按模型存储,重启后依然生效。加速器可在GPU和CPU间切换,默认GPU,有问题再换CPU。修改最大输出长度或加速器会触发模型重载。 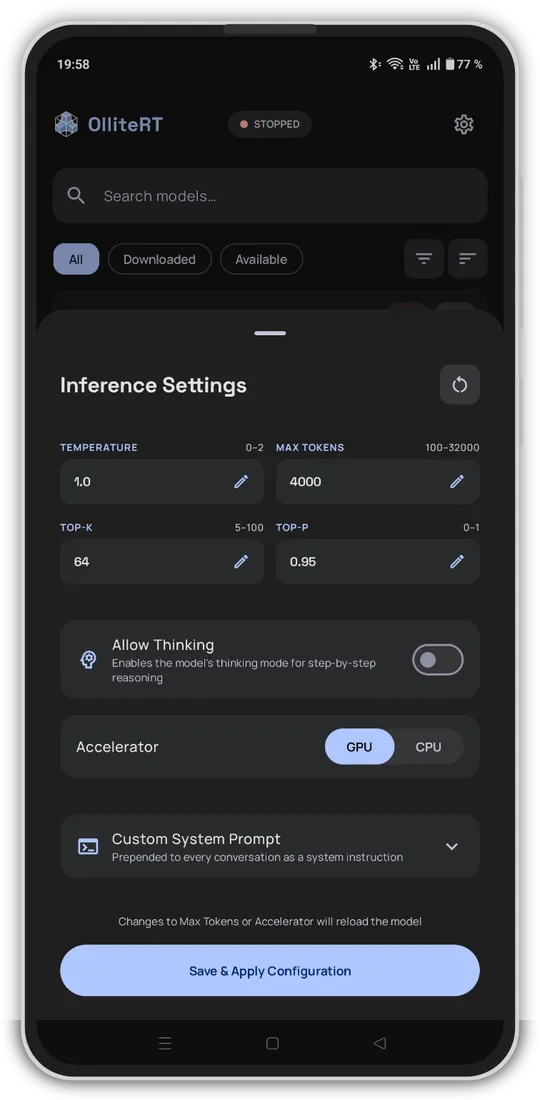
要让手机像小服务器一样常驻,三个开关值得打开: 闲置自动卸载:设定时间,比如5分钟无请求就把模型从内存卸载,内存还给系统。下个请求进来会自动重新加载,代价是这次会慢几秒。手机还要干别的活时,这个功能很实用。 开机自启:选默认模型打开开关,手机重启后服务自动启动。前提是关闭电池优化,否则安卓后台可能直接杀掉进程。 常驻通知:靠前台通知保住后台服务,通知栏有停止服务和复制地址两个按钮。 三个都配好,这台手机基本就是个免维护的设备。 
06 安装三步,但别放公网 
从GitHub Releases下载APK安装,打开后在模型列表选一个下载,完成后点模型卡片上的Start Server,状态页会显示地址,一般是http://手机IP:8000/v1。填进客户端即可。 目前发布的都是beta版本,最新是v0.9.7-beta.1,安装包三十几MB。 硬件要求 2017年后的安卓机基本都是arm64,模拟器和x86设备不支持。 接口支持bearer token验证,开启后无token请求返回401。也能设置客户端IP访问规则,只放行家里设备,监听范围可调。 官方文档特别强调:不要通过端口映射暴露到公网。没有HTTPS,token验证也只是基础防护。适用场景就是局域网。 
07 几个硬限制 
只跑推理的话,够用了。 
08 适合当什么用 
替代正经推理机器不现实——一次一个模型、请求排队,这个限制绕不过去。 但放在特定场景下刚好:任务碎、量小、不想开电脑、数据不想外传,加上监控、日志、权限、自启都有,当常驻服务没问题。 家里有闲置安卓机的话,可以装一个试试。 —END—
应用内置清单直接下载,文件托管在HuggingFace的LiteRT社区 导入手机里已有的.litertlm文件 自定义模型源,填JSON或URL,大约每24小时刷新一次
Python里用OpenAI官方SDK,把base_url指向手机就行 curl直接调用没问题 Open WebUI填个地址就能连上
安卓12以上 arm64架构 内存最低6GB,多模态建议8GB以上
一次只能加载一个模型,请求排队处理,不适合多人共用 只支持.litertlm格式,不认GGUF,llama.cpp和Ollama的模型文件用不了 token计数按字符数除以四估算,英文还行,代码和多语言会偏,不能用来算费用 本地导入模型会复制文件到应用目录,占双倍空间,导入后记得删原文件 移动端运行时的限制,logprobs、语法约束输出、重复惩罚、LoRA这些都没有
开源地址:https://github.com/NightMean/OlliteRT
==好了,给粉丝个福利== ==打车千万别直接去APP,记得先领券== 亲测一单省了30块钱