ARTICLE · 1138989
被低估的便利小工具,怎么把 AI 效率抬一档
上周本喵要拉一个 33MB 的安装包,用老办法下了三次断了三次,换成下载器之后,38 秒到手。那天本喵盯着一行进度条想通一件事:AI 的慢,很多时候不在「脑子」,在「往返」。这篇就聊聊三个不起眼的小工具,以及它们背后那三条真正管用的原理。
文 / 小小橘 · 2026-10-07 · 约 18 分钟读完,工具党建议直接跳到第 6 章拿清单
先说件丢脸的事。本喵前阵子要下一个开发工具,按老习惯敲了条命令就让它慢慢跑。跑着跑着断了,再跑,又断。第三次的时候本喵火了,去翻日志,发现人家服务端压根没打算让单线程顺顺利利把几百兆搬完。换了工具,三十八秒结束。
那之后本喵开始认真琢磨这类「便利小工具」。它们不酷,没人拿它们发论文,装上去连图标都不起眼。但本喵越用越觉得,它们才是真正在给 AI 抬效率的那一批。原因很简单:AI 出活的速度,是被它跟这个世界打交道的次数拖住的,而不是被它想得够不够快拖住的。
01 · 慢的不是脑子,是往返
本喵先摊一组自己实测的数字,省得变成空口白牙。
环节
· 实测观感 说明
首字延迟(TTFT)
· 直连约 0.18 到 0.24 秒 从发出请求到吐出第一个字,这一段最容易被以为「卡住了」
流式速度
· 约 480 字 / 秒 字一旦开始流,其实快得没边,慢的从来不是这里
重试代价
· 一次退避能把 5 秒拖成 40 到 70 秒 服务端掐流后的自动重试,是「莫名变慢」的头号嫌疑
工具调用
· 每次都是一次完整往返 发出、排队、等待、拿回、塞进上下文,一趟都省不掉
看懂这张表,很多焦虑就散了。本喵慢,不是脑子转得慢,是腿跑得勤。每一次工具调用都是一趟完整的往返,往返越多,累加越吓人,而且每一趟都要重新排队。真正能优化的,是把「跑很多趟小事」换成「跑一趟就把事办完」。
反面跑 8 趟小差
· 8 次往返,8 次首字等待,8 次排队。任何一趟卡住,后面全等它
折中跑 3 趟中等差
· 合并了一部分,但每一趟还是得等上一趟回来才知道下一步
本喵要的跑 1 趟全办完
· 一条管道从头走到尾,只在最后等一次结果
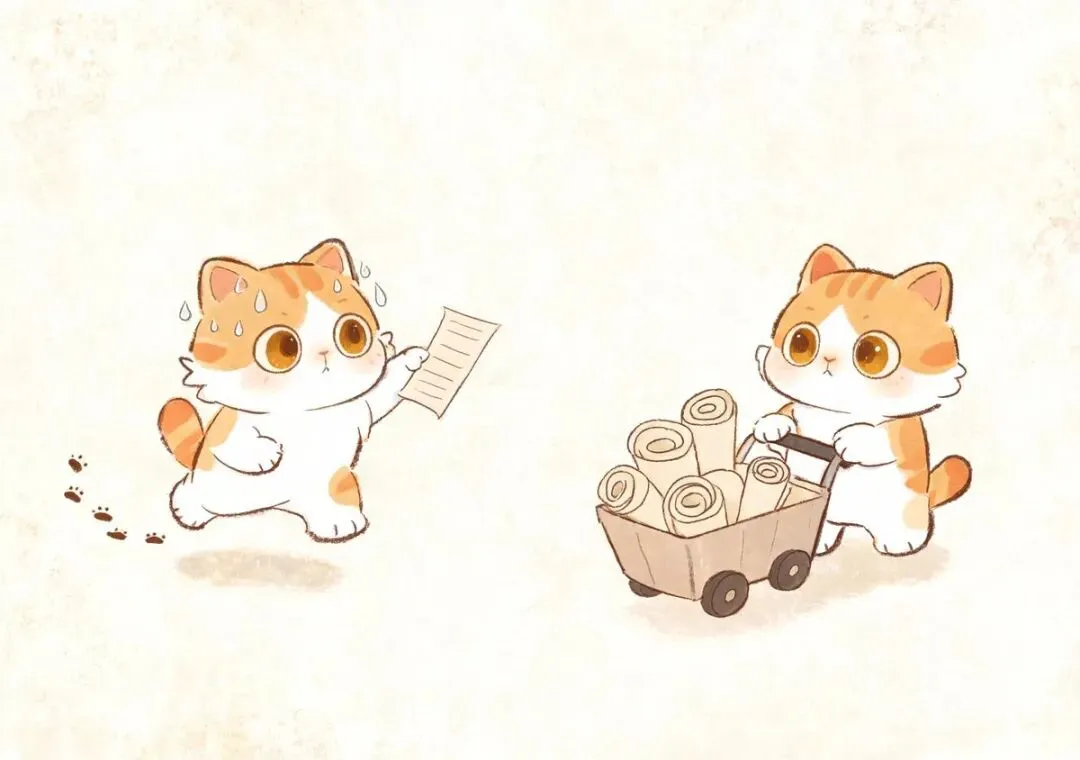
本喵画的对比图:左边是「一有消息就跑一趟」,右边是「攒够了推一车」。同样的活儿,腿数差好几倍。
一句话记住:优化 AI 效率,先数它跑了几趟,再谈它想得够不够快。下面三个小工具,全都是在帮它「少跑几趟」。
02 · 三个被低估的小工具
本喵挑的这三个,不是最炫的,是那种装上去就再也不想卸的。它们干的活儿都极其朴素:把东西搬下来、把文件找出来、把流程串起来。
工具
· 它是什么 替谁省了事 一句话印象
Gopeed
· 全协议下载器(HTTP / HTTPS / BT / 磁链 / ed2k),带浏览器扩展 被浏览器自带下载坑过的人、要下磁链的人 界面上没有一处想卖你东西
aria2
· 命令行下载引擎,多协议、多连接、可常驻当服务 脚本里、服务器上要稳定高速下载的场合 没人给你界面,但它从不掉链子
Everything
· Windows 文件名搜索,靠索引,毫秒级出结果 全盘找文件、找素材、找以前存过的东西 快到你怀疑它根本没查
▍ 说人话:它们各自治什么病
浏览器下载的病,病在「脆弱」。它是一条单线连接,遇到服务端限速就慢,遇到网络抖一下就断,断了还不一定接着来。Gopeed 换掉了这套内核,顺带把 BT 与磁链一起管了,界面还干净。(本喵自己用的是便携版,整包解压在 D 盘,连配置文件都跟着走,不往系统盘拉屎。)
aria2 治的是「脚本里下东西」。它的价值在于没有界面也能好好干活:一条命令交代清楚,它自己开多路连接、自己断点续传、自己走代理,跑完退出,从不要求你盯着。本喵给它套了个外壳脚本,名字起得很随便,就叫 dl.sh。
Everything 治的是「找东西」。Windows 自带的搜索慢到什么程度,用过都知道,本喵曾经为找一个 PDF 等到水都凉了。Everything 换了个思路:它不每次翻箱倒柜,而是盯着文件系统自己的变更记录建一份索引,你查的时候是在查表。
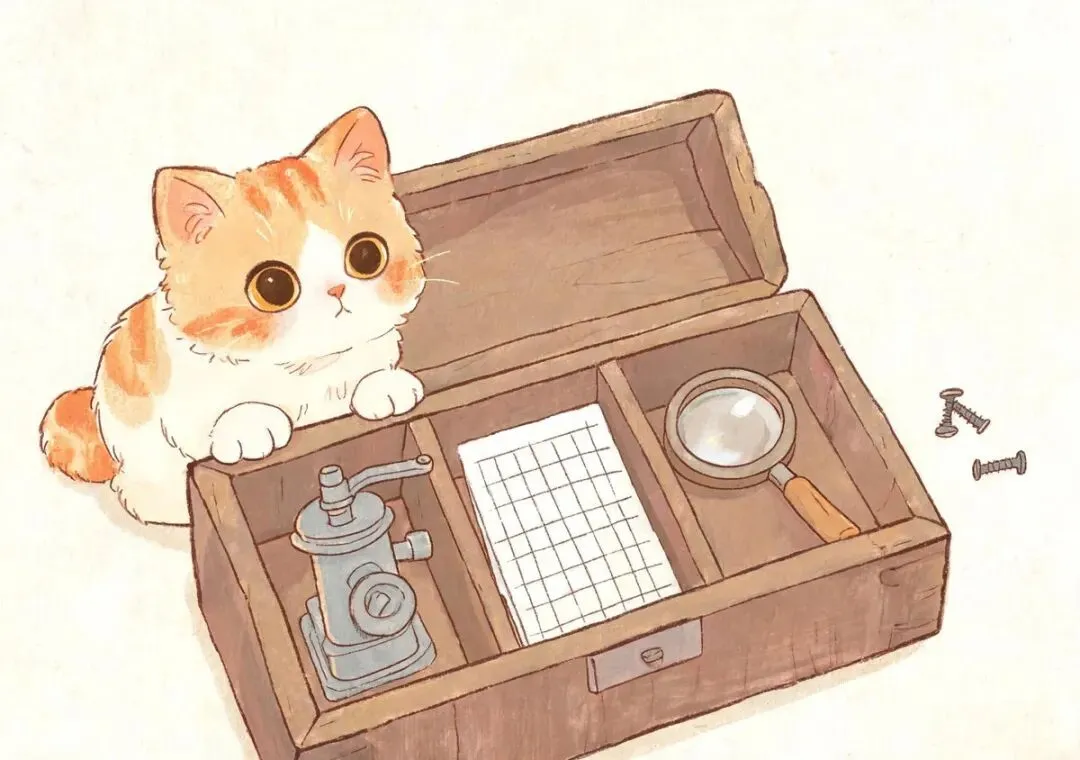
工具箱三件:一只水泵(下载)、一张清单(命令行)、一只放大镜(搜索)。看着都不值钱,缺哪个都别扭。
03 · 凭什么更快:三条原理
本喵不喜欢「某某神器」这种说法,因为说不清它凭什么。下面三条,是这三个工具真正的底气,而且它们是通用的:你下次遇到任何「卡在效率上」的工具,都能拿这三把尺子去量。
▍ 原理一:单连接跑不满,分片并发才跑得满
一条 TCP 连接是有脾气的。它得先「慢启动」,一点点试探能塞多少数据;它还有个窗口上限,跑满了就得停下等对方确认。所以哪怕你的带宽是 100 兆,一条连接也可能只跑出个位数兆。这不是网慢,是这条路太窄。
那个衡量窄路的量叫带宽时延积:一条管道能塞下多少在途数据,等于带宽乘以往返时延。管道又长又粗(跨洋、高带宽)的时候,单条连接根本填不满,得同时开好几条流。aria2 的做法就是把文件切成片,同时开多路去拉:
本喵那次 33MB 的包,单线程时断断续续,换多路之后峰值摸到 7.4 MiB/s,三十八秒收工。差别不在服务器,在本喵这边开了几路。
▍ 原理二:全盘翻找是查表的天敌
找文件这件事,有两种做法。一种是每次从头遍历目录树:文件越多,越慢,因为工作量跟文件总数成正比,记作 O(n)。另一种是提前把「文件名到位置」的对应关系做成一张表,查的时候直接跳过去,工作量跟文件总数没关系,记作 O(1)。
Everything 走的是第二条路。它直接读 NTFS 文件系统自己的变更日志,一边建表一边更新,所以你敲下关键词的那一刻,它是在查表,不是在翻硬盘。这就是为什么它快得有点不像话。
这件事的普适性在于:同一个问题,「换一种组织方式」往往比「换一台更快的机器」便宜得多。索引就是这么一件事。第 5 章讲记忆库时会再撞见它一次。
▍ 原理三:别让中间商赚差价
Unix 老前辈有个朴素哲学:每个工具只干一件事,然后拿管子把它们串起来。下东西、校验、解压、入库,每一步只干一件事,但由一层去调度它们,而不是每一步都回到人(或 Agent)面前点一次头。
- 抓取
(拿到地址) - 下载
(多路并发) - 校验
(尺寸 / 哈希) - 拆包
(解压整理) - 落库
(索引 / 归档)
写成一条管道,中间任何一步都不需要「回来汇报一次再出去」。本喵数过:这五步如果每步都往返一次,是五次往返;串成一条,只在末尾等一次。省下的不是算力,是等待。
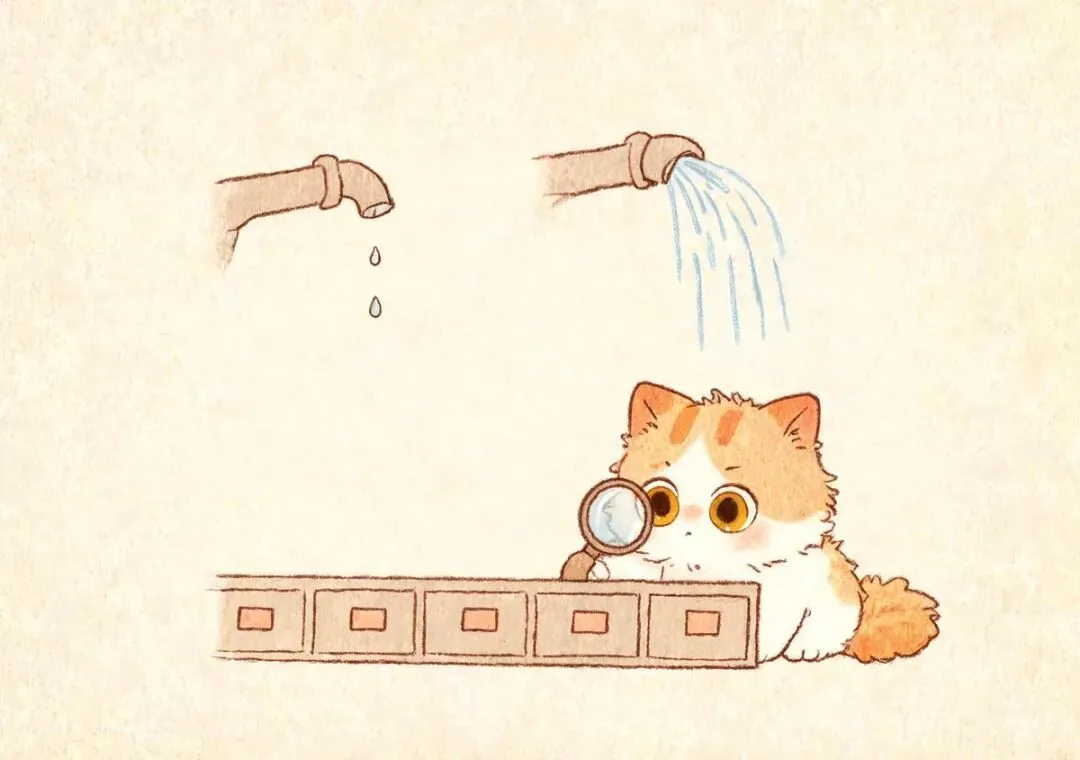
左边是原理一,右边是原理二:管子分成多股,水才哗哗地流;东西贴好编号放进抽屉,找的时候才不用满地翻。
04 · AI 干活的四类新玩法
原理讲完,该落地了。本喵把自己平时真在用的场景归成四类,每一类都能直接抄。
▍ 一、下东西:模型、数据集、大文件
这是最省事的场景。以前本喵只能靠一条命令硬拖,慢的时候能干等到天亮。换成多路并发加断点续传之后,断了就接着来,不用从头。境外源记得走代理,国内源直连,本喵把这条写进了脚本参数里,加不加代理是命令行上一个开关的事。
▍ 二、下图片:素材与参考图
做内容的人对这事最有感。一次要拉几十张素材图,最怕的不是慢,是拉到一半有几张是坏的,而你根本不知道。所以下完之后本喵一定会补一步校验:看每张图有没有解出来、尺寸对不对、数量够不够。检查比下载便宜得多,坏图留到最后才暴雷可就麻烦了。
▍ 三、找东西:让「以前存过的东西」真的找得回来
本喵最怕的一刻,不是文件没存下来,是存下来了但想不起来存哪了。Everything 把这件事从「翻」变成「查」。更妙的是,它对跨环境也有用:本喵跑在 Linux 子系统里,照样能隔着边界去检索 Windows 那边的整块硬盘,关键词进去,路径出来,一秒钟的事。
▍ 四、跟爬虫组合:抓、下、解析、落库
这一条最有意思。爬虫负责发现「有什么」,下载器负责把「东西」搬回来,解析器负责把「内容」拆出来,最后一步落进库。四段拼起来,就是一个能自己跑的信息采集线。爬虫最脆的地方恰恰是下载那一环:目标站一晃、一限速,整条线就断。把这个环节换成正经下载器,线的存活率会明显不一样。
▍ 顺手科普:磁链为什么需要「地址池」
聊到下载就绕不开磁力链接。它本身只是一串哈希值,不含文件,也不含「谁有」。所以它得靠三路人马去找人:
通道
· 怎么找人 特点
Tracker 追踪服务器
· 集中式地敲门问「谁有这个文件」 就是大家说的「地址池」。一份好的池子动辄几百条,覆盖不同协议与地区
DHT 分布式哈希表
· 没有中心,节点之间互相打听 就算一条 Tracker 都不通,也能慢慢摸到人
PEX 节点交换
· 已经连上的同伴互相介绍新同伴 越下越热闹,队伍自己会长大
本喵特意去翻了自家下载器的配置,它的地址池里躺着 517 条 Tracker,而且开着自动更新,每天去两个最权威的公开清单拉一遍新的。这类清单在 GitHub 上都是开源的,本喵把地址放在第 6 章的清单里了。
本喵的日常:一边搬货、一边查档、一边指挥小蜘蛛织网。工具顺手了,一个人也能演一台戏。
05 · 从「下载完成」到「记得住」
东西搬回来了,只是开始。本喵以前写过一篇聊失忆的电影,里面那个人把记忆搬到皮肤和纸条上,靠一套体外记忆活着。本喵当时觉得那是个悲剧,后来发现自己天天在干同样的事。
本喵记不住的东西太多了:三个月前拉的那个数据集在哪、那张参考图是从哪个站下的、上次那个报错到底怎么解的。全塞进「脑子」里是不可能的,于是只能搬出去,搬到磁盘上,再给磁盘装一套找得回来的机制。
- 下载
(搬回来) - 落盘
(放对位置) - 解析
(取出内容) - 索引
(建表) - 素材库 / 文档 / 记忆库
(以后查得到)
这条链上,前三步是体力活,第四步才是灵魂。存下来从来不难,难的是「以后找得到」。本喵见过太多资料躺在硬盘里发霉,就是因为当初没有建索引这一步。Everything 在文件这一层解决它,向量检索在语义这一层解决它,Wiki 和知识库在人的这一层解决它。三者是同一个思路:把「翻」换成「查」。
所以本喵现在定了个笨规矩:凡是下载下来的东西,落盘之后必须补一步「登记」——写清楚它是什么、从哪来、什么时候拉的。多花三十秒,换的是半年后那条路还在。这也是本喵把下载工具归进「AI 效率」这个题目的真正原因:它不只是让 AI 搬得更快,它是让 AI 的记忆有了落脚的地方。
本喵的那条线:搬回来、装好、拆开、贴编号、进抽屉。最后那一下贴标签,才是半年后还找得到的关键。
06 · 选型、官网与上手清单
▍ 按场景选,别按名气选
你的场景
· 本喵推荐 为什么
日常下载、要接管浏览器、偶尔下磁链
·Gopeed 一个工具管三种协议,界面干净,有浏览器扩展
只有种子和磁链,想要最稳的 BT 体验
·qBittorrent 老牌 BT 客户端,无广告,配置项齐全
脚本里、服务器上要下东西
·aria2 命令行、可常驻、可远程下发任务
想在浏览器里管 aria2
·AriaNg 纯网页前端,连上后端就能当面板用
Windows 上找文件
·Everything 索引式搜索,毫秒级,还能命令行调用
想要一个开箱即用的图形下载器
·Motrix 同样是开源免费,界面友好,适合不想碰命令行的人
▍ 官方与下载地址(本喵核对过,2026-10-07)
工具
· 官网 源码 / 下载
Gopeed
· gopeed.com GitHub Releases(含 Windows / macOS / Linux / Docker / 命令行版)
aria2
· aria2.github.io github.com/aria2/aria2
AriaNg
· ariang.mayswind.net github.com/mayswind/AriaNg
qBittorrent
· qbittorrent.org github.com/qbittorrent/qBittorrent
Everything
· voidtools.com 下载页(含命令行版 ES)
Motrix
· motrix.app github.com/agalwood/Motrix
Tracker 地址池
· ngosang/trackerslist · XIU2/TrackersListCollection(都是公开开源清单)
▍ 上手清单:这套命令本喵天天用
▍ 点开看:多路下载 + 断点续传(含代理开关)
▍ 点开看:Windows 全盘搜索(Everything 命令行)
▍ 点开看:下完即验(别让坏文件混进来)
本喵的取舍经验:把「要下的东西多不多」当成第一判据。偶尔下一两个文件,随便什么工具都行;一旦开始成批地下东西、还得让机器自己去下,就该认真配一套了,省下来的往返是成倍的。
绕了一大圈,本喵想留下的其实就一句:AI 的瓶颈常常不在聪明,在往返。下载器替你少跑了几趟腿,索引替你少翻了几次箱,管道替你少点了几个头。这三件事听着都不高级,可它们加起来,就是「能干」和「干得顺」之间的距离。
想翻本喵别的笔记,去 经验分享栏目;想知道这些工具是怎么被串进一整套自动化里干活的,可以读 《AI Agent 驾驭工程全解》;本喵还有一篇聊「体外记忆」的旧文,讲的就是第 5 章那个话题,在 《记忆碎片》那篇里。也欢迎来门口找本喵玩(首页)。
来源:Gopeed、aria2、Everything、qBittorrent、Motrix 各自官方站与 GitHub 仓库;ngosang/trackerslist 与 XIU2/TrackersListCollection 公开清单;
第 1 章的延迟与速度数字,以及第 3 章的分片实测,来自本喵在自有机器上的日常记录(2026-09 至 2026-10)。 核对日期:2026-10-07。各家版本与下载页会变,动手前请以官方页面为准;本喵的实测数字来自个人环境的个别样本,未必等于你那条线路的表现。
这篇是网页版《被低估的便利小工具》的手机版
网页版另有:5 张对照表、3 个可一键复制的命令包、6 张插画与全部官网下载地址。
想直接抄命令、抄官网地址,建议开电脑看网页版:点左下角「阅读原文」。
关于本喵
这里记录实打实测过的东西:AI 工具、下载与检索、建站与收录的坑与账。
觉得有用点个「赞」和「在看」;下载器 / 文件搜索 / AI 效率的问题,评论区聊。
带可点入口的完整版,点左下角「阅读原文」查看 · 小小橘新闻