ARTICLE · 1139139
怕信息泄露?手搓一个文档脱敏工具
在给老师们做 AI 培训中,很多老师都非常关心一个问题,那就是数据安全。保险起见,在将文档发给 AI 之前,我们需要对里面的姓名等信息做脱敏处理。
今天我们就来手搓一个文档脱敏工具,以此为切入点,聊一聊以单 HTML为载体的初级 VibeCoding 到底怎么做。
01
PART
明确需求:我需要的功能是什么?
REQUIREMENT
一份文档里要处理的东西大致分两类。
一类是号码,手机号、身份证号、邮箱、固定电话、银行卡、QQ 和微信号。这些有固定格式,好认。
另一类是要判断的,姓名和单位名。
同样是“张伟”,出现在“指导教师:张伟”里是老师,出现在“小组成员:张伟”里是学生,出现在“参考文献”里则根本不该动。工具会给每一条识别结果标一个置信度,分高、中、低三档,默认只勾高置信的,低的先摆着提醒你。识别的开关也可以逐个关掉,只处理手机号、邮箱这类硬信息,把姓名留着人工判断,都是可以的。
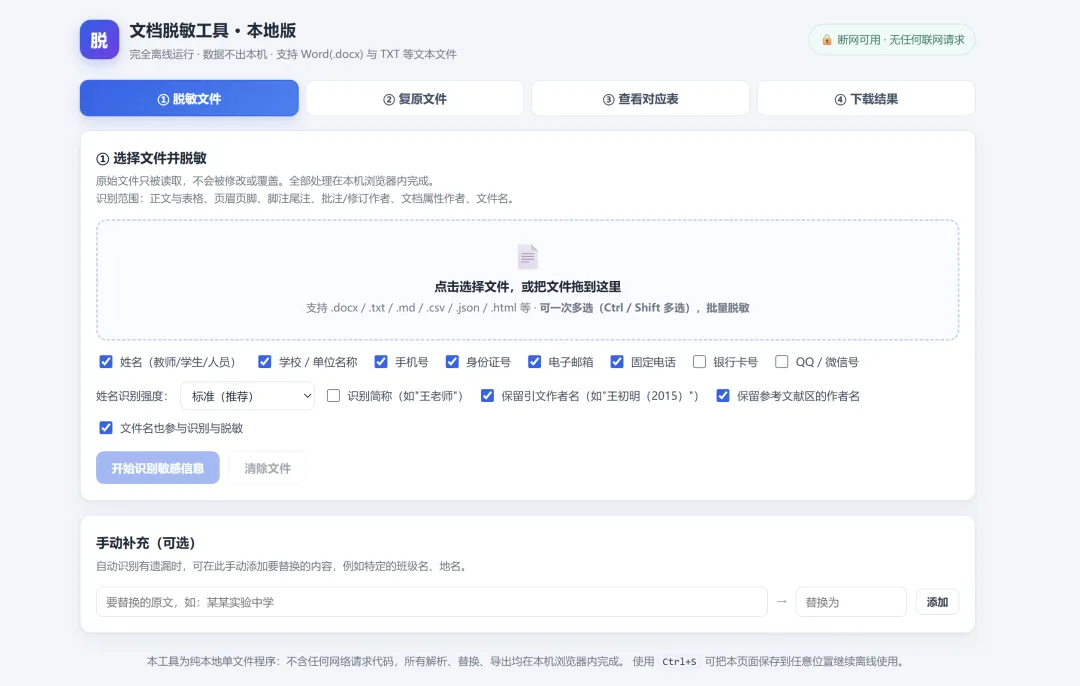
它对 Word 文档的处理范围比正文宽得多。除了正文和表格,页眉、页脚、脚注、尾注、批注内容、批注和修订的作者、文档属性里的作者字段,以及文件名,都会被翻一遍。所以导出之后再打开,页眉上的校名不见了,批注里的署名也换了。
识别结果不会直接替换掉。它会先摆出来让你核对。每一条都能改匿名名、改身份类型、取消勾选,能按关键词筛,鼠标停在上面能看这个词在原文里的上下文。数量多的时候按类型分组,教师一组、学生一组、号码一组。识别漏了的,可以手动加一条“原文 → 替换名”。
核对完点生成,会得到两个东西。一份脱敏后的文档,一张“脱敏—原始”对应表。对应表存在浏览器本地,也能导出成 CSV、Word 表格或 JSON。这张表就是还原钥匙,把脱敏文件和对应表一起导进“复原”页,匿名名会全部还原,连文件名里的也一起还原。
工具支持一次拖进多个文件批量处理。跨文件重复出现的姓名会被自动提升置信度,一份名单分散在几个文件里也能对上。
02
PART
选择平台:用什么工具开发?
PLATFORM
这个工具大概两千多行,纯前端,没有任何外部依赖。听着不小,但真正花时间的地方在反复调识别规则上,代码本身写得并不慢。
写这类东西,用Trae、WorkBuddy 的代码模式或者 Codex这类编程智能体,会比用一般大模型的对话框顺手得多,原因有三个。
一是文件规模
两千行的代码,对话框里根本放不下,你得一段段复制粘贴,改到第三轮就分不清哪个版本是新的。编程智能体直接在你本地的文件夹里读写文件,改完就在那,不用你搬运。
二是“改”这件事的性质
工具做到一半,一定会冒出“这个词不该识别”这类需求。改一处时,智能体能把整个文件读进来,顺带检查别处有没有被带坏;对话框里它只看得到你贴过去的那几百行,改出来的东西经常在别的地方出问题。
三是能不能跑起来
编程智能体能自己打开页面、看到报错,把错误贴回给它就能接着改。对话框里,复制、保存、打开、发现不对、再回去说,每一步都要自己手动完成,一个来回就是一小时。
03
PART
开发过程
PROCESS
先写一段提示词
很多人卡在这一步,觉得提示词得写得很全面,其实不用。下面这段就够开工了,核心就是把你的要求和想法说清楚。当然,你事先想得越清楚,做起来越省事(既省时间,又省token)。
帮我做一个“文档脱敏工具”,交付物是单个 .html 文件,双击用浏览器打开就能用,离线运行,不上传任何数据。
用途:把教学设计、课例、学生作业里的真实姓名、学校名、手机号、邮箱,替换成“教师A”“学生A”这样的匿名名称,同时生成一张“脱敏—原始”对应表,之后能凭对应表把文件还原。
要求:
1. 所有 HTML/CSS/JS 内联在一个文件里,不引任何外部库和 CDN,页面里不能有任何网络请求。
2. 支持拖入 .docx 和 .txt,可以一次选多个。原始文件只读,结果另存为文件下载。
3. .docx 要处理得全一些:正文、表格、页眉页脚、脚注尾注、批注,还有批注和修订的作者、文档属性里的作者、文件名本身。
4. 识别结果先列出来让我核对,能勾选、能改匿名名,别直接替换掉。
5. 页面分四个页签:脱敏、复原、查看对应表、下载结果。界面中文,蓝色系卡片式。
先别写代码。先把功能清单和技术方案列给我,我们对齐之后再开始。
重点
这里要说清楚一件事,不要指望写一个完美提示词,也不要指望一次就把功能想全。功能本身也可以和 AI 共创,更省事的做法是反过来让它先出清单:你先说需求和场景,让它别写代码、先列一版功能和技术方案,你在上面做加减,对齐了再动手。上面提示词的最后一句就是这个意思。
拿真实文件测,用错例喂规则
这一步没有捷径。识别类工具的准确率靠磨,靠一次次测试出来。在测试中,你可能发现“张卡片”被当成姓名、“上海市中小学”这类泛称被当成校名、文献引用“王初明(2015)”里的作者名被误伤,这时一条条反馈回去让它补规则。停用词表里那一长串“张开”“黄色”“高兴”“程序”“任何”,也全是一条条误报攒出来的。
04
PART
一个 HTML 文件能做的事
CAPABILITY
可能很多人对一个网页能干什么的印象,还停留在浏览和展示上。实际上一个不联网的 HTML 文件,已经能完成相当完整的“小工具”功能。
它能读文件,拖进来就能解析,Word、表格、JSON、纯文本都行;能在本地做加工,解析、匹配、替换、计算、统计;能生成文件并下载,文本、表格、图文,甚至打包成压缩包;能记住状态,关掉浏览器再打开,之前的设置还在;最重要的是能离线运行,数据一步都不离开本机。
这几点加起来,日常工作中那些重复、有规则、还带一点隐私的活,基本都能装进去。
不适合的也很明确。需要联网取数据、需要多人协作、数据量大到浏览器扛不住,或者要长期保存大量历史记录的,就不能指望一个 HTML 文件了。
照这个边界去想,能做的工具其实不少。
成绩出来要把分数表做成分析报告,或者按班级拆成几十个文件分别发给班主任,可以做;一份名单要随机分成小组、还要保证各组人数均衡,可以做;排值班表、排监考表,让程序按规则自动轮转并检查冲突,可以做;教案交上来要检查格式是否齐全、标点是否规范,可以做;试卷的双向细目表要统计各知识点、各能力层级的题量和分值,可以做;一批问卷数据要清洗、去重、算交叉表,可以做;几十张活动照片要统一压缩、加校徽水印再打包,也可以做。
还有一个经常被忽略的用法,把工具本身用 Ctrl+S 存到 U 盘或者共享盘,谁需要谁打开用,不用装环境,不用配权限。做一次,全组人受益。
///
LAST
关于 VibeCoding
EVERYONE IS A PRODUCT MANAGER
AI 时代,人人都是产品经理。很多人没有代码基础,把这件事想得很难,觉得前端、后端、数据库、部署这些词自己一个都不懂。
实际上,你只需要跟 AI 说明自己的想法。上面这个工具,从头到尾没有配过任何环境,也没有写过一行后端代码,所有的判断都发生在“我要它帮我把这个麻烦事解决掉”这一句话上。
做得多了,自然就有经验了。第一次只敢做单 HTML 小工具,但以后,你就能自己判断某个功能该不该加、加了会不会拖慢速度,还可以联动python,开发前后端,增加数据库。“做中学”这四个字,在 VibeCoding 里体现得淋漓尽致。
各位,开干吧!
不管是一个小工具,还是一份交互式学习单,HTML 都能将你的想象变成现实。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING