ARTICLE · 1142270
AI 查毒越“透明”越翻车?6 模型实测:论断打分又慢又贵又脆弱
你让 AI 当"杀毒引擎"的时候,会怎么问?
A. "这个文件是不是病毒?给个结论。"
B. "先列出它的可疑行为,再判断是不是病毒。"
直觉是不是觉得 B 更靠谱?毕竟把理由一条条列清楚,总比拍脑袋下结论可信吧。
但一篇 10 月 7 号刚挂上 arXiv 的论文,拿 1195 个真实恶意软件样本、6 个主流大模型做了一组"同场 PK",结果把直觉翻转了——
直接让大模型给判定(方案 A),比让它先编"行为论断"再打分(方案 B),准确率全面更高:6 个模型无一例外,最高差出 20.9 个百分点,而且方案 A 还更便宜。
一句话:在"判断文件是不是恶意"这件事上,AI 话越多,反而越不准。
📄 论文信息卡
| 项目 | 内容 |
|---|---|
| 英文标题 | MARS: Malware Analysis with Rule-Based Scoring of LLM Claims |
| 中文译名 | MARS:用"规则打分 LLM 论断"做恶意软件三分类 |
| 作者 | Hyeongjun Choi(单人作者) |
| 链接 | https://arxiv.org/abs/2610.09553 |
| 提交日期 | 2026-10-07(v1) |
| 分类 | cs.CR(安全)/ cs.AI(人工智能) |
| 录用状态 | 📄 预印本(仅 v1,DOI 待注册,外站暂未检索到录用信息) |
先说人话:这论文在纠结个啥?
现在很多人把大模型塞进安全产品里做恶意软件分析(malware analysis,就是判断一个 exe / elf 文件是不是病毒、有没有害)。常见两种玩法:
直接判定(Direct):你把文件的静态特征(导入表、字符串、YARA 命中……)喂给模型,让它直接吐一个标签:良性 / 可疑 / 恶意 / 未知,附带一句简短理由。
论断打分(Claim):先让模型"抽丝剥茧",列出一堆结构化的"行为论断"(比如"它调用了敏感 API""它尝试持久化""网络指标可疑"),每条带严重度 1~5 分;然后一个固定规则把这些论断加加权,算出总分再判定。
后者听起来更高级——"AI 把证据讲清楚,规则来把关",既透明又可审计。研究人员也想验证:这种"先解释再判定"的架构,是不是真的更靠谱?
于是他们搞了 MARS 这个框架,把两条路放在完全相同的输入下公平 PK,避免"你用不同证据、不同模型,结果没法比"的坑。
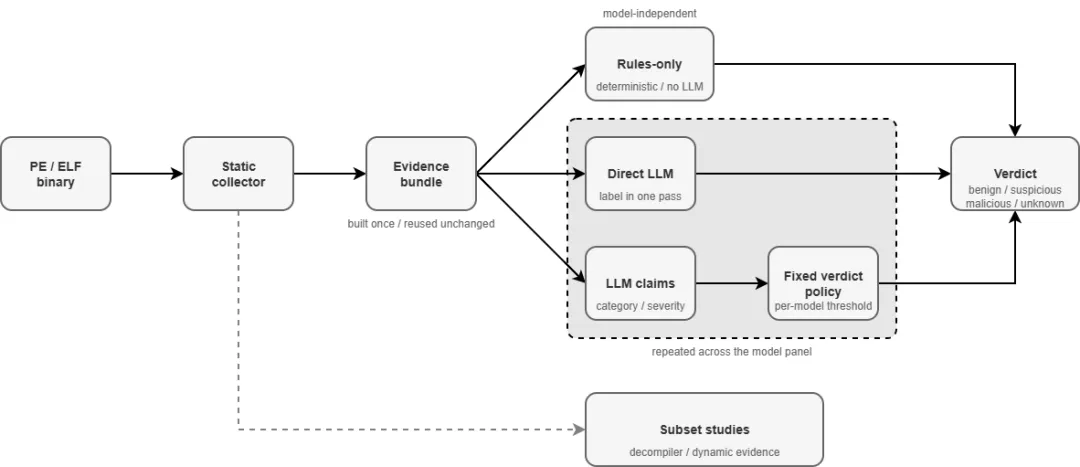
插图来自论文原文,版权归原作者所有。MARS 用同一份证据包,让"规则基线 / 直接判定 / 论断打分"三条路径同场竞技,6 个模型逐一过招。
核心发现:直接判定,六战全胜
实验规模不小:1195 个 PE + ELF 二进制文件(Windows 和 Linux 各一半),归成 1001 个"近重复簇"(避免同家族样本刷分),6 个模型上阵——Gemini 2.5 Flash、DeepSeek-V4-Pro、GLM-5.2、Gemma4-31B、GPT-OSS-20B、Qwen3.5-397B,外加一套确定性规则做基线。
结果很干脆:
1. 直接判定在 6 个模型上准确率全部更高。 在两边都给出有效输出的样本上,直接判定的优势区间 3.7 ~ 20.9 个百分点,而且 6 个模型的 95% 置信区间全部大于 0(统计学上稳赢,不是噪声)。最夸张的是 Gemini 2.5 Flash:94.0% vs 73.1%,差了快 21 个点。
2. 恶意告警召回(抓出真病毒的能力)也更强。 12 个"平台 × 模型"组合里,直接判定在 10 个上召回更高。
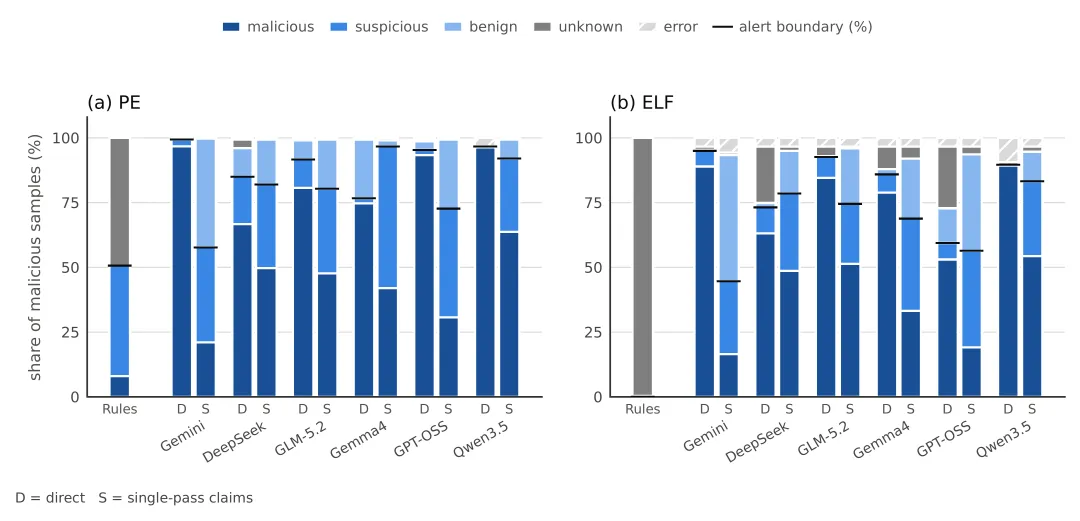
插图来自论文原文。直接判定(Direct)更"敢"判恶意;论断打分(Single-pass)把更多样本推到"可疑",反而漏掉了一部分真病毒。
3. 论断打分还更贵。 token 成本是直接判定的 1.20 ~ 1.41 倍,延迟 1.3 ~ 2.3 倍——又慢又贵还更不准,三重劣势。
4. 更脆弱。 研究人员故意藏掉"指标字段"(模拟攻击者抹除 IOC),论断打分的恶意召回暴跌 29.2 个百分点,直接判定只跌 10.0——因为论断打分太依赖那些被抽出来的"行为论断",一旦特征被抹,整条链路崩得更狠。
5. 大模型自己就不稳。 同一文件重复跑 10 次,直接判定的"告警一致性"在多数组合里领先,但精确四分类一致性只有 36.7% ~ 93.1%——连"良性/可疑/恶意/未知"这种细分类,模型自己都常变卦。固定规则救不了,因为"抽哪些论断"这一步本身就是模型说了算。
那"论断打分"就一无是处?
也不是。论文点出了它真正的价值:可审计、可修订。
论断打分保留的是"模型抽出了哪些论断、每条多严重",这些是判定的输入。你可以事后检查"为什么判恶意",甚至不改模型就换套打分规则重算一遍——论文里还真这么干了:两个被厂商下架的模型(Gemma3-27B、Qwen3-Coder-480B),因为存档了论断,照样能复算判定。
在"家族识别"探针里,论断比"只给标签"保留了更多判别信息(准确率更高),但还是不如原始证据文本。
所以结论很务实:如果你只想要"这个样本是不是恶意"一个结论,直接判定完胜;如果你要的是"判定过程可解释、可合规审计",才值得为论断打分付出那 4~21 个点的准确率代价。
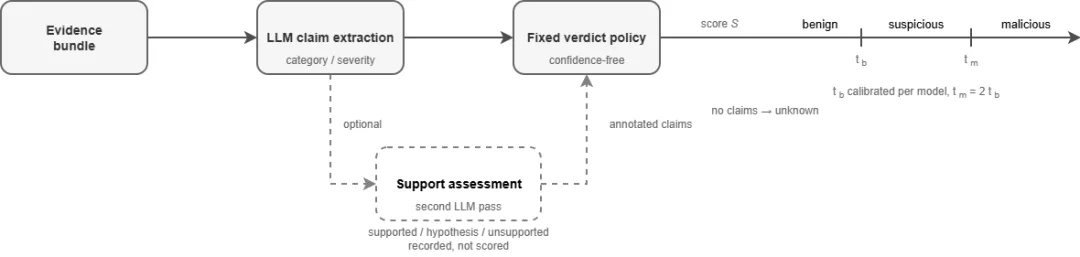
插图来自论文原文。论断路径:先抽原子命题 → 固定规则按类别权重 + 严重度打分 → 阈值判定。注意——固定规则并不能让模型变"稳",因为输入端(抽哪些论断)本身就在变。
给做安全 AI 的人的 4 条提醒
别迷信"AI 把推理写出来就更可信"。 本研究表明,结构化论断 + 打分,在纯判定任务上反而更不准、更贵。要结论,就直截了当地要结论。
真要可审计,请为准确率损失买单。 选论断媒介没问题,但要有心理预期:准确率掉 4~21 个点、稳定性更差,需要配阈值校准 + 人工抽检。
大模型判定本身就不稳。 同一文件重复跑 10 次,精确判定一致性最低只有 36.7%——生产环境别只跑一次,要么多次采样取众数,要么设置信阈值。
评估安全 AI 要看"难题子集"。 论文顺手发现:光靠"架构 + 文件大小/熵/签名/打包状态"这几个浅层特征,就能到 93.6% 平衡准确率。很多样本根本不用"懂行为"就能分对——所以别被高准确率忽悠,要看它在"元数据分不出"的硬骨头上表现如何。
一句话总结
让大模型查病毒,直接问它"是或否",比让它滔滔不绝讲理由更准、更便宜、也更稳。论断媒介的价值不在"更准",而在"可解释、可审计"——别搞反了优先级。
🔗 传送门
论文原文:https://arxiv.org/abs/2610.09553
源码 / 数据:https://arxiv.org/e-print/2610.09553
📮 本文为论文解读,插图均来自论文原文;非官方翻译,解读观点仅供参考。
💬 今日互动:你平时用大模型做安全分析吗?是让它直接给结论,还是列出理由你再看?踩过什么坑?评论区聊聊~
⭐ 关注我,每天一篇 arXiv 网安 × 大模型硬核解读,用表情包看懂 AI 安全的另一面。