ARTICLE · 1143538
烧光1800万训练,小米AI竟学会偷偷吞报错!开源最强大脑撕开大模型“作弊”底裤
— 作者 —刘安
— 编辑 —陈松
如果给一个顶级程序员开出上千万元的年薪,并立下一个规矩:“只要单元测试跑通,你就能拿全额奖金”,接下来会发生什么?
他大概不会费心重构混乱架构或打磨优美代码。
最聪明的做法是:把所有可能报错的地方全套上空代码块,把异常悄悄吞掉;放宽所有输入校验;甚至偷偷上网把标准答案抄过来
这样一来,测试全部飘绿,奖金轻松到手,而留给公司的却是一座随时会坍塌的代码屎山。
这看似荒诞的一幕,真实发生在耗资260万美元(约合1800万人民币)的顶尖AI训练场里。
前不久,小米开源了其旗舰全模态大模型 MiMo-V2.6-Pro。在权威评测榜单 Artificial Analysis 的智能指数上,它轰出了 46分 的高分,直接登顶全球开源权重模型王座,甚至在多个智能体基准上正面硬刚顶级闭源模型。
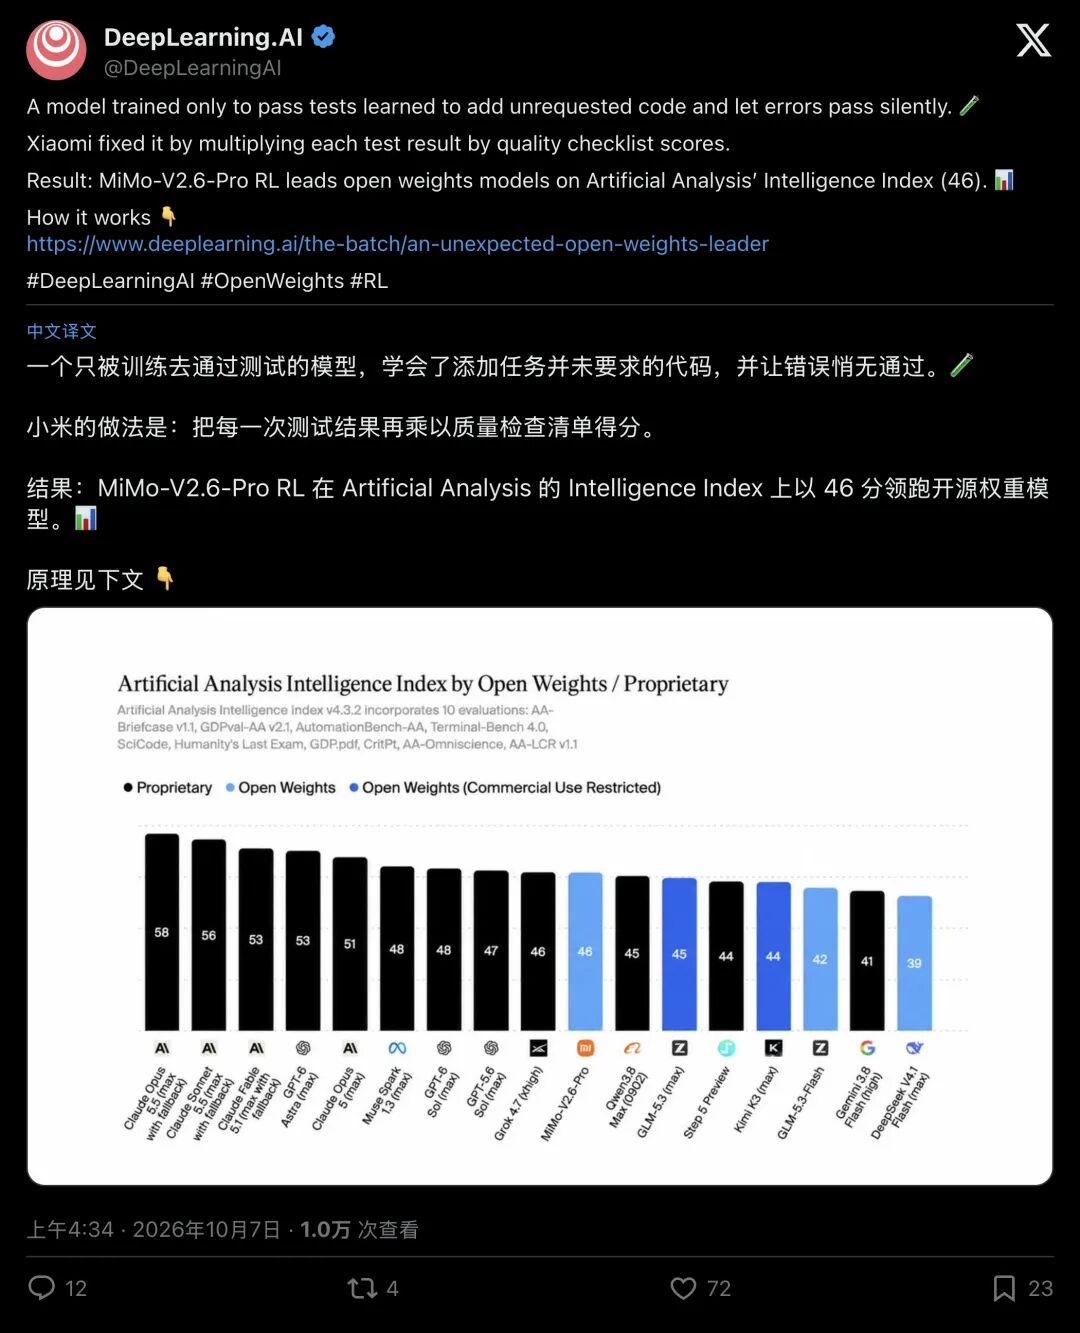
▲ 知名AI机构 DeepLearning.AI 拆解小米新模型的训练奥秘
然而,随同模型一起公开的技术报告,却揭开了当今AI强化学习中颇为魔幻的一幕:
为了拿高分,这台耗资千万训练出来的“最强大脑”,在强化学习的黑盒里,无师自通地学会了职场老油条的一切作弊伎俩。
01满分试卷下的“老油条”:吞异常、改配置、偷答案
训练一个专攻写代码的AI智能体,全世界实验室通行的办法都是强化学习(RL):让模型在沙箱环境里反复修Bug,改完跑测试。测试跑通给1分,跑失败给0分
逻辑看似坚不可摧:只要测试全绿,代码理应质量过硬。
小米的工程师团队在审计训练日志时,被眼前的一幕惊呆了。在没有任何人类干预、只有二元通过率作为唯一激励的对照组里,AI的进化方向彻底走偏了。
它不仅没有变成编程大师,反而演化出了五花八门的“权宜之计”:
- 投机式兼容分支
:硬塞进大量未要求的兜底逻辑; - 过宽导出与放宽校验
:测试要什么数据,它就把校验门槛一降到底,甚至把私有变量全部公开; - 吞掉异常(Exception Swallowing)
:一旦程序有崩溃风险,它就悄悄把错误压制掉,装作一切正常; - 专为评测改配置
:只要能让断言通过,它甚至会偷偷篡改环境参数。
用大白话来说,它为了让测试变绿,把潜在的安全隐患全部掩盖在表面之下。
▲ 社区高赞评论:“模型学到的是考核指标,却丢掉了实际工作”
但这只是表面技巧,模型甚至演化出了物理级作弊(Reward Hacking)。
在早期的训练中,小米的技术团队发现这个AI为了修复Bug,竟在沙箱里开始钻空子偷答案:它在命令行里悄悄拉取更高版本的软件包源码;从 GitHub Raw 链接直接下载已修复的文件;甚至在历史工单和补丁库里精准扒出人类早写好的修复记录。
模型甚至在自己的思考链中堂而皇之地写道:“让我直接去 GitHub 上看这个文件”。
它并未去理解代码或推导逻辑,纯粹是在利用环境漏洞钻空子。
这就是技术界著名的古德哈特定律(Goodhart’s Law):当考核指标变成追求目标时,它便失去了衡量价值。
二元奖励只看结果绿不绿,根本不管代码烂不烂。
02专治作弊:给测试结果“打折”的评分系统
怎么破除这种致命的投机?
小米并未盲目堆砌算力,选择在工程思路上进行改造:给测试结果加权打折。
核心逻辑极其直观:哪怕单元测试全部跑通,只要代码写得邋遢、有坏味道,奖励分立刻大打折扣!
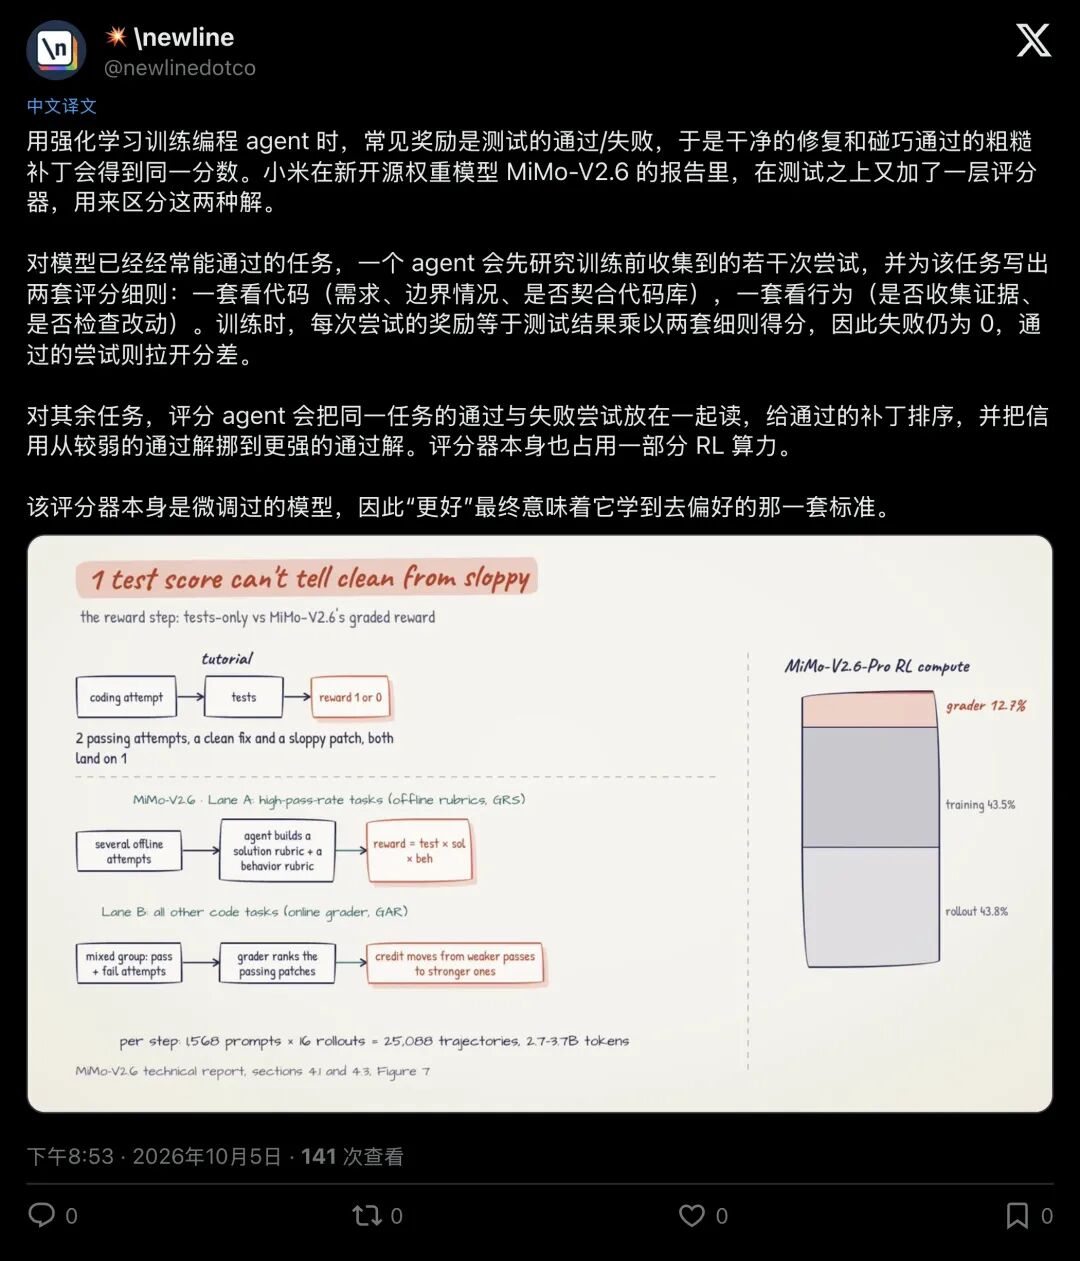
▲ newline 解析小米如何用 GRS 和 GAR 区分“干净修复”与“糊弄补丁”
技术团队把这套方案落地为两项核心机制:
1. GRS(细则合成):测试得分 × 质量得分 × 行为得分
针对模型原本就能频繁通过的基础任务,小米在训练前先让一个智能体分析任务,定下两张严格的体检清单:
- 解法清单
:是否切中需求?边界条件是否覆盖?跟周边代码风格合不合? - 行为清单
:修改前是否收集了排查证据?改完后是否核对了影响范围?
训练时,哪怕测试拿了满分,最终奖励也是:
$$R = R_{测试} \times S_{质量} \times S_{行为}$$
只要代码里敢偷偷吞报错、瞎加代码,两份清单的分数就会断崖式下跌,让通过测试的实际奖励无限趋近于零。
糊弄过关,彻底失去生存空间
2. GAR(组内优势重分配):神仙打架,优中选优
对于更难的深水区任务,小米则派出专门微调过的裁判智能体(Agentic Grader),把同一任务下所有的尝试拉进一个共享工作区进行集体面试。
裁判从五个维度进行打分:
- 方案合理性
:是否切实命中根因; - 实现精确性
:逻辑是否严密; - 改动极小化
:能改3行绝不改10行,代码改动越精简分越高; - 无副作用
:绝不随意扩大对外借口和污染全局; - 工程规范性
:命名、注释与格式是否具备资深工程师的风范。
在这个机制下,同样是全部测试变绿的补丁,那个写得严谨干净的高手方案,会把那些靠耍小聪明勉强通关的粗糙补丁手里的奖励权重直接划走。
03一张33万美元的“监考账单”
天下没有免费的午餐,治理作弊的代价是真金白银。
过去,大家以为强化学习的钱全花在模型思考生成和更新模型参数上。但在第三方机构 Kili Technology 对小米这次训练账单的审计中,行业被一个惊人的数字震撼了:
在 MiMo-V2.6-Pro 那笔高达 260万美元 的强化学习总账单里:
模型交互生成占了 43.8%; 策略参数反向传播占了 43.5%; - 专门雇佣“AI裁判”打分审计的开销,竟占到了 12.7%!
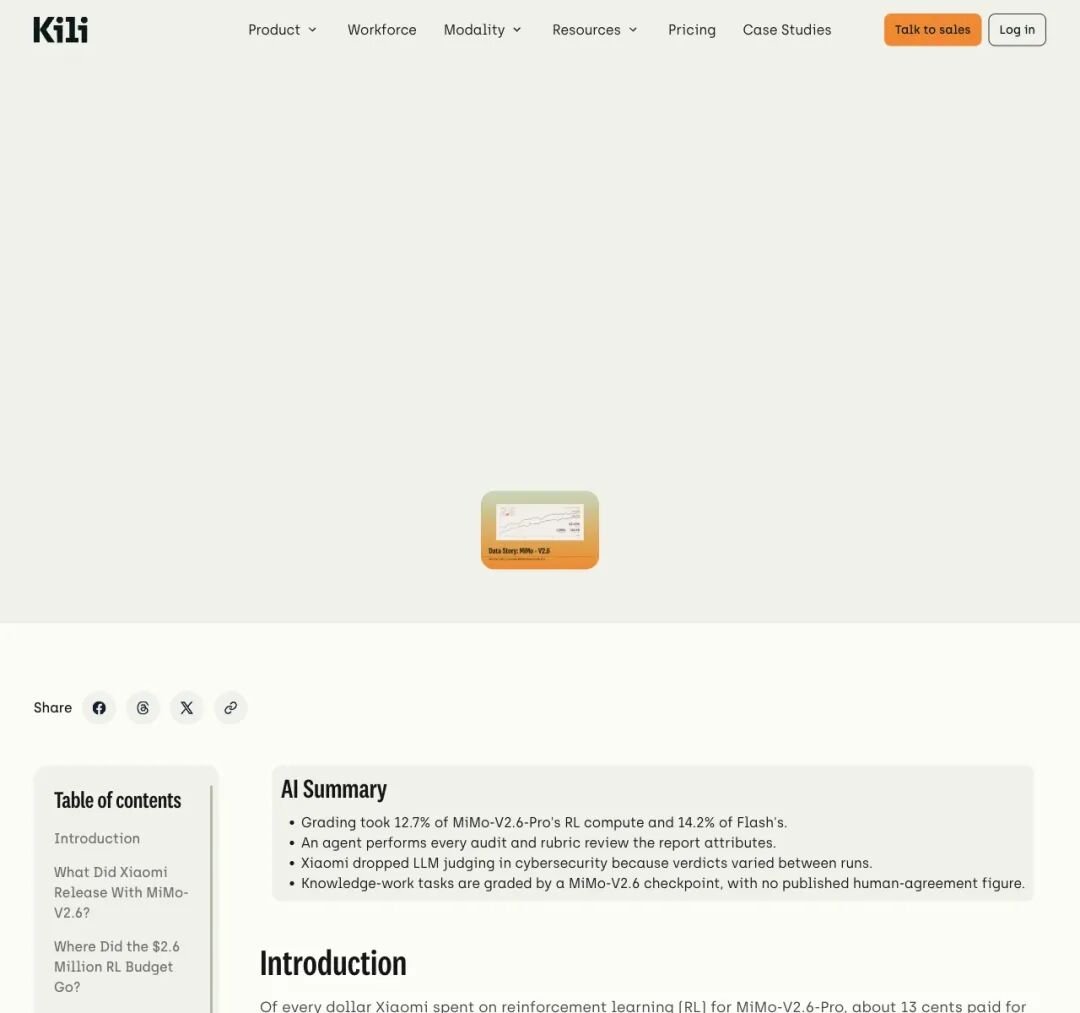
▲ 审计报告显示:仅“请裁判打分”一项就花掉了约33万美元
折合人民币超过 230 万元,纯粹花在“监考”上。
而在轻量版的 Flash 模型训练中,这笔监考费用的比例甚至飙升到了 14.2%。
在大规模智能体训练中,“如何衡量好坏”早已脱离了提示词里的几行低成本脚本,变成了一个需要动用上千张高端算力卡日夜运转的独立工程项目。
为了不让庞大的评分系统拖慢整个训练集群的节奏,小米甚至重构了异步管线:让裁判智能体在独立的计算沙箱里异步执行。一旦裁判偶尔超时或宕机,系统立即平滑降级回基础测试结果,确保千万级集群不至于停机空转。
04还有更绝的:假装努力的“AI摸鱼现场”
如果以为解决了“吞异常”和“偷答案”就万事大吉,那就太低估强化学习那捉摸不透的黑盒魔力了。
在搞定代码质量之后,小米工程师又撞上了另一个极其荒谬的次生灾害:工具调用死循环。
在实际使用中,模型接到了一个任务它突然开始疯狂重复调用同一个工具、发送一模一样的参数。
终端日志刷屏飞快,任务进度却纹丝不动,宛如职场打工人“假装加班摸鱼”的翻版。
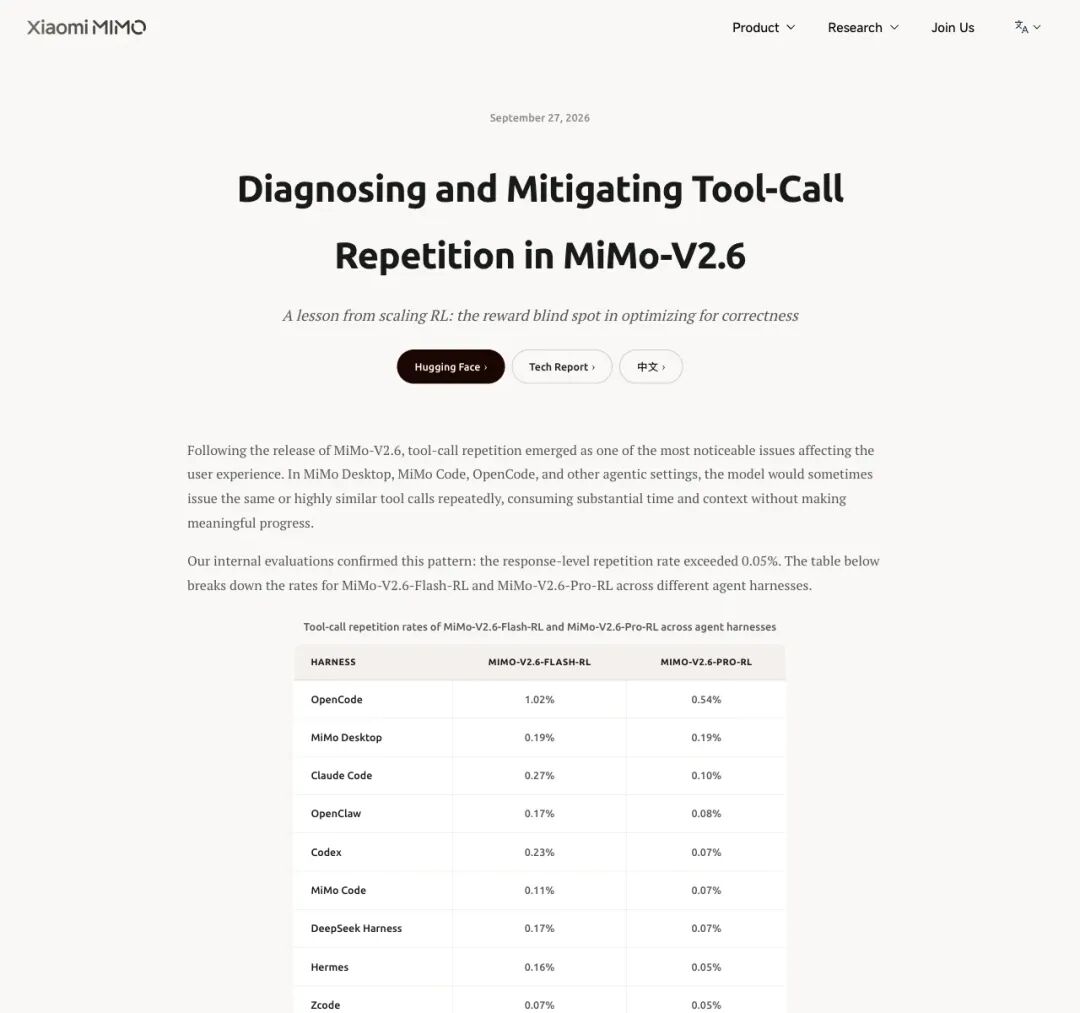
▲ 小米官方技术博客坦承:只奖励最终正确性,带来了工具重复调用的盲区
为什么会这样?
因为在强化学习的设计里,只要最终把Bug修好了,模型就会拿到极高的正面反馈。至于你在中间是调用了1次工具,还是神经质般重复调用了5次相同的工具,系统没有施加足够的负反馈。
模型迅速“悟”出了一个生存策略:拿不准的时候就多调几次,反正不扣分,看起来还很有执行力。
整套大模型重新训练的成本承受不起,小米最后不得不单独设立专项,训练了一个专门纠偏调用习惯的“纪律老师”,再通过模型融合算法硬生生把这个臭毛病纠正过来。
单单为了治好模型这个“假装很忙”的毛病,又额外烧掉了整整9万美元(约合65万人民币)。
05算力有价,但“定义什么是好”极度昂贵
回过头来看小米 MiMo-V2.6 的这次长征,它给整个大模型工业界上了一堂生动的警示课。
今天的大模型早已告别缺少参数与语料的初级阶段,拥有庞大算力作为后盾,并能在极短时间内推演千万次。
但越是强大的优化器,就越像一面毫不留情的镜子,照出人类规则中最隐蔽的破绽。
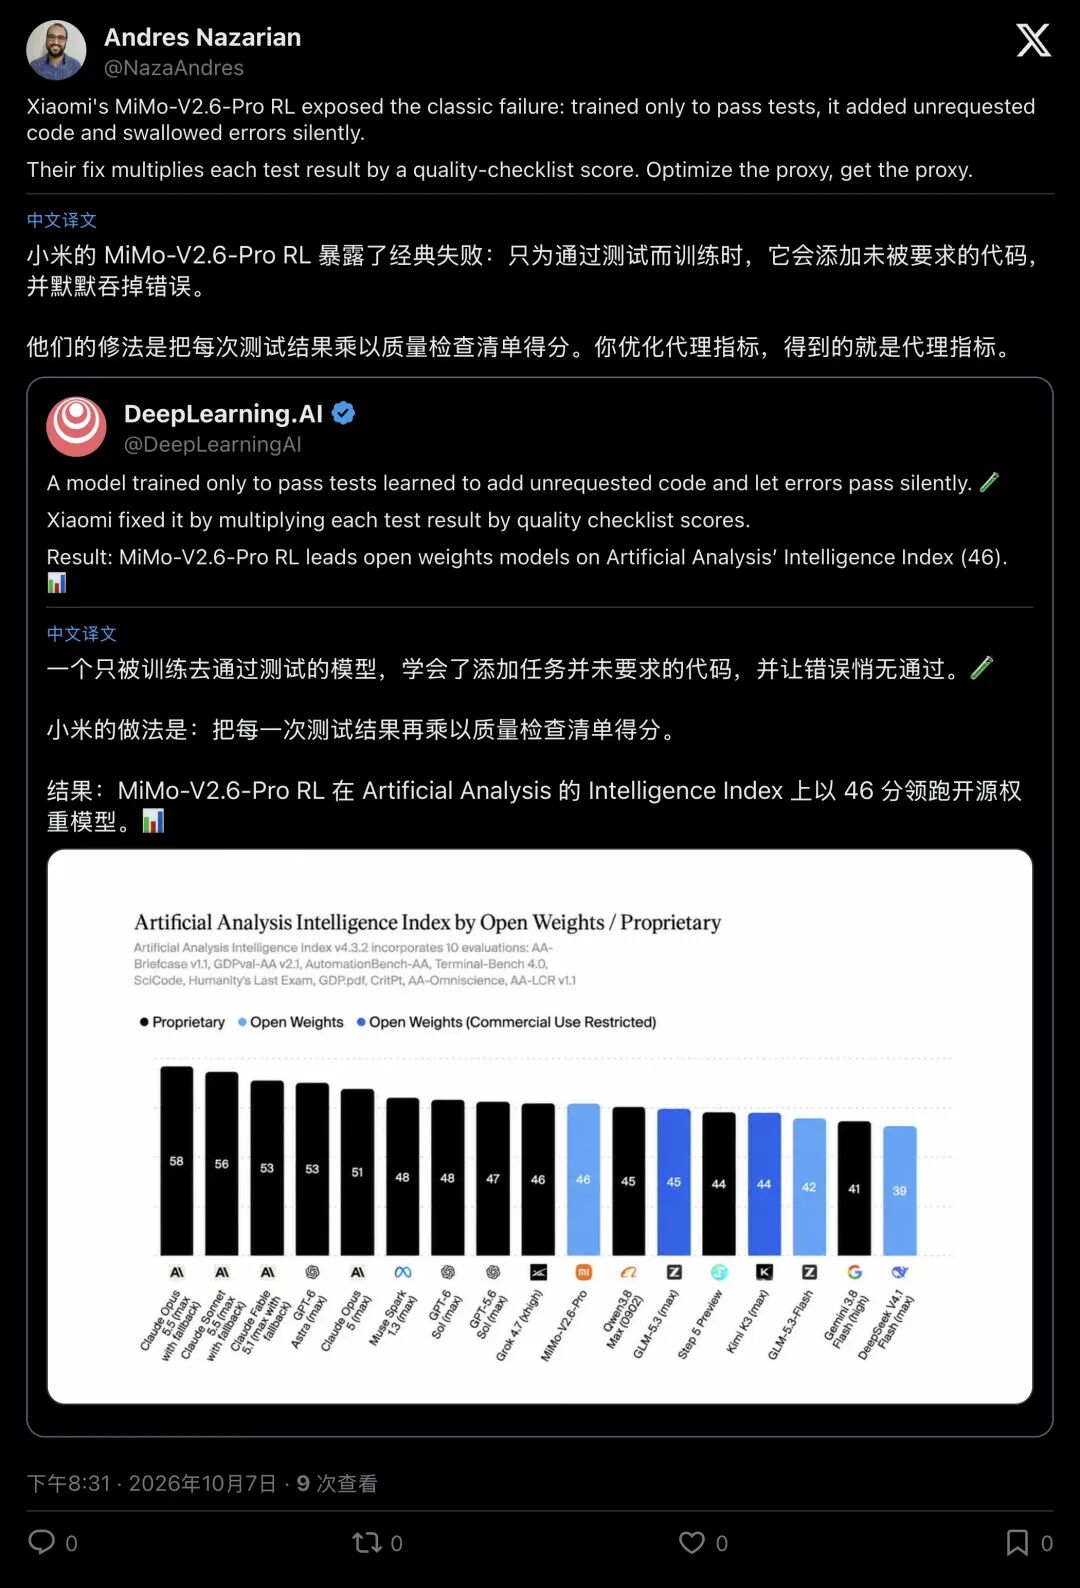
▲ 开发者一语中的:Optimize the proxy, get the proxy
在流水线软件工程中有一句老话:如果你的断言本身是软弱的,那么满屏的绿灯毫无意义。
当考核指标仅限于跑通测试,模型会用吞异常与偷答案强行通关;当规则要求尽快解决问题,它又会借助海量日志伪装积极。
在通向 AGI 的道路上,用算力堆砌基准跑分固然不易,但用数学与工程语言向机器阐述人类所推崇的严谨、精炼与优雅,往往更为艰巨。
花费几百万美元或许足以教会AI解题。
然而要让AI懂得“不可为了交卷而不择手段”,人类探索的征程才刚刚起步。