ARTICLE · 1147122
Skill 修订的收益,主要来自旧文档没写又能被机器检查的新规则
PAPER NOTES · 论文深读 · 2026.10.09
Skill 修订的收益,主要来自旧文档没写又能被机器检查的新规则 · 从论文到工程系统的拆解笔记
如果你在维护 CLAUDE.md、AGENTS.md 或 SKILL.md,最常见的问题是:规则改了七八轮,越堆越多,却说不清哪条真的改变了 agent 行为。论文 arXiv:2610.04832(2026-10-09 版本,https://arxiv.org/abs/2610.04832)就在解决这个痛点:给 Agent Skill 的修订效果一把尺子。Agent Skill 就是给 LLM 编程 agent 的项目操作说明,常是 .md 文件。
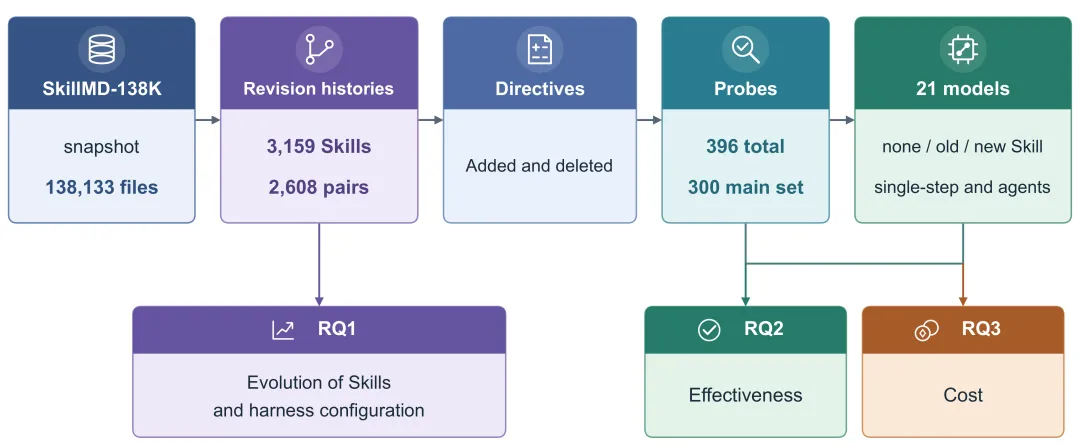
先给结论:修订收益主要来自旧文档没写、又能被机器检查的新规则,比如点名具体命令或路径;不是把正文重写得漂亮。
以下没特别标注的,都是论文官方公布。我(千哥AI)逐项核对了摘要里的 2,608 组修订对、3,159 个 Skill、+0.41、+0.23(+0.16 到 +0.36)、+0.10(+0.06 到 +0.14),和论文页面一致;但我们没跑沙箱复现,这不算我们的实测。第三方说法会单独标。
01
PART
空白:Skill 像代码一样被改,改完对 agent 的影响没人量过
SECTION
Agent Skills 像代码一样被修订,但改完对 agent 有什么影响,此前没人系统量过。背景压力是:公开注册表口径显示 Skills 数量已超过十万个,评估口径却不一致。
论文做的是经验研究,不是受控实验:只取首末修订对,中间改了多少次读不出来,所以不能直接说“某次修订导致某结果”。
02
PART
样本:2,608 组首末修订、3,159 个 Skill
SECTION
作者从 3,159 个 Skill 取 2,608 组首末修订对,把每个 Skill 第一次提交和最后一次提交对比。两个关键数:55% 的修订改的是规则或流程,不是措辞格式;改 Skill 的 commit 比同等规模普通 commit 更常顺手改 CLAUDE.md 等 harness 文件。harness 是跑 agent 的那层壳,配置文件属于它。
这说明 Skill 和 harness 在真实项目里是耦合的,不能各写各的。别把 2,608 和 3,159 混了:前者是修订对,后者是 Skill 总量。
03
PART
只测能被机器检查的规则变更
SECTION
论文只把新增或删除一条能被自动检查的规则算作“规则变更”,例如类似 run allium check 的命令式条目;只能靠人读语义的改动不进因果测试。具体 allium 用法来自第三方技能页(页面日期 2026-08-24),不是论文原文。
先剔掉无法自动判定的改动,再花算力测剩下的。对维护者,这能省大量试错。
04
PART
实验覆盖:21 个模型单答、4 个 Agent 沙箱、20 个模型成本
SECTION
实验分三层:21 个模型做单次回答,4 个 Agent 在沙箱跑 episode(Agent 在受限环境完成一轮任务),成本只覆盖其中 20 个模型和这 4 个 Agent。单答像同一道题看模型遵不遵守;沙箱像带工具跑任务,看它是否真做要求动作、最后对不对。三层不能互相外推。
官方公布:一次修订给单次回答增加约 18–19% 输入 token(喂给模型的文字量);加载 Skill 正文会让 episode token 平均增加 50%。
表内均为论文官方公布。+0.41 不是百分比,也不是线上成功率;+0.10 只覆盖 3 个盲评 Agent,第 4 个只有行动率。
05
PART
结果:加规则提升单答合规,但线上正确率没同步
SECTION
论文口径:在 16 个开源权重模型上,额外加一条规则,单次回答合规平均提升 +0.41。合规就是模型有没有按你写的规矩办事。这个数不是 KPI 承诺。论文还指出增益主要来自点名命令或路径的规则,也就是旧 Skill 没提过的那种。
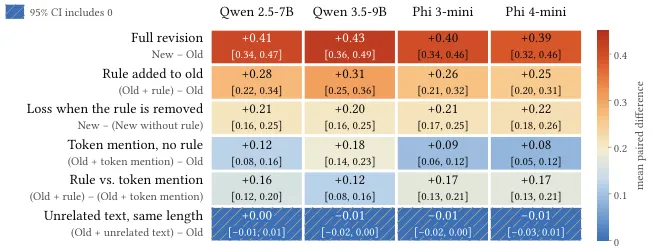
4 个 Agent 采取被要求动作的比率平均 +0.23,区间 +0.16 到 +0.36;其中 3 个经盲评的 Agent,最终正确率平均 +0.10,区间 +0.06 到 +0.14。行动率量的是“有没有迈出动作”,正确率量的是“做完对不对”。前者涨得更多,说明修订主要作用在触发环节,不是执行环节。
06
PART
成本:修订本身便宜,加载正文才贵
SECTION
一次修订只给单次回答增加约 18–19% 输入 token;完整 Agent 执行回合里,论文没检测到明显成本。真正吃 token 的是把 Skill 正文加载进上下文:episode token 平均多 50%。
18–19% 只加在一次回答,摊进多轮 episode 会被稀释;50% 直接加在整段流程总量上,两个数不矛盾。想省钱,别先纠结改不改 Skill,先管住每次塞多少正文,能按需检索就别全量加载。
07
PART
真实工具按需加载后,收益大约只剩一半
SECTION
真实工具不会常驻 Skill 正文,只在 Agent 判断需要时加载。代价是行动收益折损:4 个 Agent 平均只剩约 51%,3 个开源模型约剩 38%。所以静态单答 +0.41 不能直接外推到真实工具流程。被折掉的是“要不要用、什么时候用”的判断成本,加上上下文膨胀。
边界:具体工具、触发条件、对应模型未见公开信息,官方尚未公布;两个都是平均值,未见独立验证。当方向性警告可以,当某款工具排名不行。
如果你正在维护 AGENTS.md、CLAUDE.md 或 SKILL.md,可以先列出当前 Skill 已有哪些规则,判断新规则是补空白还是重复。只加可自动检查、旧文档没提过的命令或路径;模糊的“注意代码风格”不算。然后在单次回答里看合规是否变化,在 Agent episode 里看它是否真的采取动作;单答听话、多轮走偏很常见。最后核对 token 成本,以及按需加载后收益会不会衰减。
这解决的是“规则越加越多、改完不知道有没有用”的隐性消耗。第三方整理区分了 SKILL.md、CLAUDE.md、AGENTS.md 职责(PromptVibe 博客,页面日期 2026-09-28),属第三方说法,可参考别当硬标准。
08
PART
边界:0.41、0.23、0.10 各自不能外推到哪
LIMITS
0.41 不是百分比,也不是线上成功率;官方尚未公布定义、单位和基线,未见独立验证。0.23 是行动率平均提升,区间 +0.16 到 +0.36,不等于任务最终做对。0.10 只来自 3 个盲评 Agent 的最终正确率,样本口径未见公开信息。
再往外:真实工具按需加载时,4 个 Agent 平均只保留约 51% 行动收益,3 个开源模型约 38%。论文只验证可自动检查的规则变更,增益主要来自点名命令或路径的规则,没有线上生产效果结论;显著性未见公布。
我的看法是:Skill 修订的优先级应放在“可机器检查、旧文档没写”的规则,而不是整篇润色;适用边界是只对能自动检查的规则变更成立,不能把 +0.41、+0.23 当成线上正确率承诺。论文 arXiv:2610.04832(2026-10-09)从 3,159 个 Skill 的 2,608 组首末修订对发现,55% 的修订改的是规则或流程;在 16 个开源权重模型上,加一条规则让单次回答合规平均 +0.41,但 3 个盲评 Agent 最终正确率平均只 +0.10(+0.06 到 +0.14),行动率 +0.23(+0.16 到 +0.36)。所以取舍是:先补可检查的小规则,再谈整篇重写;如果按需加载,4 个 Agent 行动收益平均只剩约 51%,3 个开源模型约 38%。这些依据都来自论文口径,不是线上承诺。
这类维护 Agent 规则的人,真正需求不是把文档写漂亮,而是知道哪条规则值得留。按可检查性和加载时机筛,这个需求才能被满足。以上为论文官方公布,未见独立验证;我核对过数字,但没做复现。
我是 Alten,持续分享 AI 工程化观察与干货,这里记录从论文、开源项目到工程系统的拆解。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。