ARTICLE · 1149622
为什么大模型读长文档一定要先切块?一文搞懂Chunking的真相!
我是老九,一个一直在一线折腾技术和AI的人。我习惯留意一些看着很先进,但放到工作和生活里付出不小代价的事。欢迎关注我!
不要错过文章最后的总结图呦!
当前章节:第四章|上下文窗口与记忆机制:AI到底能记住多少?
当前小节:第七节|上下文不够长,工程上怎么办?
本篇知识点:chunking
长文档不能全塞进Prompt,做文档问答会碰到另一个问题:这份几百页的文档怎么搜?
开始做的时候,文档解析成文本存起来,用户提问拿问题和文档做匹配。小文件还凑合,换成两三百页的设备手册,问题就来了。
用户问:“设备温度超过80℃后怎么处理?”
有用的内容在第167页,一小段:温度超过阈值后停止当前任务,检查散热模块和风扇状态……
系统里是整本手册,设备介绍、安装步骤、接口参数、日常维护、故障代码,在一个大文本里。从这么大一坨文字里找到那几句话,并不好用。后来文档拆了,这就是 chunking。
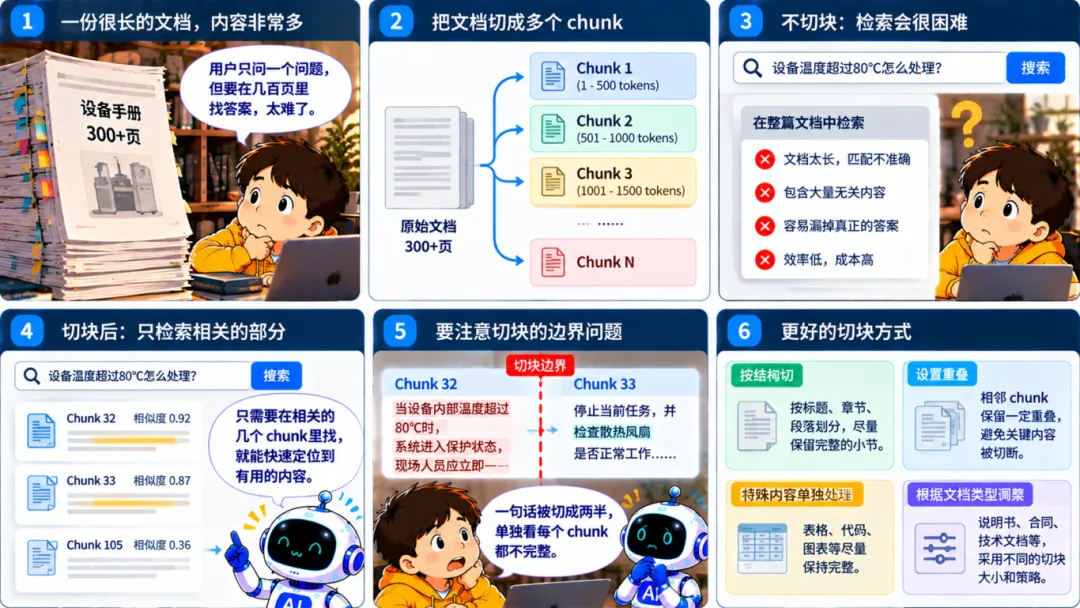
第一次切的时候没想太复杂,按长度来。比如每500个Token切一段:
原始文档
chunk 1:1~500
chunk 2:501~1000
chunk 3:1001~1500
chunk 4:1501~2000
……
一份几十万Token的大文档变成几百个小块。
再问“温度超过80℃怎么处理”,系统只要从这些chunk里找和问题接近的。
很快又踩了个坑,有句话刚好落在切块边界:
chunk 32: 当设备内部温度超过80℃时, 系统进入保护状态,现场人员应立即——
chunk 33: 停止当前任务,并检查散热风扇 是否正常工作……
看chunk 32,话没说完。看chunk 33,不知道为什么停止任务。检索时它们两个独立的块。
“切成小块”没想象中那么机械。切在哪里会影响能不能搜到完整的信息。
试了很常见的办法:切块的时候留一点重叠。
比如前个chunk最后的几十个Token,在下个chunk再保留一次。刚好卡在边界上的不至于被劈成两半。
处理说明书先看它本身有没有结构,像这种:
3.2 安装
3.3 参数设置
4.1 日常维护
4.2 温度异常
4.3 网络异常
标题和段落很清楚,在“4.2 温度异常”中间来一刀不太合适。宁愿让chunk大小不那么整齐,也尽量把一个完整的小节留在一起。
chunking,一般先看文档是什么东西,说明书有章节、合同有条款、技术文档有标题和代码块、论文里有段落、公式和表格。
这些切坏了,检索算法没问题,拿回来的内容也可能缺胳膊少腿。
一个chunk十几页内容,上下关系保住了,检索时又那个问题:有用的两句话埋在一大段无关文字里。
这个参数也不会存在一个固定答案,有的文档30~500 Token 挺合适,有的需要更大。代码、表格、说明书、聊天记录,也不应该非用同一种切法。
标题尽量保留,正文按段落拆,前后留了一点overlap,表格单独处理。
到这里文档还没给模型,只是被切成很多块,等着下一步去找。
如果你读着还行,欢迎点赞收藏关注;如果有不同的观点,也欢迎大家留言讨论。