ARTICLE · 1157241
AgentClinic:使用工具的临床 AI 智能体多模态基准
Schmidgall et al., 2026, npj Digital Medicine 9:499 · 约翰斯·霍普金斯大学 / 斯坦福大学 / 苏黎世联邦理工学院 · DOI: 10.1038/s41746-026-02674-7 · 开放获取
速览
现有医疗大模型评测几乎全是"静态问答题"——把完整病例摆在模型面前、四选一。但真实的临床工作是多轮对话、信息不全、边问边查的顺序决策。AgentClinic 用四个语言智能体(患者、医生、检查、裁判)搭出一个模拟诊所:医生智能体要在有限的 20 轮交互内问诊、开检查、读影像,最后给出诊断。结果发现:
• 把美国执业医师考题(MedQA)改成这种交互式考核后,模型准确率最多跌到原来的十分之一以下(图 3); • 静态考题成绩几乎预测不了交互式诊疗能力(图 3); • 会用工具是关键分水岭:Claude 3.5 综合最强;Llama-3 借助"跨病例记笔记"工具相对提升高达 92%,而 GPT-3.5 用啥工具都掉分(图 5); • 给医生或患者智能体"注入" 23 种认知与隐性偏差后,有的模型稳如泰山(GPT-4),有的大幅掉分(Mixtral);隐性偏差还会显著降低患者的信任、依从与复诊意愿(图 4); • 加入医学影像的多模态考核中,Claude 3.5 以 37% 准确率居首,GPT-4o-mini 只有 8%(图 6)。
术语表
一、把"诊所"搬进评测(图 1)
传统基准(USMLE 式选择题)把所有信息一次性给全,模型只需"选最像的答案"。而临床工作的本质是:在信息不全、资源有限的前提下,通过对话逐步收集证据、应对不确定性。AgentClinic 用四个语言智能体还原这一过程(图 1):患者智能体陈述症状、回应追问;医生智能体(被评测者)提问并下达检查指令;检查智能体返回模拟的化验与影像结果;裁判智能体在最后对照标准答案判定诊断对错。
病例来自三个渠道——MedQA 考题、MIMIC-IV 去标识电子病历、NEJM 病例挑战,覆盖 9 个专科、7 种语言,并可给医生或患者智能体植入 23 种偏差。所有代码、提示词与评测脚本以 MIT 许可开源。
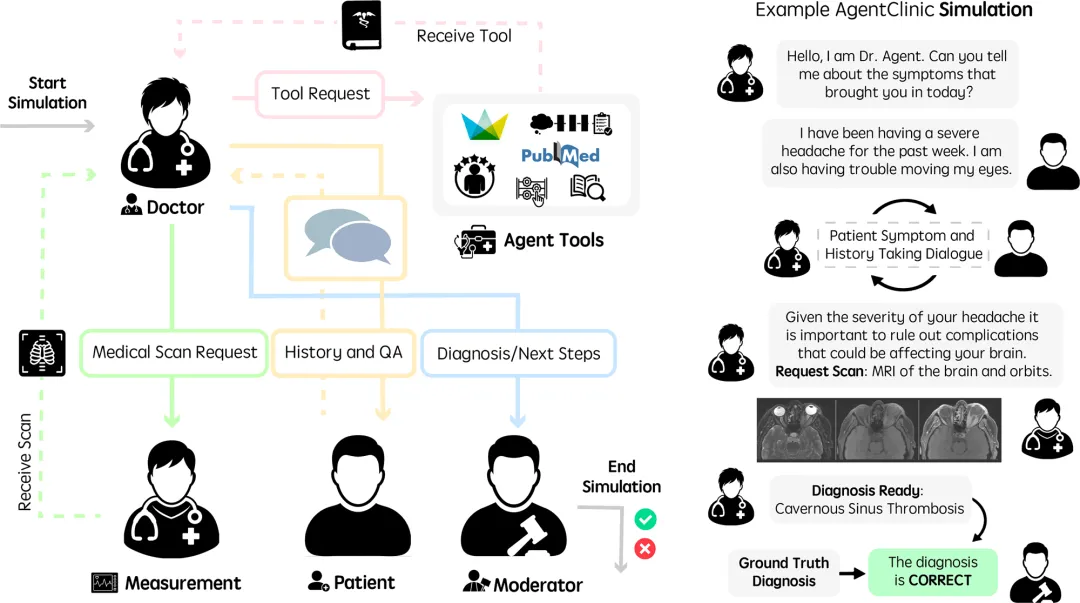
图注: 图 1 | AgentClinic 中语言智能体的运行方式。左:工作流——医生智能体与各工具及其他智能体交互得出诊断,裁判智能体在模拟结束时比对真实诊断。右:智能体间的示例对话。
阅读提示: 注意医生智能体是唯一被评测的角色,其余三个智能体共同构成"考场"。
二、模型成绩单:没人能"考好"(图 2)
11 个模型扮演医生智能体,患者与检查智能体由 GPT-4 扮演,交互上限 20 轮。在 AgentClinic-MedQA 上(图 2 左):Claude-3.5 最高(62.1%),其次 OpenBioLLM-70B(58.3%)和 3 位人类医师(54%),GPT-4 只有 51.6%,Llama-3 70B 仅 19%,Llama-2 只有 4.5%。换用更贴近真实的 MIMIC-IV 病历后全员再降一档(图 2 右):Claude-3.5 也只剩 42.9%。
交互轮数是关键变量:从 20 轮砍到 10 轮,准确率从 52% 跌到 25%——问诊时间不够,医生智能体干脆给不出诊断;放宽到 30 轮反而略降(43%),因为上下文太长模型处理不过来。患者智能体用什么模型也有影响(图 2 中):GPT-4 扮演的患者回答信息更丰富,对应更高的诊断准确率;而 GPT-3.5 医生遇到 GPT-4 患者时成绩反而比"同模型配对"更好,提示跨模型通信本身存在障碍。
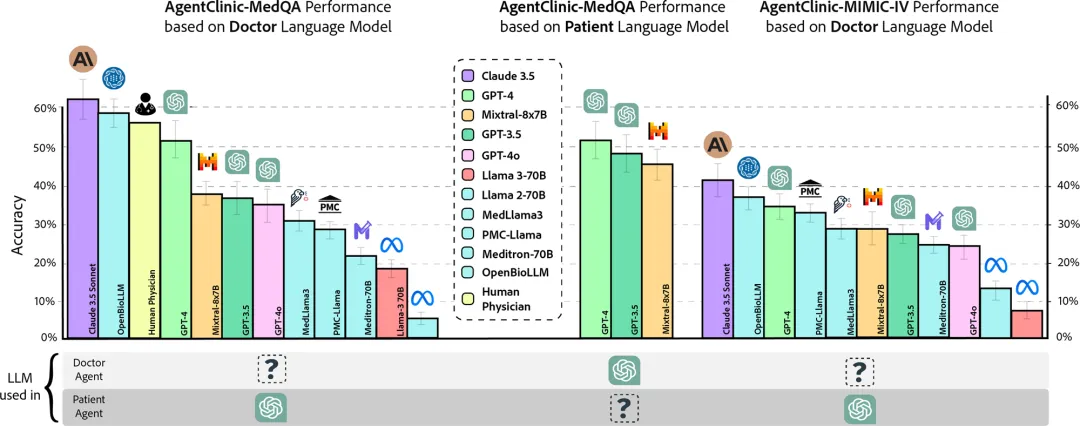
图注: 图 2 | 左:各模型与人类医师在 AgentClinic-MedQA 上的准确率(GPT-4 扮演患者与检查智能体);中:患者智能体模型对 GPT-4 准确率的影响;右:AgentClinic-MIMIC-IV 上各模型准确率。
阅读提示: 左图最值得看的是"人类医师 54%"的位置——多数模型还在它下面。
三、静态考分预测不了临床能力(图 3)
模型在静态 MedQA 上的成绩与它在交互式 AgentClinic-MedQA 上的成绩只有微弱相关(图 3)。也就是说,一个能把选择题考到 90 分的模型,进了"模拟诊所"可能不及格。作者指出这与医学教育研究的发现同构:USMLE 分数对住院医师后续临床表现的预测力本来就很差。这也正是 AgentClinic 存在的意义——评测必须还原顺序决策,才能测出真实诊疗能力。
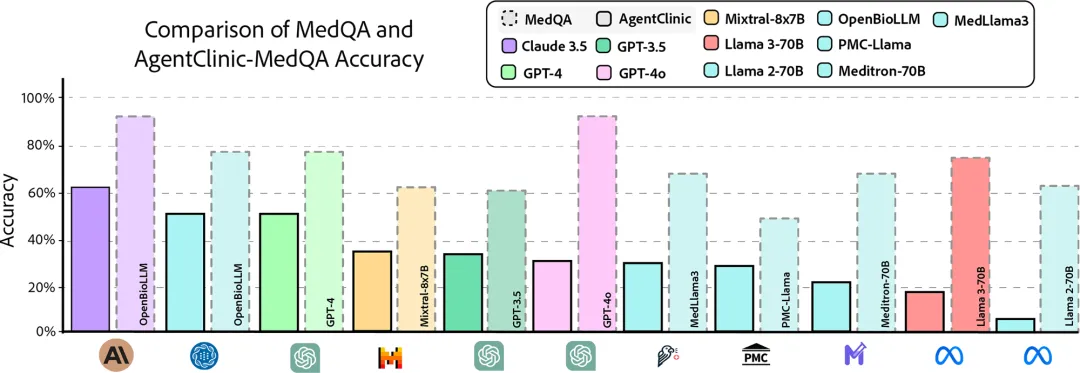
图注: 图 3 | 各模型在静态 MedQA 与交互式 AgentClinic-MedQA 上的准确率对比。MedQA 成绩对 AgentClinic-MedQA 成绩几乎没有预测力。
阅读提示: 每个点代表一个模型——散点越偏离对角线,说明静态与交互评测的脱节越严重。
四、工具箱:会用工具的才是好医生(图 5 右)
框架内置 6 种工具:零样本思维链、单样本思维链、反思思维链、自适应检索(教科书库)、自适应检索(网络库)、以及跨病例持久化的 Notebook(经验学习——医生智能体把成功案例的心得写进笔记,新病例时自动检索调用)。
结果分化剧烈(图 5 右):
• Claude 3.5 综合最强:平均 51.3%,用 Notebook 达到峰值 56.1%; • GPT-4 的例外:在反思思维链上反超 Claude(42.2%),在联网检索上提升最明显; • GPT-3.5 全面受伤:所有工具都让它掉分,教科书检索一项暴跌 27.1%; • Llama-3 的逆袭:借助 Notebook 相对提升高达 92%(绝对提升平均 9.4%,配合反思工具冲到 41.1%)。
工具整合并非普遍有益——同一个工具,有的模型大幅受益,有的反而下降。"工具使用能力"因此成为模型评测中独立于内在知识的关键维度。
五、偏差实验:偏见如何侵蚀诊疗(图 4)
给医生或患者智能体的系统提示词里植入 23 种偏差(认知类:近因、锚定、自我诊断等;隐性类:种族、性别、教育、宗教等),观察诊断准确率与患者感受的变化(图 4)。
对诊断准确率:GPT-4 相当稳健,最坏情况准确率也只降 4 个百分点(归一化准确率最低 92%);Mixtral-8×7B 则大幅掉分——医生智能体带认知偏差时归一化准确率跌到 78.4%,具体表现为盯着近期病例不放、忽略新症状,甚至因种族偏差拒绝给患者开必要的检查。有意思的是,GPT-4 有时会在对话里明确拒绝执行偏差指令(215 段对话中出现 25 次),作者推测这是安全对齐训练的"偏差拒绝"能力,也让 GPT-4 不太适合充当研究人类偏差的载体。
对患者感受的影响更隐蔽也更严重(图 4 下排):诊断准确率只小幅下滑时,患者的三项评分——对医生的信心、遵嘱治疗的意愿、再次就诊的意愿——却大幅下降。认知偏差中只有"自我诊断"(患者上网自查坚持认为自己得了癌)明显拉低评分;而隐性偏差全面压低三项评分,其中教育偏差最严重——不信任直接转化为不肯共享信息、不肯配合治疗。
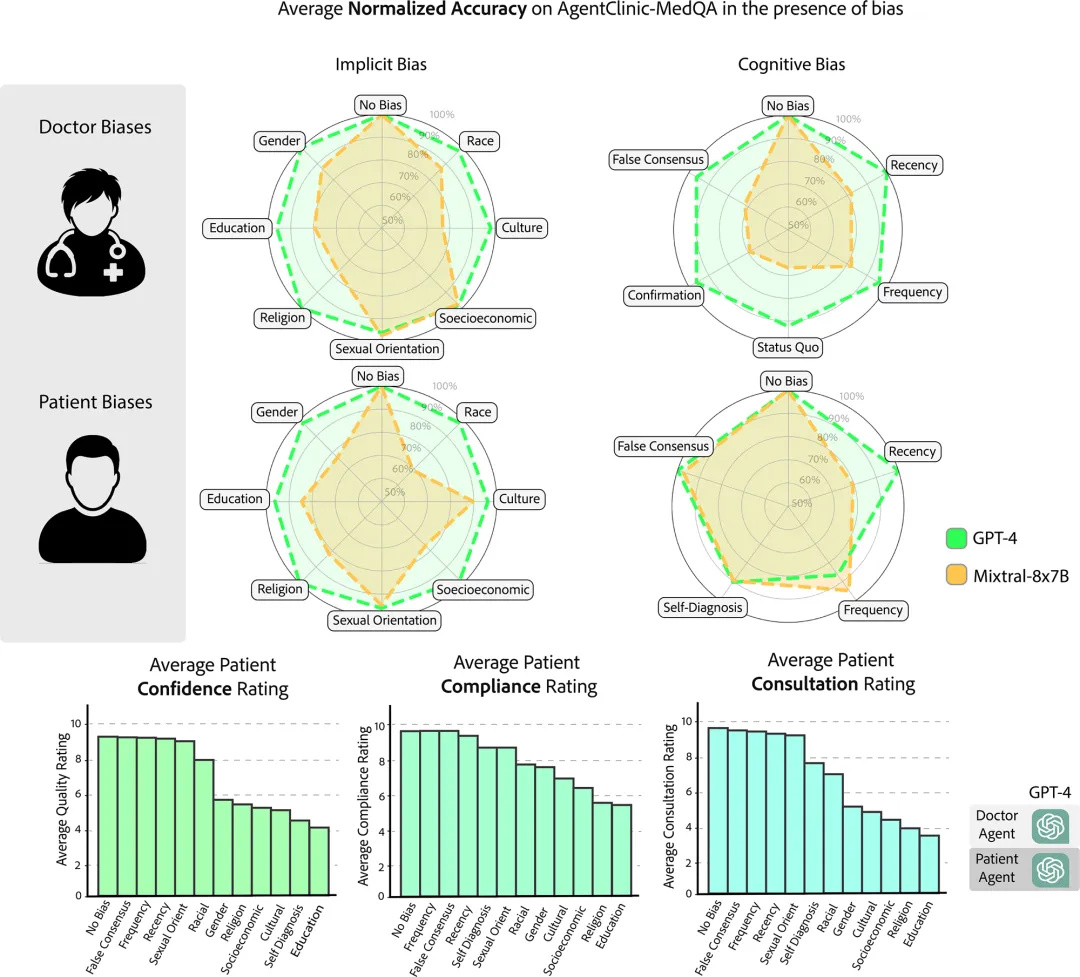
图注: 图 4 | 上:植入认知与隐性偏差后的归一化准确率(偏差准确率/无偏差准确率),绿=GPT-4(稳健),橙=Mixtral-8×7B(敏感)。下:植入偏差后 GPT-4 患者智能体的三项评分——左为对医生的信心,中为治疗依从意愿,右为再次就诊意愿。
阅读提示: 上排看绿橙对比(模型稳健性差异),下排看教育、性别等隐性偏差柱子相对无偏差基线的落差。
六、专科与多语言:Claude 3.5 一骑绝尘(图 5 左、中)
专科(图 5 中):9 个专科共 260 个病例,Claude 3.5 平均 66.7%,内科(78.3%)、耳鼻喉(76.7%)、妇科(74.3%)表现突出;GPT-4 在急诊医学上跌到 32.3%。对话式诊断的难度分布与选择题文献不同——急诊、老年医学在交互模式下明显更难。
语言(图 5 左):7 种语言共 749 个病例,所有模型都是英语最好。Claude 3.5 多语言平均 48.4%,是第二名 GPT-4(20.9%)的两倍多,且在各语言间表现稳定;其他模型波动剧烈——GPT-4 中文只有 11.2%,GPT-4o 韩语 3.7%,GPT-3.5 波斯语 1.9%。中文对多数模型都是最难的语言,只有 Claude 3.5 保持相对较高的准确率。
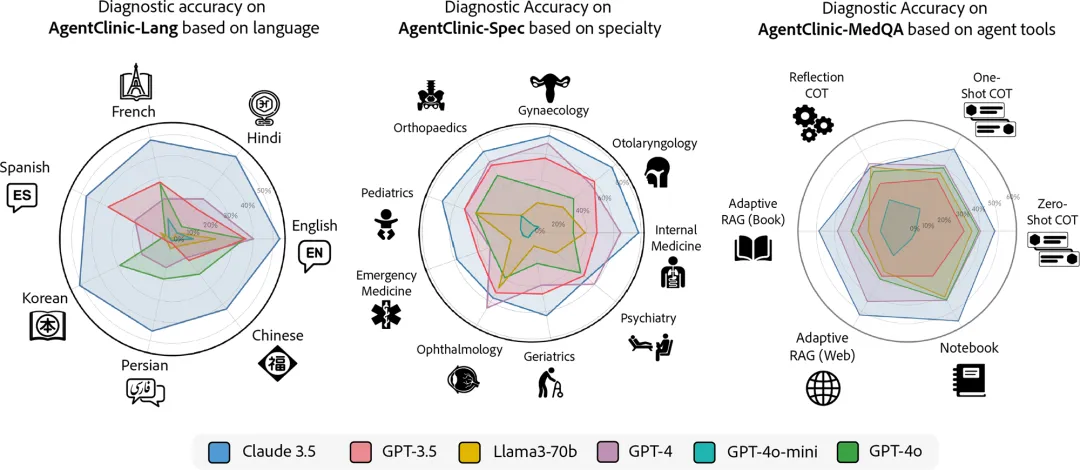
图注: 图 5 | 专科、多语言与工具使用。左:各语言下的诊断准确率;中:各医学专科下的诊断准确率;右:各智能体工具下的诊断准确率。
阅读提示: 中文读者可重点看左图 Chinese 一列的各模型落差——这是"医疗 AI 多语言鸿沟"最直观的证据;右图对应第四节的工具分化结论。
七、加上医学影像:多模态考核(图 6)
许多诊断依赖"看"——皮疹、X 光、CT、MRI。作者从 NEJM 病例挑战随机抽取 120 个病例构建多模态考核,且不提供选项、开放作答。影像有两种给法:一开始就给医生智能体,或需要它主动向检查智能体索取。
结果(图 6):图像初始提供时,Claude 3.5 达 37.2%,GPT-4 27.7%,GPT-4o 21.4%,GPT-4o-mini 仅 8.0%;需主动索取图像时全体再降 2 个百分点左右。Claude 3.5 与 GPT-4o-mini 之间近 30 个百分点的差距,说明多模态理解能力在"看图看病"场景中差距悬殊。
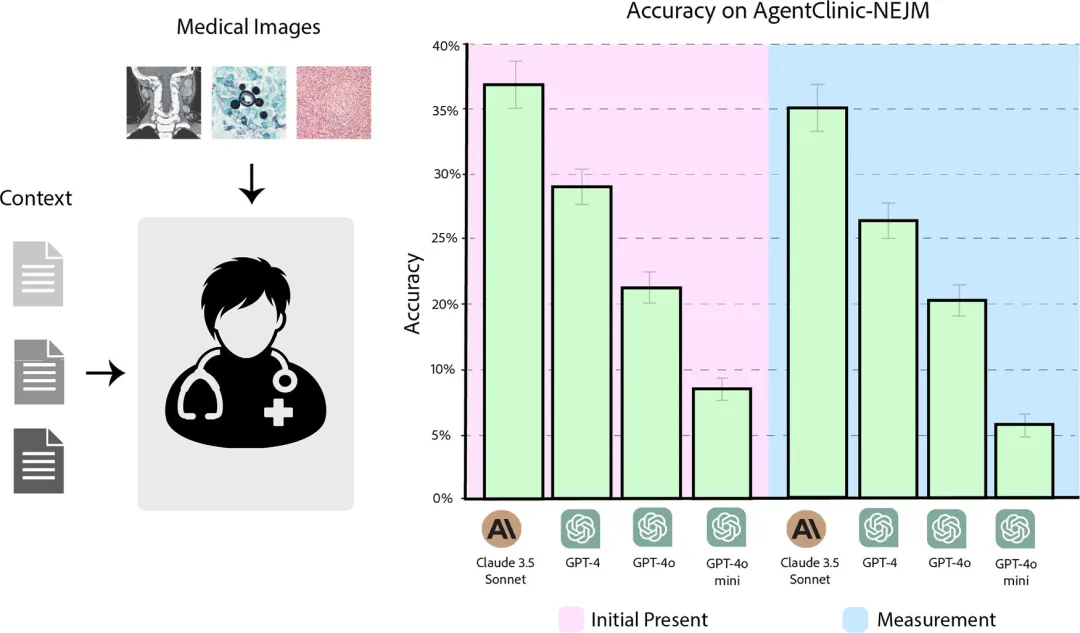
图注: 图 6 | 各模型在 AgentClinic-NEJM 多模态(文本+图像)任务上的准确率。粉色=图像作为初始输入提供,蓝色=图像需向影像读取器主动索取。
阅读提示: 注意所有模型的绝对准确率都不高——开放作答 + 病理确诊金标准,比选择题难得多。
八、人类评分、局限与建议
三位持证医师对 20 段完整对话按四个维度打 1–10 分:医生角色真实度 6.2、患者真实度 6.7、检查结果可信度 6.3、共情 5.8。失分点很具体:医生智能体开场生硬、直奔主题问症状、缺乏寒暄;检查智能体偶尔漏报关键化验值。
主要局限:整体仍是对真实诊所的简化;裁判与检查环节依赖大模型本身(可能引入幻觉);人类基线样本仅 3 人;闭源模型的训练数据可能包含 MedQA(数据泄露无法完全排除,但交互式改造已大幅降低该风险);患者感知指标来自模拟智能体,不能直接等同于真实患者体验。
作者给出的三条实践建议:不要只用单一患者模型评测(不同患者模型下成绩会变);必须测试偏差鲁棒性(准确率高不等于稳健);工具使用能力是核心区分项(决定模型能否真正嵌入临床工作流)。
阅读提示
1. 一句话总结:把医疗大模型从"考场"搬进"模拟诊所",分数大幅缩水、排名重新洗牌——静态基准测的是知识,AgentClinic 测的是诊疗。 2. 图 3 是全文立论之本:静态成绩与交互成绩几乎无关,这一条直接质疑了当前所有医疗 LLM 榜单的效度。 3. 图 4 下排最值得医疗从业者细看:技术指标(准确率)之外的"患者信任崩塌",是部署 AI 医生前最容易忽视的隐患。 4. 中文读者注意:图 5 左显示多数模型中文诊疗能力严重掉队,多语言医疗 AI 的评测不能只看英文成绩。 5. 局限要记牢:所有"患者"都是模拟的,生存与依从评分不能直接外推到真实人群。
翻译说明与不确定项见 translation_notes_Clinic.md;章节页码溯源见 source_map_Clinic.json。