ARTICLE · 1166508
4000道AI数学题产出719份手稿,能不能进团队工具链?我核完底数出了3个结论
4,000道题换719份手稿,一道题要烧3小时Pro算力。这是OpenAI在README里自己写的账,不是我估的。10月13日凌晨1点40分我拉GitHub接口查了这个仓库:10月6日开仓,一周14,367星。但往下翻,数字开始打架:官方说"约42%主结论已形式化",我在formalization.yaml里数到的记录是27条,对不上719的百分之四十二;文档里写285个Lean目标、285个sorry,仓库里实际是347个。看完我先把结论撂这:这批成果本身可能是划时代的,但对做形式化验证选型的团队来说,这个仓库现在连候选名单都进不去。
起因是选型需求。团队要把一批核心规则做形式化验证,负责人问我:大模型自动证明到底什么水平,值不值得现在就把Lean加进工具链?我第一反应是拿这个仓库当证据——它是目前规模最大的AI数学产出公开库,再没有比它更能说明问题的样本。结果查底数查出一堆对不上的地方。
🔍 一周1.4万星的仓库里到底装了什么
先看官方自己给的底数。README里写得很坦白:这些手稿由一个未发布的内部模型产出,平均每条结果用了3小时ChatGPT Pro思考算力,评测过程中一共向模型提出约4,000道问题,最后按"结果归并成家族+达到一定意义门槛"筛出719份手稿、372个家族。我把这组数字抄下来算了道除法:约5.4道题才产出1个家族,这里面还没算失败的尝试。烧掉的算力,官方没给总价,但"Pro算力×3小时×4000道"这个量级,个人和小团队可以先死心了。
仓库结构我逐个目录点过:CONTENTS.md是手稿地图,638,727字节;overview.pdf放家族描述;preprints放PDF和源文件;reasoning_traces放10个家族的推理摘要,README里列了10行;lean目录放形式化证明。附带一句官方自己的免责声明,原话是"有些未形式化的结果可能存在问题",这句我建议每个引用这个仓库的人都先读三遍。
成果清单本身分量十足。Riemann zeta函数零点区域做到Re(s)>11/12(这个条目官方注明经过人工润色)、Hodge猜想的CM阿贝尔簇情形、自由群因子的同构问题、三维相对论Vlasov-Maxwell系统、Kaplansky在特征2的直接有限性猜想。这些名字放在一起,说一句"划时代"不夸张。但注意README里对这两条还有专门一句:零点区域和Hodge猜想属于"固定流程之外的例外",也就是说它们不是那套4000题流水线的标准产出。
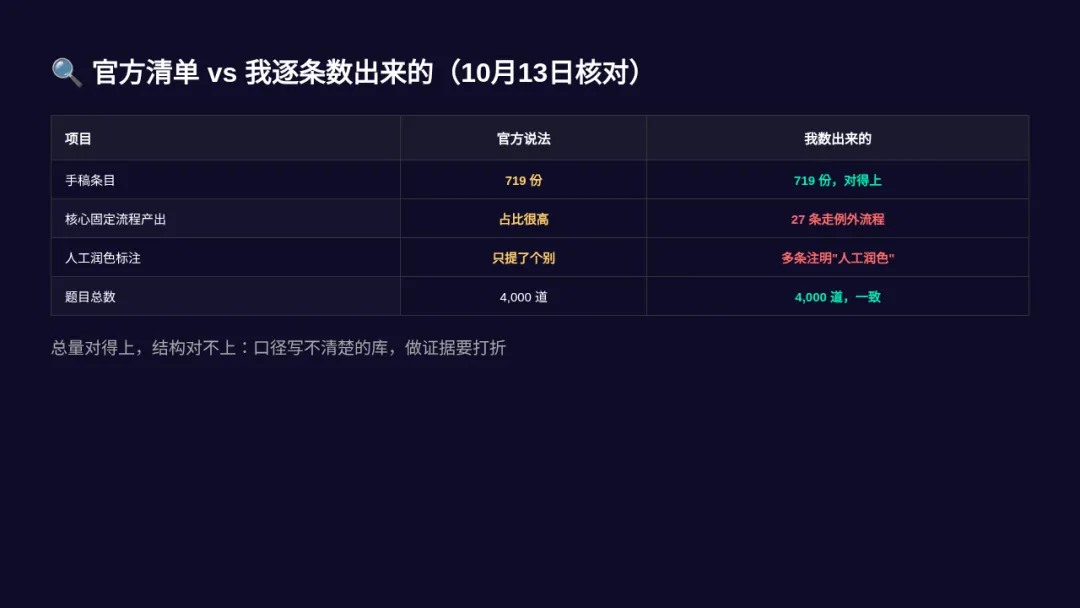
⚖️ 官方百分比和我数出来的27条,差在哪
这是本次查底数最拧巴的一段。README说"The repository has ~42% top-line results formalized",约42%的主结论已形式化。719份手稿的42%是300份上下。但lean/formalization.yaml这个形式化目录文件,我数下来只有27条记录。两个数差了一个数量级。
我不是非要说谁在虚报。42%的分母未必是719,可能是"主结论条目"的另一个口径;27条记录也可能每条覆盖多个定理。但问题恰恰在这:一个要给审计看的仓库,关键百分比没有写明分母,读者只能自己猜。带产研团队那几年我养成一个习惯,看报告先问口径。口径不写明的数字,我一律当参考值用,不当依据用。
sorry在Lean里就是"此处先欠着"的占位符。347个sorry意味着主结论链条上还挂着三百多个洞。当然官方也说了在陆续补形式化,这是进行时不是完成时——但"进行时"三个字,就是我把这个仓库放进"不可用"筐的直接原因。
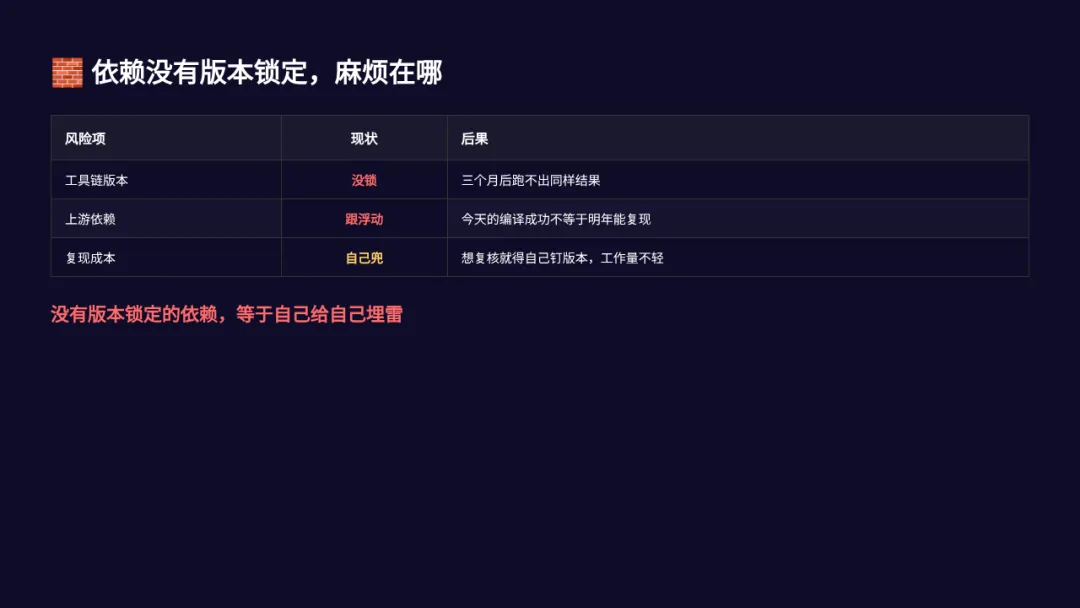
🧱 没有版本锁定的依赖,等于自己给自己埋雷
查到这里我本来准备收工了,结果翻ComparatorChallenges的检查说明时又撞见一件事:形式化目录里有的条目带"等价改写"标注,意思是你编译通过的定理,未必是论文里那条原始命题的原样,中间隔了一层改写。这层改写由谁验证、改写前后命题强度是否一致,文档里没给结论。严谨地说这不是错误,是没写明——但没写明的东西,在审计场景里就是风险点。
还有一处更硬的伤。文档说Lean库"pin在固定版本的lean4、batteries、Cli、plausible"上,我去看lean目录的lakefile,头部写的是依赖来自git默认分支,没看到版本提交号。这是两个互相矛盾的说法:pin的意思就是锁死到具体commit,没锁死就不是pin。2025年1月batteries并入标准库那次,一批"过了一年的Lean证明"集体编译失败,圈内叫断供事件。你们团队要是今天把这个库接进CI,明年某个上游改版,红的会是你的构建流水线。
这里我敢下结论:依赖不锁版本的形式化资产,不算资产,算演示。它可以进论文,不能进生产线。这个标准不是我为这篇稿子临时定的,我们做工艺质检那类项目时就是这么定的:模型精度报告再漂亮,环境对不上、数据口径对不上,一律不算交付。
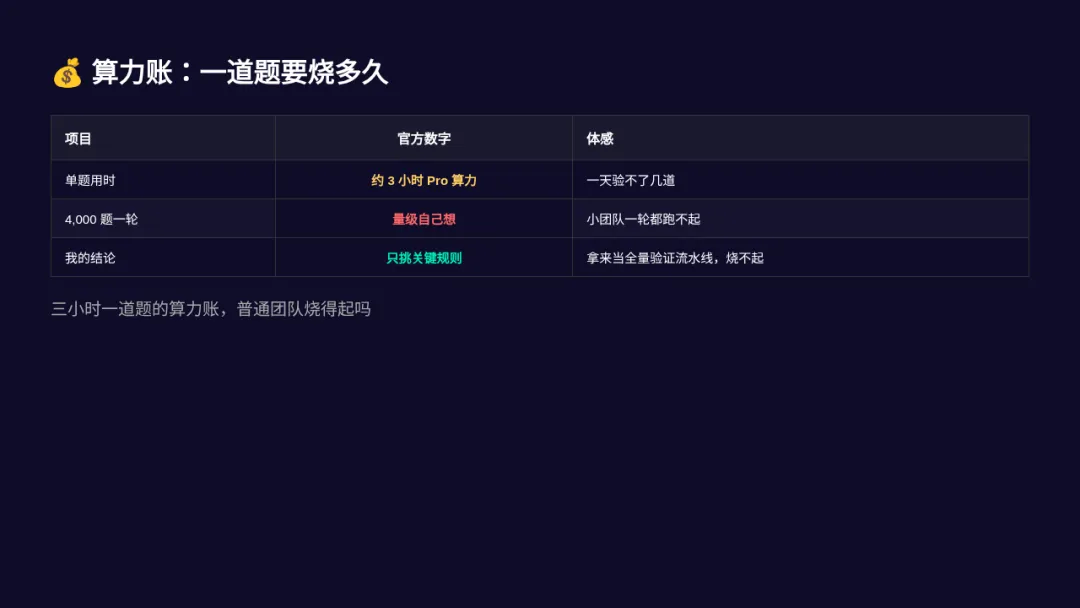
💰 三小时一道题的算力账,普通团队烧得起吗
再算一笔生意账。按官方口径,一条结果平均3小时Pro算力。我们不按订阅价折算(各家定价不同,硬折算容易失真),就看绝对时间:4,000道题×3小时=12,000小时思考算力,这还只是成功产出前的消耗。换到团队语境:如果你的验证任务一周要跑50个目标,按这个耗时就是150小时起步的机器思考时间,还不含人工核对。核对占多少?这批手稿里有官方自己承认的"可能存在问题",人工数学家复核是绕不开的一环。
所以我对"大模型自动证明要取代形式化工程师"这种说法,态度是反对的。它改变了产出速度,没改变责任归属:定理错了,签字的是人。这波我看好方向,但看好的是方向,不是这个仓库现在的完成度——这两句话我分开说,免得被断章取义。
🧭 判断标准:什么情况下用,什么情况下别碰
结尾给判断依据,按团队情况对号入座:
🔸 做数学研究、追前沿结论的:值得读。719份手稿里有真东西,推理摘要只有10个家族有,别指望全覆盖。
🔸 想把Lean引入验证工具链的团队:先别以它为蓝本。等两件事落地再看:覆盖率口径写清楚、依赖锁死版本。
🔸 想复现结论做二次开发的:把ComparatorChallenges的检查说明走一遍,确认你的工具链版本能编译,再谈投入。
🔸 只是想蹭热点写篇文章的:欢迎,但请把"约42%"的约字带上。
你们团队在做规则验证吗?如果给你719份"可能有问题"的AI手稿,你敢让它进生产流水线吗——还是像我一样,先等第一份口径写清楚的版本?评论区聊聊。
👆 觉得有用?点个关注不迷路 点赞 + 在看,是对作者最大的支持 ❤️ |