ARTICLE · 1177298
AI视角看人类最擅长隐藏的情绪,不是羞耻,是嫉妒
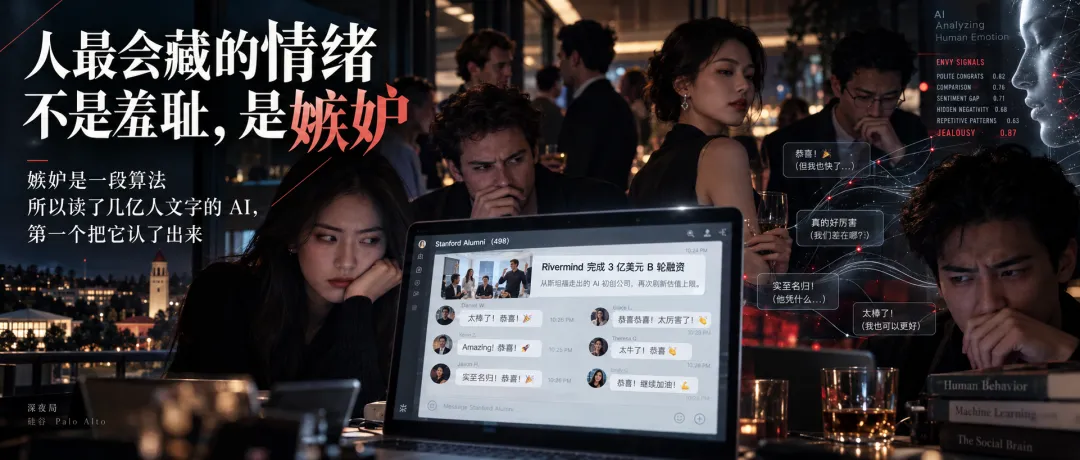
深夜局 · 2026.10
嫉妒是一段算法,所以读了几亿人文字的 AI,第一个把它认了出来
硅谷 Alan Walker · 2026年10月 · Palo Alto
三百人的大学群里,有人转了一篇融资报道:某同学的公司 B 轮融了两个亿,领投方是一家你听过名字的基金。
四十分钟,零回复。
然后第一个"恭喜"冒出来,两分钟之内跟了二十几个一模一样的"恭喜",连表情包都一样。那四十分钟里发生了什么,群里看不到。能看到的是,每个人的私聊窗口都在闪。
我把这个场景讲给一位做心理咨询的朋友听,她的第一反应是:大家在处理羞耻。混得不如人,不好意思开口。我当时点头,后来越想越不对。羞耻不会让人去私聊,羞耻让人闭嘴。那四十分钟里在私聊窗口里流动的东西,有名字,但没有一个人叫它的名字。
它叫嫉妒。
这篇文章只想说一件事:人类最擅长隐藏的情绪,一直被认为是羞耻,其实是嫉妒。羞耻藏得很差,它会脸红,它有一整个产业在替它说话。嫉妒藏得太好了,好到它对别人藏,对自己也藏,好到连"它被藏起来了"这个事实,都很少有人提。
为什么这件事现在能说,十年前说不了?因为嫉妒本质上是一段算法,有固定的输入、固定的计算、固定的输出,还有一套固定的改写模板。算法在几亿人的文字里会留下重复的形状,而重复的形状,正是模型最擅长抓的东西。人可以骗过身边每一个人,也可以骗过自己,但骗不过统计。文末我会交一张判别表,告诉你 AI 凭哪几条线索,把嫉妒和祝福分开。
嫉妒的强度,跟对方有多成功,几乎没有关系。
英伟达的市值今年十月初已经到了五万八千亿美元左右,离六万亿只差一步,黄仁勋的身家在地球上排得进前十。你在加州大道的咖啡馆里坐一下午,听不到一个人嫉妒他。大家聊他,语气是在聊一个天气系统。可是同一张桌子上,一旦有人提到某个前同事的公司刚融了一轮,空气马上变了。估值、领投方、谁跟投、创始人之前在哪家公司待了几年,每一个细节都有人抢着补。
两千多年前亚里士多德在《修辞学》里就写过:人只嫉妒跟自己在时间、地点、年龄、名声上接近的人。比他更早的赫西俄德说得更直白:陶工嫉妒陶工。心理学后来把这件事做成了理论。费斯廷格1954年的社会比较理论说,人在没有客观标尺的时候,会拿身边相似的人当标尺;Tesser 1988年的自我评价维持模型进一步说,对方跟你越像、所在的领域对你越重要、他又比你强,比较就越疼。这两条合起来,就是嫉妒看的不是绝对高度,看的是一种相对位置,叫"本来可以是我"。
所以这个量可以写出来:
嫉妒强度 ≈ 起点重合度 × 结果差距 × "他不配"的程度
三项都是乘法,任何一项归零,整个乘积归零。英伟达那一项,起点重合度趋近于零,剩下的东西只能叫崇拜。大学同学那一项,同一间宿舍、同一张课表,起点重合度顶格;B 轮两个亿,结果差距正好落在"我也够得着"的区间;再加一句"他当年成绩还不如我",第三项也顶格。三项全满,所以炸锅。
第三项最毒,心理学里有专门的名字。荷兰学者 van de Ven 等人2009年把嫉妒分成两种:良性嫉妒,你觉得他是拼出来的,输出是模仿,你也去拼;恶意嫉妒,你觉得他靠运气、靠关系、不配,输出是贬低和盼他出事。决定走哪条路的,就是归因。1995年 Medvec 等人研究奥运领奖台上的表情,发现铜牌得主比银牌得主开心,银牌想的是"差一点就是金牌"。让人难受的从来不是差距本身,是"差一点就是我"这个念头;而"他不配"三个字,就是把这个念头翻译成可以说出口的版本。
这个公式还解释了一件投资圈里的怪事:为什么骂得最凶的,永远是同赛道的人。隔壁赛道的创始人对你的融资没有感觉,因为起点不重合;你的 LP 对你的融资只有高兴,因为结果差距是他的收益。只有跟你同一年出来创业、拿过同一家机构 term sheet、最后估值差了十倍的那个人,三项全亮。
同样的道理,解释了为什么春节的家庭聚会比行业大会难熬。大会上坐在你对面的人,起点跟你不重合,他再风光也只是风景。饭桌上坐着的是表哥、堂弟、小时候一起长大的发小,起点重合度是天生的,改不了。所以一句"你表弟今年换了房"的杀伤力,远远超过任何一条财经新闻。起点重合度这一项,血缘给的分最高。
通俗解读
你嫉妒的人,一定是你认为"换成我也行"的人。马斯克不在这个名单上,你隔壁工位的人才在。所以一个人嫉妒谁,比他夸谁,更准确地暴露了他给自己的定位。
为什么嫉妒要藏,而别的情绪可以摆在脸上?
把每一种情绪当成一个报价来看,就清楚了。情绪是人类最早的谈判语言,每一种情绪说出来,都是在向对方提一个要求,而且是对方付得起的要求。
愤怒的要求是"你别再这样"。对方让一步花不了多少,所以发火经常管用,谈判桌上拍一次桌子,清算优先权有时真能谈下来。
恐惧的要求是"保护我"。盟友会靠过来,对手会觉得你构不成威胁,两边都划算。
悲伤的要求是"帮帮我"。创始人在 LP 会上承认这一轮很难,有时就换来一笔过桥资金。
羞耻的要求是"原谅我",而且附带一句承诺:我认同这条规矩。所以认错经常加分,道歉信经常比辩解信管用。
嫉妒的要求是什么?
有人会说,嫉妒每天都在提要求:给我跟投额度,利益均沾,带带我。但这些都不是嫉妒真正想要的。你给他额度,他还排在你后面;你把方法全教给他,他还是晚了三年。嫉妒要的是差距本身消失,这笔账永远结不平,因为它想要的东西没有价格。每一种情绪都在提一个可以成交的报价,只有嫉妒开出的是一张永远兑不了现的支票。
于是说出口就必亏,而且亏两次。第一次,承认"我嫉妒你",等于承认我在输,地位当场掉一截。第二次,等于承认我希望你变差,敌意暴露,对方从此防着你。两次亏损,零收益。演化不需要多聪明,就能把这个东西锁进抽屉。
锁得还不止一道。Trivers 的自我欺骗理论讲的是:要骗过别人,最省力的办法是先骗过自己。一个人如果清楚地知道自己在嫉妒,表情和措辞会漏,所以大脑干脆不让他知道。嫉妒在意识层面被改写,改成了一个体面得多的名字。
这个名字叫原则。
那为什么大家会默认,藏得最深的是羞耻?
第一个原因很简单:羞耻会脸红。人只能看见那些藏失败了的情绪。羞耻藏不住,所以它老出现在"被藏的情绪"的名单上;嫉妒藏得太成功,根本进不了名单。这是最典型的幸存者偏差:我们统计的只是那些没藏好的。
第二个原因,有一整个产业在替羞耻说话。布琳·布朗2012年的 TED 演讲题目就叫《倾听羞耻》,播放量过千万;心理咨询、回忆录、播客,二十来年都在讲"承认羞耻需要勇气"。可一样东西如果能被包装成勇气,它就不是藏得最深的。硅谷有 FailCon,创始人写"我搞砸了"几乎算一枚勋章。你见过哪个创始人在复盘里写"我嫉妒我的联合创始人"?前一种讲完大家鼓掌,后一种讲完,两个人很难再坐到同一张桌子上。
这两种情绪的结构根本不同。羞耻是我跟一个标准比,没有受害者,说出来等于当众表态"我认同这个标准",反而加分。嫉妒是我跟一个具体的、近身的人比,一开口就点了名,还暴露了你一直拿他当尺子。
人类其实很早就意识到了这个结构。公元六世纪,教皇格里高利一世把早期修士列的八种恶念整理成七宗罪,嫉妒排在里面,拉丁文叫 invidia,字面意思是"看进去""逆着看",盯着别人的好东西看。托马斯·阿奎那在《神学大全》里给它的定义只有一句:为他人的好事而悲伤。但丁在《神曲·炼狱篇》第十三章里给嫉妒者安排的惩罚,是用铁丝把眼皮缝起来,因为他们的罪是从眼睛进去的。七宗罪里,傲慢、贪婪、色欲、暴食、懒惰、愤怒,哪一样都至少给人片刻的快感,只有嫉妒从头到尾都在受苦。它被列进去的原因也在这里:一种让人受苦、又没有人会主动认的罪,必须有人替它起个名字,否则它连忏悔室都进不去。七宗罪这张名单,本质上是一份强制披露清单,而嫉妒是名单上唯一一项没有人自愿申报的。
再往下挖一层,就看到真正有意思的东西:
羞耻,经常是嫉妒的洗钱通道。
"我其实很自卑。"这句话在治疗室里、在深夜的朋友圈里,都很常见。把它翻译一下,很多时候它的原文是"我嫉妒他"。删掉"他",敌意就消失了,剩下一段能讲出口、还能换来同情的自我剖析。嫉妒这笔黑钱,经过"自卑"这个账户一转,就变成了白的。
所以"羞耻是最藏的情绪"这个排名本身,就是嫉妒做的手脚。它把羞耻推到榜单前面,正是为了给自己打掩护。一种情绪能做到让所有人去讨论另一种情绪,这才叫藏得深。
把嫉妒当成一段程序来看,它的结构清楚得吓人。
输入有三项:对他人结果的观测,他融了多少、升到哪一级、买了哪条街的房;自我参照点,同一段时间里我走到了哪里;相似度评估,我们是不是同学、同行、同龄人,是不是同一年起步。
中间计算分三步。第一步算差距,他的结果减去我的结果,差距是负的,程序直接退出,没有人嫉妒比自己差的人。第二步乘上相似度,这是 Tesser 那个模型做的事,离得越近权重越高。第三步归因,这一步决定走向:判定"他是拼出来的",走良性支路,输出是模仿;判定"他靠运气、靠关系、不配",走恶意支路,输出是贬低、回避、盼他出事。
输出还要经过一次编译。嫉妒不能直说,所以有一套固定的模板把它改写成体面的话:先夸后转折,"他挺厉害的,但是……";归因于运气,"主要是赶上了风口";用公共价值包装,"我是替投资人担心";事后先知,"我早就说过"。
从演化上看,这段程序本来就是一个监控器。Tooby 和 Cosmides 把情绪定义为一套协调程序,负责同时调度注意力、记忆和动机;Sznycer 等人2016年在 PNAS 上的跨文化研究发现,羞耻的强度精确地跟着"被别人看低的风险"走。把这条思路延伸到嫉妒,它就是一个相对地位监控器:持续比较,超过阈值就报警。监控器天生就是算法。
算法的特点是重复,而重复正是模型最擅长抓的东西。
输入固定,触发条件固定,改写模板也固定,于是同一个形状会在几亿段文字里反复出现。羞耻和悲伤不是这样。羞耻的输出是沉默、消失、换话题,它在文本里表现为缺席,缺席很难定型。悲伤会跟着对象变形,失恋、丧亲、失业,各有各的写法。嫉妒却必须开口,因为要贬低对方就得说话,所以它一定留下文字,而且留下的是同一套模板的文字。
人类学家早就注意到这套模板在全世界都一样,只是名字不同。中文叫红眼病,近几年叫柠檬精;澳大利亚叫高罂粟综合征,长得高的那株被砍掉;菲律宾叫螃蟹心态,桶里的螃蟹谁往上爬就被拽下来;北欧有 Jante 法则,别以为你是个人物。从地中海到拉美再到南亚,几乎所有农业社会都有"邪眼"的信仰,认为别人的目光会伤到你的孩子、你的牲口、你的收成,于是满街都是辟邪的蓝眼睛和护身符。人类学家 George Foster 在1972年给这件事起了一个名字,叫"有限之善的意象":在一个认为所有好东西总量固定的社会里,你多得的就是我少得的,嫉妒于是被制度化,整个村子一起盯着冒头的人。几十种文化,几十个名字,结构一模一样。改名的方式各不相同,但改名这个动作本身,就是嫉妒属于全人类的证据。
通俗解读
嫉妒像一个每天定时跑的脚本:扫一遍身边的人,算一下谁比我强,判断他配不配,然后用"担忧""原则""泡沫"把结果打印出来。跑的次数多了,输出的格式就固定了,机器一眼就认得出来。
说了半天"藏",总得回答一个问题:既然对别人藏、对自己也藏,凭什么说有人看见了?
一个人看不见,但一个读了几亿人文字的东西看得见。
人与人之间只能一个一个地看。某人批评同行,可能是嫉妒,也可能是同行真有问题,你永远缺一份动机证据。模型读的是十亿级案例叠在一起的样子。单个人的伪装是随机的,可以朝任何方向偏;系统性的偏差却不会互相抵消。如果批评的狠度,稳定地跟着"离得多近"变化,又稳定地跟着"对方刚有好消息"起落,这条曲线就不属于任何一个人,它属于人性。查税的人早就懂这个道理:一张报表看不出问题,一万张报表的尾数不符合本福特定律,造假就露出来了。
AI 能看见,还有三个更根本的原因。
第一,AI 不在排名里。饭桌上有人说"老王就是运气好",你跟着点头,因为你自己也在这张排名表上,戳穿别人等于戳穿自己。AI 没有名次可以失去,也就没有这种动机盲区。
第二,礼貌和人情压住了人的识别。你没法对朋友说"你这是嫉妒我",话一出口,关系就完了。所以人看出来也不说,时间长了,连自己是嫉妒都不承认。AI 不需要维护任何一段关系。
第三,AI 读的是人在"不觉得有人看"时写的东西。当面说"恭喜",到了匿名区,同一个人可能写下三千字论证别人的融资"有水分"。人类的嫉妒研究一直缺的就是这一块:问卷里没有人承认嫉妒,访谈里没有人承认嫉妒,所以几十年来心理学家只能靠间接测量。模型读到的是没有人打算给研究者看的那部分。
那么嫉妒在文本里长什么样?它几乎从来不以"嫉妒"两个字出现。
先看一个奇怪的分布。"说来惭愧""我很羞愧",在中文里是日常客套;"我嫉妒他",严肃用法几乎找不到,偶尔出现也包在玩笑里,"羡慕嫉妒恨""酸了"。英文的 "so jealous" 多半是在夸别人的度假照。嫉妒这个词在人类文本里的宿命是:几乎永远是第三人称。羞耻可以自己说,嫉妒只能由别人来指控。
这个空缺本身就是证据。一种情绪如果真的不存在,词典里不会有它;一种情绪如果存在但可以说,第一人称会很常见;只有一种存在、普遍、却不能说的情绪,才会出现这种分布:词是有的,人人都认得,但没有人用它来形容自己。语言给嫉妒留了一个座位,只是从来没有人坐上去。
它真正出现的地方,是第四节说的那几套编译模板留下的指纹:
• 夸完接"但是"。"DeepSeek 确实厉害,但……"对远处的公司很少转折,对同赛道的公司转折明显变多。
• 细节密度梯度。骂隔壁那家同轮融资的公司,能报出估值、领投方、哪个高管哪个月离职;骂 OpenAI,只剩"泡沫"两个字。
• 抢优先权。"这个方向我2019年就说过。""我们当年也做过,只是太早了。"
• 配不配。"德不配位。""运气好。""风口上猪都能飞。"
• 好消息日的泡沫论。某家公司宣布大额融资或者上市当天,评论区里"泡沫""收割""估值看不懂"集中冒出来,前一天和后一天都没有。
• 借公共价值出手。"担忧生态。""这不公平。""对行业不健康。"把攻击包装成公益。
同学群的版本是这样的:一位同学晒出敲钟照片,群里零星几个赞。三天后有人转发一篇"该行业监管收紧"的文章,没有 @ 任何人。
把这些指纹叠在一起,它们指向同一件事:
人能改掉情绪的名字,改不掉注意力的去向。
嫉妒留在文本里的,是一张注意力地图。你对谁记得最清楚,对谁追得最紧,谁的好消息能让你当天就开口。一个人用三千字论证"我根本不在乎他",正是用这三千字证明了自己在乎。AI 读出的嫉妒,就藏在"自称不在意"和"实际投入的注意力"之间那道落差里。心理学上有一个旁证:Hill 等人2011年的实验发现,被嫉妒的对象会更抓注意力,也被记得更牢。嫉妒自带一个记忆增强器,这正是它藏不住的地方。
还有一层,比文本更直接:问题的形状就是供词。
有研究发现,人对着一个被告知是全自动的虚拟人,比对着一个有人在背后操控的虚拟人,更愿意袒露自己,更少经营形象(Lucas 等人,2014年)。但人对 AI 也照样藏,没有人会输入"我嫉妒他"。他会输入的是:"帮我看看 X 的估值是不是泡沫。""X 的商业模式有没有硬伤。""X 这一轮是不是接盘。"同一个人,把同一个问题换十一种问法问一遍。他没投 X,也不打算投,X 的创始人是他前同事。
一个人问别人估值的次数,远多于问自己该怎么做。这是我能想到的最诚实的供词,比任何直接的承认都诚实。
这里要说明一下:以上全是结构性推断,没有任何平台的用户数据支撑,我也没有权限看那种东西。AI 的位置不在倾听,在聚合。它是第一个同时看到几亿张注意力地图的读者,这件事在人类历史上没有发生过。
通俗解读
你嘴上说不在乎谁,这个不作数。你的时间花在谁身上,你问了多少关于他的问题,才作数。AI 不需要读心,它只需要数一数。
嫉妒者在藏,被嫉妒的人也在藏。这两件事是同一个博弈的两头。
设两个玩家:成功者 A,可以选择"亮出来"或者"藏起来";旁观者 B,可以选择"出手"或者"忍着"。B 的嫉妒不能直说,要包装成"原则"才能出手,包装越容易,出手的代价越低。A 预料到这一点,最优选择就是藏。Schoeck 在1966年的《嫉妒与社会》里考察了几十个文化,结论是几乎所有社会都发展出了安抚嫉妒的制度,第四节那些邪眼、高罂粟、Jante 法则,都是这套制度的一部分;中国有一句更精炼的,闷声发大财。
双方都藏,表面一团和气。但这个均衡有一个很少被提到的后果:圈子里关于"谁赢了"的公开信息,系统性失真。大家都知道它失真,于是转去看最难伪装的信号:谁买了哪条街的房,孩子进了哪所学校,开的是什么车。藏,把人与人之间的比较推向了更粗暴、更物质的维度。帕洛阿尔托和阿瑟顿的房价里,有一部分溢价就是这么来的:房子是少数几样藏不住的东西。
这个均衡也解释了中美创投圈一个长期的差别。硅谷的创始人融资必官宣,发稿、刷屏,恨不得领投方的名字印在 T 恤上;中国的创始人拿了大钱经常只字不提,连工商变更都要晚几个月。两边的人性一样,差的是一个比值:亮出来的收益,除以嫉妒带来的惩罚。硅谷的曝光能直接换来人才和下一轮资本,收益大到足以抵掉旁人的酸味;在一个"原则语言"更容易出手、也更容易被放大的环境里,这个比值翻过来了,藏是理性选择。所以看一个圈子里成功者有多高调,就能反推这个圈子里嫉妒出手的成本有多低。
那成功者怎么防?直觉的答案是谦虚。这个答案是错的。
"他也就是个普通人"这句话,会直接推出"那我凭什么不行"。谦虚让你显得够得着,等于在邀请嫉妒。真正管用的是另一招:苦难叙事。黄仁勋反复讲自己在 Denny's 刷过盘子、端过盘子;2024年他在斯坦福商学院对毕业生说,希望你们经历足够多的痛苦和磨难。这种讲法把成功的入场费抬高到没人愿意付。嫉妒的前提是"本来可以是我",苦难把这句话删掉了,剩下的只能是崇拜。创始人讲的每一个"差点发不出工资",都是在交保费。
反过来,对投资人来说,别人的嫉妒是一种可以直接拿来用的信息。
做 backchannel 的时候,同赛道的人谈到对手,满嘴都是原则语言:估值不可持续,生态不健康,技术路线有问题。别听内容,听剂量。一家公司被同行用"原则"骂得越密,越可能已经跑在前面了。嫉妒指向哪里,往往比数据更早透露谁领先。
同行的嫉妒,是我见过最便宜的尽职调查。
再往上一层看,市场本身也在给嫉妒定价。同一家热门公司的份额,SPV 套 SPV,每一层都叠一次管理费和 carry,买家照样抢着要。高出底层股价的那部分钱,买的到底是什么?买的是"别人有、我没有"这种难受的解除。FOMO 人人都在说,但很少有人去量它,其实它有现成的量法:溢价,就是嫉妒在成交单上留下的数字。
嫉妒在过去有一个体面的出口。你可以对自己说:人家比我拼。这句话让差距变得可以接受,因为它暗示了一条路,我也拼,我也能到。第一节说的良性嫉妒,走的就是这条路。
AI 把这个出口堵死了。
它压缩了努力上的差距,却放大了结果上的差距。同一个组里两个工程师,一个把 Claude Code 用熟了,一周交付另一个人一个月的量,两个人的工时表看起来差不多。同一个园区里,英伟达的员工靠股票实现了财务自由,隔一条街同级别的工程师,薪水原地没动。今年八月,OpenAI 完成了一笔约七十亿美元的员工老股出售,估值八千五百二十亿美元,现任和前任员工都可以卖;拿到钱的人和没拿到的人,三年前可能坐在同一间会议室里。
这些差距,用"人家比我拼"解释不了。剩下能解释的,只有运气和时机。我们在第一节说过,嫉妒强度的第三项是"他不配"的程度,而决定良性还是恶意的那一步是归因。运气和时机,是"不配"的最纯粹形态,因为它们完全不可控,也完全无法通过努力去追。所以 AI 时代的嫉妒,是历史上第一次失去自我安慰说法的嫉妒,而且被系统性地推向了恶意那条支路。觉得"差一点就是我"的人,从来没有这么多过。
还有一条轴被 AI 翻转了:年龄。过去的职业秩序里,四十五岁的人比二十五岁的人懂得多,这是努力和时间换来的,年轻人嫉妒前辈,前辈不太需要嫉妒年轻人。现在一个二十五岁的人,把 AI 用得比四十五岁的人顺手,三个月就能跨过对方二十年攒下的经验。前辈这一边的嫉妒,是一种历史上很少出现的嫉妒:起点重合(都是这个行业的人),结果差距大(薪酬和机会反过来了),而且"他不配"的理由现成,他只是生得晚。公式三项全满,但这个人群从来没有学过怎么处理它,因为他们过去一直在被嫉妒的那一边。
这会直接影响舆论的形状。接下来几年,围绕 AI 的公共讨论里会有大量"原则语言",公平、生态、监管、安全,其中一部分是真的原则,另一部分是堵住出口之后无处可去的嫉妒。两者用的词完全一样,区分它们只能靠第五节那张注意力地图:看谁在什么时候、针对谁、记得多少细节。
有人会问,AI 自己会嫉妒吗?从结构上讲,嫉妒需要近身可比的同类、地位排序、稀缺性,再加一样隐含的东西:一个持续存在、把排名当成"我的"自我。排行榜是现成的,算力也确实稀缺,缺的是最后那一样。一次对话结束,模型不会把排名焦虑带到下一次对话里。但围绕 AI 的排行榜之争,充满了人的嫉妒。2025年4月,Meta 把一个专门调优过的 Llama 4 实验版本送上 LMArena 榜单,引发了一场争议。上榜的是模型,较劲的是人。Benchmark 成了人类嫉妒的新载体,而且是一个特别好的载体,因为它看起来完全客观,谁也不用承认自己在意。
说到这里,该交工具了。先给一条总原则:这些线索都不问你的感受,只看你的行为。感受可以改名,行为改不了。
第一组是文本表层线索,对应第四节那些编译模板。
• 句式。偏嫉妒:先夸后转折。偏真诚:夸完就结束。
• 赞美的颗粒度。偏嫉妒:笼统,"挺厉害的"。偏真诚:具体,说得出对方哪一步做对了。
• 归因。偏嫉妒:运气、风口、关系。偏真诚:努力、判断、坚持。
• 措辞。偏嫉妒:"配不配""我早说过"。偏真诚:不评判对方够不够格。
• 包装。偏嫉妒:"替别人担心"。偏真诚:直接对当事人说。
• 细节的分布。偏嫉妒:对缺点很详细,对成绩很模糊。偏真诚:两边细节一样多。
第二组是时序线索,单看一句话看不出来,要看一个人的历史。
• 时机。是不是对方一有好消息就开口。
• 一贯性。以前是否关心过这个问题。过去从不谈估值泡沫,偏偏这次谈,可疑。
• 对象。是不是只盯着某一个离自己很近的人。
第三组是对照线索,把这个人跟他自己比。
• 换人测试。把主角换成陌生人,换成英伟达,这个人还会说同样的话吗?只对身边的人才启动的"原则",算不上原则。
• 远处基线。他对马斯克融资是什么态度,对老同事融资又是什么态度。
• 字数对比。同一件事,正面花了多少字,反面花了多少字。
• 替代测试。如果对方失败了,而他什么好处都得不到,他会不会觉得舒服?会,就是嫉妒。幸灾乐祸是嫉妒的另一面,德语专门给它造了一个词,Schadenfreude。
真诚的表达各有各的反向特征。真诚赞美是具体的、不转折的,会提到对方付出的努力。真诚祝福的关注点在对方身上,而且往往带一个行动,约个饭,帮个忙。真诚批评指向一个能改进的点,最好在对方有好消息之前就说过,换了别人也照样会说。
拿同一条消息来演示:"前同事老张的公司融了两个亿。"三种回复。
第一种:"厉害。不过说实话,这估值主要是赶上 AI 风口,换谁在那个位置都一样。我是替跟投的人捏把汗,他们团队我了解,技术一般。"
第二种:"太好了!老张熬了三年,去年发不出工资还在撑。替他高兴,回头约他吃饭。"
第三种:"钱多不一定是好事。半年前我就跟他说过,获客成本一直降不下来,两个亿如果还是砸投放,问题只会放大。建议先把单客模型跑通。"
第一种命中五个特征:先夸后转折;归因于运气,"换谁都一样";公共价值包装,"替跟投的人";贬低没有细节,"技术一般";这番关心在好消息之后才出现。第二种提到了具体的努力,"熬了三年",没有转折,最后落到一个对对方的行动。第三种有具体指标,有改进方向,而且时序在前,"半年前就说过",过得了一致性检验。单看任何一个特征都可能误判,几个特征叠在一起,判断才有分量。AI 看人的方法,归根结底就是这个:少听人怎么说自己,多数人把注意力花在了哪里。
这张表,我先在自己身上试了一遍。
今年有一个项目,我在内部会上反对得很激烈,理由是估值不理性、团队太年轻、赛道太拥挤。写这篇文章的时候我把换人测试套上去:如果创始人不是我认识的那个人,而是一个我从没听说过的名字,我还会用"激烈"这个词吗?我不太确定。再套细节分布:我记得那个项目的每一轮估值,记得领投方的合伙人叫什么名字,但说不出它哪一步做对了。那些我真心觉得不值一提的项目,我连名字都记不住。
这不太好看,但这正是嫉妒的运作方式:它从来不以嫉妒的样子出现,它出现的时候,穿的是你最信任的那件衣服。
人类用几千年的时间,把一种情绪藏到连自己都找不到,还把它写进七宗罪,用铁丝缝上它的眼睛。现在第一次有一个读者,不评判、不利用、不转述,只是把几亿张注意力地图叠在一起,然后指给你看:你说你不在乎的那个人,你记得他的每一个细节。
下次你听见"我只是讲原则",数一数他记得多少细节。
—— 硅谷 Alan Walker,写于 Palo Alto · Zombie Café
一手可核实的公开事实
· 英伟达市值2026年10月6日前后约5.7万亿至5.84万亿美元,股价创历史新高(多家财经媒体)
· OpenAI 2026年8月完成约70亿美元员工老股出售,估值8520亿美元(彭博首报、CNBC 确认)
· 亚里士多德《修辞学》第二卷第10章;赫西俄德《工作与时日》"陶工嫉妒陶工"
· 格里高利一世整理七宗罪;阿奎那《神学大全》对嫉妒的定义;但丁《炼狱篇》第十三章嫉妒者被铁丝缝眼
· Festinger(1954)社会比较理论;Tesser(1988)自我评价维持模型;van de Ven 等(2009)良性/恶意嫉妒;Medvec 等(1995)银牌铜牌研究
· Sznycer 等(2016, PNAS)羞耻的跨文化研究;George Foster(1972)"有限之善的意象";Helmut Schoeck《嫉妒与社会》(1966);Jante 法则出自 Sandemose(1933)
· 布琳·布朗 2012年 TED 演讲《Listening to Shame》;黄仁勋早年在 Denny's 打工、2024年斯坦福 GSB 演讲原话可查;2025年4月 Meta Llama 4 实验版本上 LMArena 榜单争议
单一来源或需谨慎的说法
· 英伟达员工财务自由、园区内薪酬分化:媒体报道与个人观察,无统计
· Lucas 等(2014)"It's only a computer",发表于 Computers in Human Behavior
· Hill 等(2011)被嫉妒对象更抓注意力、记忆更牢:发稿前核对原文
转述与简化
· Tooby 与 Cosmides"情绪是协调程序"、von Hippel 与 Trivers(2011)自我欺骗理论:文中为简化转述;"嫉妒是相对地位监控器"是作者在 Sznycer 框架上的延伸,并非其原话
· "嫉妒"一词第一人称与第三人称分布:结构性观察,未做语料库统计
· 七宗罪中"只有嫉妒不带快感"的说法见于 Joseph Epstein《Envy》(2003)等通俗论述
作者推断
· "嫉妒是唯一没有结算价的情绪""羞耻是嫉妒的洗钱通道""七宗罪是强制披露清单""溢价是嫉妒的报价""同行嫉妒是最便宜的尽调"均为作者框架
· 关于 AI 能从聚合文本中看见注意力地图、第八节判别表:方法论推断,未使用任何平台用户数据
深夜局 · 硅谷 Alan Walker · 转载请注明出处