ARTICLE · 1177306
AI 认知折叠:你在四层漏斗的第几层?
场景一OpenAI 免费版的语音助手,在短视频里连「我该开车还是走路去洗车店」都答不利索,被做成搞笑合集疯传。
场景二OpenAI 顶配的 Codex 模型,你把终端交给它,它默默干上一个小时,回来时整个代码库已经被它连贯地重构了一遍。
这两件事同时为真。说这话的人叫 Andrej Karpathy——OpenAI 的 11 位联合创始人之一、前 Tesla AI 总监,今年 5 月刚加入 Anthropic 做预训练研究。10 月 11 日晚,他在 X 上发了一条长文,把这种割裂感推向极致:24 小时内近 4 万点赞,Hacker News 盖了 976 层楼。
一条被重提的旧帖:从「各说各话」到「尖锐漏斗」
有意思的是,这条帖子不是新写的,而是他重提了自己半年前的旧帖。四月版本说:关于 AI 能力,「两组人在各说各话」。十月版本升级了措辞——差距已经不是各说各话,而是一个「尖锐的漏斗」,而且在继续拉大。
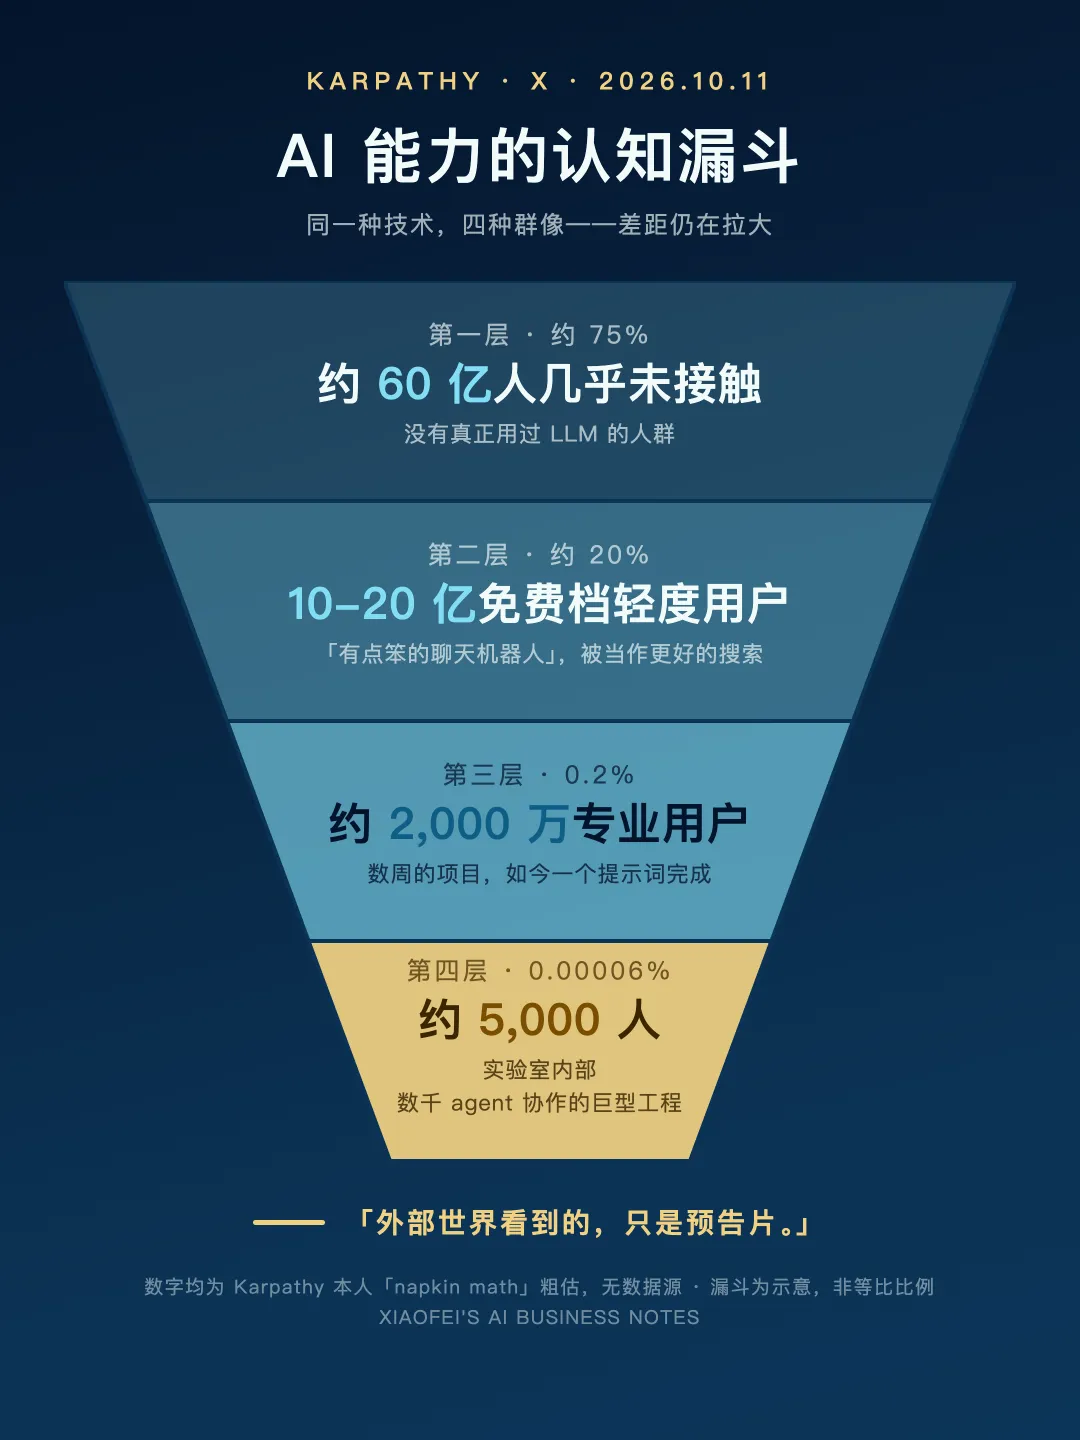
漏斗长什么样?按他的「餐巾纸算术」(他自己承认是随手估的):
第一层约 60 亿人 · 75%
几乎没接触过大语言模型。
第二层10-20 亿人 · 20%
用过免费版 ChatGPT,印象是「有点笨的聊天机器人」,当个更好的搜索或写作助手。很多高管也在这一层——理智上知道,体验是二手的、抽象的。
第三层约 2000 万人 · 0.2%
数学和代码专业用户:过去要几周几个月的项目,现在一个提示词就由 agent 完成。
第四层约 5000 人 · 0.00006%
能在实验室内部接触前沿系统——外部世界看到的只是预告片。
「外部世界看到的,只是预告片。」
The external world has seen the preview.— Andrej Karpathy,2026.10.11
5000 人是什么概念?有中文技术媒体算过一笔账:人类历史上登顶过珠穆朗玛峰的,大约也只有几千人。看过 AI 真实上限的人,可能比登过珠峰的还少。
他凭什么这么说?因为官方数据意外地站在他这边。微软 9 月的全球 AI 普及报告显示:2026 年二季度,全球 15-64 岁人口中使用生成式 AI 的比例只有 18.8%——第一、二层加起来占了八成人口。付费那端更陡:a16z 最新报告里,美国符合条件的消费者只有 4.5% 订阅了任一头部 AI 付费服务;花钱最多的 1% 用户贡献了全行业 19.5% 的收入,比底部一半用户加起来还多。OpenAI 自己的数据也显示,用得最深的头部企业,人均 Token 消耗是普通企业的 8.3 倍。
数字或许粗糙,形状却是对的:AI 的使用,是一个极端的幂律分布。有一个词也许比「漏斗」更准——AI 认知折叠:同一片天空下的人,被折叠进了四层互不相通的认知空间,而且折叠还在收得更紧。
他凭什么这么说:能被验证的地方,能力就疯长
为什么差距长成漏斗形状,而不是均匀分布?Karpathy 给了三个原因,其中一个值得展开,因为它解释了我们日常的大部分困惑。
他在今年 4 月的红杉 AI 峰会上提过一对命题:经典计算机自动化的,是你能「写清楚规范」的东西;这一代 AI 自动化的,是你能「验证对错」的东西。
模型是在强化学习环境里训练出来的——单元测试过没过、证明成不成立,这些能自动判分的地方,能力就猛涨;写作、咨询这类「好不好」说不清的领域,就进步缓慢。再叠一层商业逻辑:训练资源跟着钱走,编码和数学恰恰是企业付费意愿最强的场景。
于是就有了他那个著名的例子:最先进的模型能重构十万行代码、找出零日漏洞,却会一脸认真地劝你——「洗车店只有 50 米远,你走路去吧」。
沃顿商学院的 Ethan Mollick 给这个现象起了个名字:「锯齿前沿」(Jagged Frontier)。他的推论更扎心:一个系统只跟它最差的环节一样好。哪怕 AI 在 95% 的环节上超人,剩下 5% 的短板也会卡死整条流程的完全自动化——所以你在日常里感觉不到「革命」,不是你用错了,是锯齿的深谷恰好铺在了普通人的需求上。
数字准不准?扒开餐巾纸的另一面
四万个赞不代表四个数字都对。第三层的 2000 万介于两组公开数据之间(GitHub Copilot 用户 5000 万、OpenAI Codex 周活 500 万),取决于怎么定义「用 agent 干活」;第四层的 5000 人,则没有任何公开数据可以对照。
Hacker News 上的反对声也不客气,至少有三路:
实验派。有人拿规格驱动开发做了认真测试,agent 从没自主交付过「能叫成品的东西」。更扎心的是 METR 那项著名随机实验:2025 年初,熟悉自己代码库的资深开发者用上 AI 后,完成任务反而平均多花了 19% 的时间。(后续还有个黑色幽默:2026 年研究者想复测,发现越来越多的程序员拒绝参加「禁用 AI」的对照组,实验做不下去了。)
激励派。HN 最高赞的洞见是:大家讨论了那么久 LLM 的「能力之墙」,没想到真实的墙竟然是人类验证输出的能力。马上有人反驳:数学家没动力去审那 722 篇 AI 数学手稿——验证了等于免费给 OpenAI 打工。问题出在激励,不在能力。学界的态度更直接:据中文技术媒体梳理,高等研究院的数学与 AI 顾问组公开要求前沿实验室「停止在专有模型上测试高等数学问题」,数学家陶哲轩也批评过「对领域没有兴趣的 AI 提示员」攻克问题后无法与学界对话。
修辞派。「他故意放弃了所有细微差别,好让这一切听起来更戏剧化」——帖子里确实成立的案例,是移植和翻译这类规则已经写得明明白白的领域。还有更技术性的反对:有人认为难以验证的领域(比如写作)从 GPT-4 到今天的进步其实也很大,只是还没追上专业人士——天花板没动,斜率不小。
最扎的一刀来自结构内部:Karpathy 四月原帖里自己写过,技术域的专业用户是「AI 精神错乱」(AI Psychosis)症状最重的群体。那么,由这个群体——包括他自己——报告的「曲线垂直起飞」,是不是也该打个折?
中间那 2000 万人,到底在干什么新工作
如果你好奇第三层的人到底经历了什么,Anthropic 对约 40 万次 Claude Code 会话的分析给了一个精确的切片:在典型会话里,人类做了约 70% 的规划决策,AI 做了约 80% 的执行决策。人类决定「做什么、什么算完成」,AI 负责「具体怎么做」。
有中文博主把这叫作从「Ask AI」到「Delegate AI」的转变:前者是「帮我查资料、解释这段代码」;后者是「这是目标、工具和验收标准,你去完成,用测试结果向我交差」。
有意思的是 Anthropic 数据里的另一个发现:在生成代码的会话里,非软件职业的用户和程序员的成功率差距已经很小——真正拉开差距的,是使用者对自己领域的理解程度。专家级用户一条指令能驱动 AI 完成的动作数量是新手的两倍以上。
这呼应了 Karpathy 在红杉对谈里的另一句话:「思考可以外包,理解不能外包。」AI 降低的是执行门槛,判断反而更值钱了。
对你我意味着什么:先报模型,再谈观感
所以我的看法是:把「漏斗」当透镜用,把「数字」当修辞看。三层变量——你用什么档位的模型、拿它干什么规模的任务、你的领域好不好验证——确实能解释大部分「AI 观感之争」。至于 5000 人的预告片,保持敬意,也保持存疑。
对每个普通人,这条帖子真正可带走的,是三样东西:
第一,一个朴素的方法论:下次争论「AI 到底行不行」之前,先报四个数——什么模型、什么档位、什么任务、怎么验证。这四项没对齐之前,那场争论没有对象,只有情绪。
第二,一张「不可能清单」。这是 Mollick 的建议:把 AI 目前做不到、但看起来快做到的事记下来(比如「编一个真正有趣的谜题」),每次新模型发布就拿去测一遍。这比刷发布会视频诚实得多——凤凰网有篇评论说得尖锐:发布会替我们预先兴奋,翻车视频替我们预先失望,我们以为在评价技术,其实只是在评价别人替我们挑选的那个瞬间。
第三,一次「委托」的尝试。挑一件你有真实答案可核对的事——对账、代码、翻译——把它连同验收标准整个交给 AI,而不是问它一句话。从第二层爬到第三层,中间隔的不是更聪明的提问,是一个你真正在乎的大问题。
你呢——你觉得自己现在在第几层?欢迎留言告诉我。
信源:Karpathy X 帖(2026-10-11、2026-04-09)及红杉 AI Ascent 对谈(2026-04-29);Hacker News 讨论帖;微软 2026 Q2 全球 AI 普及报告、a16z《Top 100 Gen AI Consumer Apps》第七版、OpenAI 8 月企业报告(经虎嗅整理);Anthropic 40 万次 Claude Code 会话分析(经 Laoer 博客整理);METR 随机实验;Ethan Mollick《The Shape of AI》;团子技术日报、凤凰网科技等。文中所有数字均为 Karpathy 本人估算或注明出处的公开数据,第四层人数无公开数据可核验。