ARTICLE · 1184598
【5】PD必须分离?拆掉路障吞吐大文档!
作者:老高
标签:AI实战 / 降本增效 / 硬件避坑 / 创业笔记
序章:打字飞快,为什么大家还是骂它卡?
在前两期里,我们把全部精力都放在了“打字速度”上(【3】嫌卡慢别急着扔!给4张MI250装上“外挂”,打字速度如何从卡顿到起飞?),成功让模型在单人使用时达到了每秒 140~200 字的极速(【4】找个实习生帮大厨打下手!为什么跑分220的“神仙操作”,一上线就翻车倒退?)。
但当真实用户开始使用时,投诉却铺天盖地而来: “这个模型怎么回事?我刚上传了一份几十页的 PDF 财报,按了回车之后,屏幕上跟死机了一样,足足等了一分半钟,它才慢吞吞开始吐第一个字!”
这就引出了大模型服务中最具欺骗性的一个盲区:
- 打字速度(Decode Tokens/s)
:决定的是回答开始后,看着顺不顺畅; - 首字耗时(Time To First Token, TTFT)
:决定的是按下回车后,要发呆等多久。
如果用户发了一段长达 24 万字(240K Token)的代码仓或者长篇小说,模型必须先在脑子里把这二十几万字完整“通读一遍”,才能决定回答的第一句话是什么。这个通读消化的过程,就叫做 Prefill(预填充)。
在这一阶段,我们必须啃下两块最硬的骨头:让模型能够看高清大图,以及把 24 万字长文本的冷启动阅读时间彻底砍半!
形象比喻:看图写话与读整本长篇小说的煎熬
【通俗比喻:考试开考前的不同状态】1. 普通短聊天: 老师发卷子,上面只有一道脑筋急转弯(几十个字)。 考生扫一眼(Prefill 耗时 0.05 秒),立刻提笔飞速作答(快速 Decode)。────────────────────────────────────────────────────────────2. 超长长文本(24 万字): 老师直接搬上来一整套厚厚的《辞海》。 考生必须强撑着把整套字典读完、在脑子里全部建立起索引,才被允许写第一个字! 如果阅读方法不科学,考生直接在考场上发呆几分钟,甚至当场累晕(显存爆满崩盘)。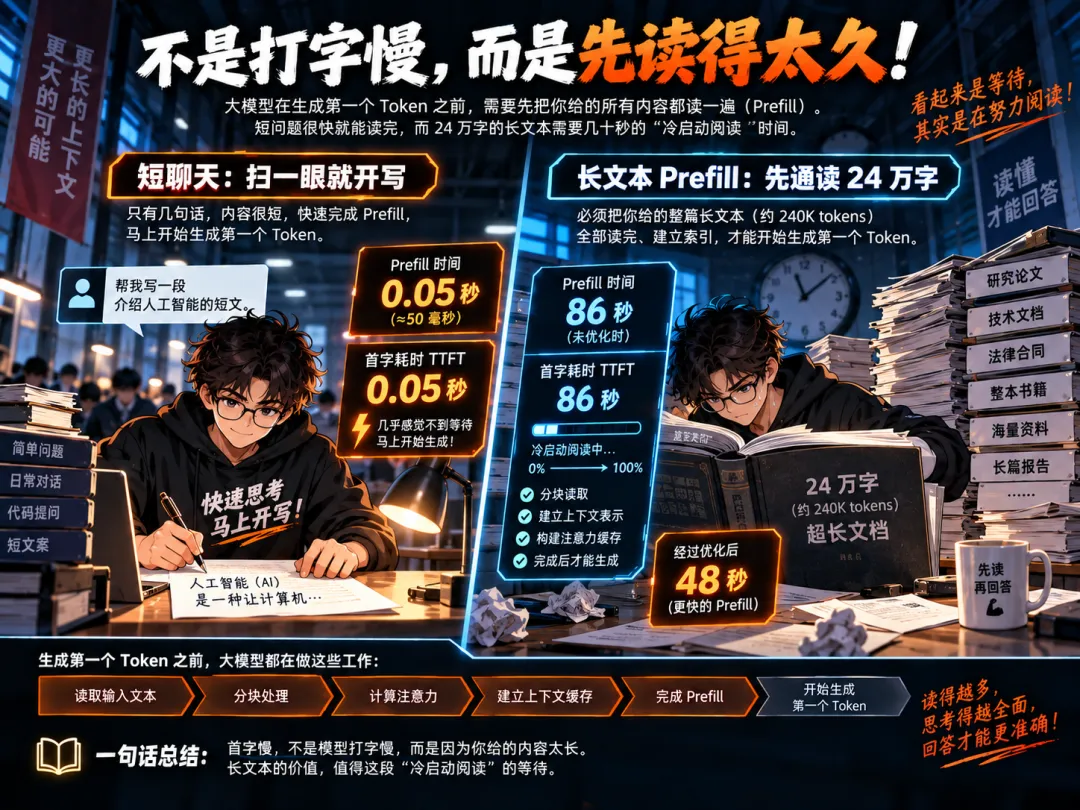
[配图说明]:长文本的 Prefill 是一场纯粹的高密度计算战役。数据量极其庞大,考验的不再是显存带宽的读取手速,而是计算核心高并发吞吐与内存碎片管理的极限承载力。
视觉暗坑:差了区区“1 个 Token”引发的整机死锁
在接入图片识别(视觉多模态)的第一天,我们就遭遇了一次离奇的 GPU 假死事故: 用户输入一张普通图片很正常;但只要传一张高清全景大图,整台拥有 4 张 MI250 的服务器就会当场僵死,没有任何报错,进程直接凝固。
排查日志堆栈后,发现了一行令人哭笑不得的报错:
RuntimeError: device-side assert triggered!token_budget exceeded! (期待 <= 1024, 实际来了 1025)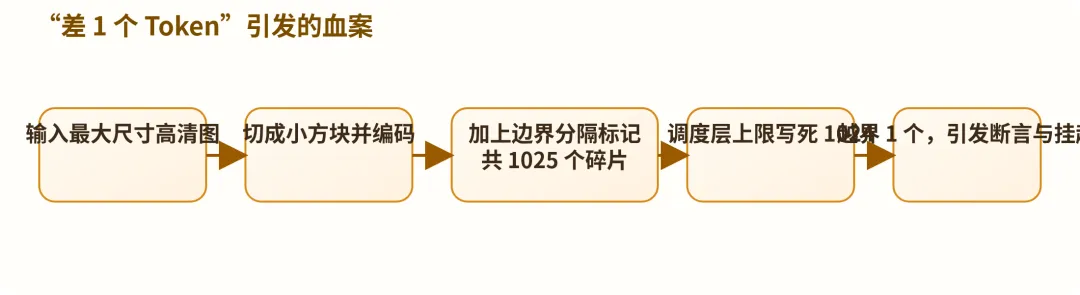
1. 致命的“差 1 个字”
按照视觉切片算法,高清图片被切割投影后,为了告诉模型“这张图到此结束”,末尾必须强行塞入一个特殊的分隔符。 结果切片切出了 1024 个碎片,加上这 1 个分隔符,正好是 1025 个 Token! 而底层系统调度里,有人顺手硬编码写死了一个看似规整的限制 1024。就是这区区 1 个 Token 的预算缺口,让显卡在处理边界时直接撞墙,整套流水线当场宕机。
2. 调大参数之后的“双图连环死锁”
我们把上限调大到 2048,单张大图通过了。但业务测试一发两张大图,整机再次死锁!
【通俗比喻:抢座位的两位大胃王】大胃王 A(第一张大图):占了看图的专用椅子,但还没拿到餐具,等大模型分配资源;大胃王 B(第二张大图):把放餐具的桌子(KV显存空间)占满了,却在死等大胃王 A 腾出看图的椅子。两个人互相干瞪眼,谁也不肯撒手,整间餐厅彻底瘫痪!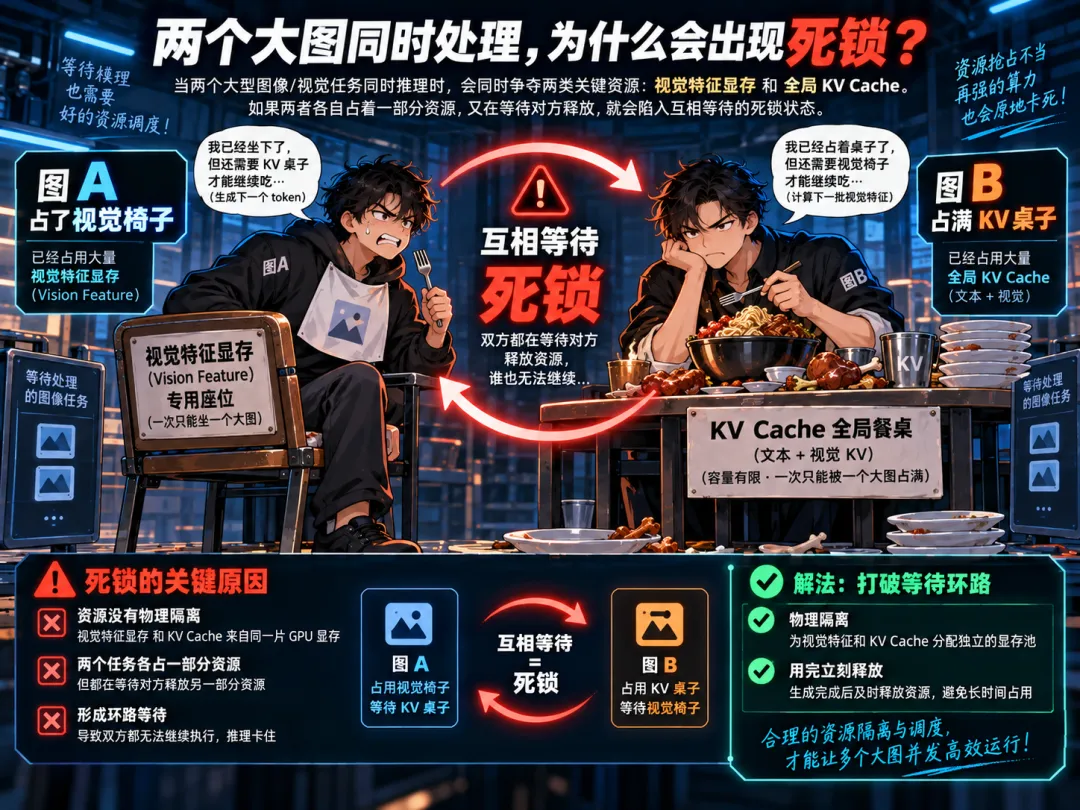
[配图说明]:视觉前置特征显存与大模型全局 KV Cache 显存没有做物理隔离,导致两个并发的大图处理流程相互抢占排他资源,形成典型的死锁环路。
解法干脆利落:给看图的特征显存与正文生成的显存画出绝对的物理隔离带,强制规定单张图片一旦完成视觉特征提取,立刻就地销毁释放,绝不拖泥带水霸占资源。死锁被彻底瓦解。
显存保卫战:别让临时草稿纸把 512GB 显存撑爆!
当长文本测试一路推进到 24 万字(241K Token)时,显存监控再次亮起刺眼的猩红警报: 除了模型本身占用的空间外,仅仅因为输入了这段长文本,运行过程中居然额外暴增了整整 +4.9 GiB 的显存开销!
显存暴涨的祸根
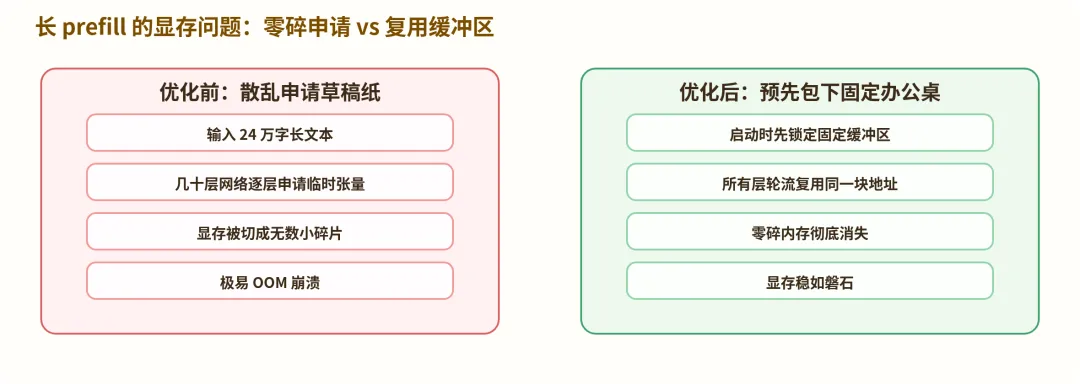
长文本在做注意力检索时,需要生成大量的动态位置转换张量。 原生的代码非常任性,每一层计算时都临时向系统 malloc 申请一块大内存,用完再 free 释放掉。 面对 24 万字这种天文数字,显存管理器在极短时间内被反复拆解,很快就碎成了无数无法连续拼凑的显存孤岛(碎片化)。在多用户并发时,随时可能因为哪怕几兆字节的碎片断层直接 OOM 崩溃挂机。
终极解法:包下固定办公桌
我们改写了显存分配逻辑:在 4 张 MI250 系统开机初始化时,根据设定的最长上下文,预先强行划出一块固定大小的全局公用缓冲区(Pre-allocated Scratch Buffer)。 后续无论是第 1 层还是第 60 层网络,所有临时的中间草稿全部在这一块固定地址里原地覆盖擦写,严禁在推理循环里产生任何运行时的动态显存申请!
实测结果令人震撼:
在 24 万字极限长文本涌入时,运行时的额外显存波动从失控的 +4.9 GiB,被死死锁定在微不足道的 +0.26 GiB!
核心战役:241K 巨型文本通读耗时,从 86 秒砍至 48 秒!
显存稳住了,但那个最扎眼的痛点依然摆在眼前: 24 万字长文本,冷启动阅读足足要等 86 秒! 相当于用户上传一个工程,就得在电脑前硬生生发呆将近一分半钟。
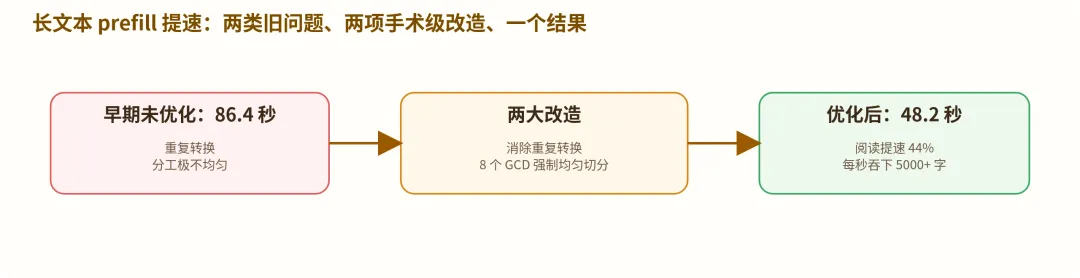
我们对 Prefill 流水线动了两次大手术:
- 砍掉代码里的“无用返工”
:日志分析抓出了一个惊人的历史包袱:为了兼容旧接口,稀疏检索模块竟然在不同的分支里,把同一批超长输入连续重复进行了 3 次一模一样的矩阵转换! 在短文本下这多出来的两次乘法只要几微秒,但在 24 万字的量级下,这无意义的返工白白烧掉了 14 秒!我们将其精简为一次计算、全周期复用; - 跨 8 个计算芯片重新分摊任务
:4 张 MI250 拥有 8 个独立的 GCD 芯片。原先的分块算法粒度太粗,导致前两个芯片忙得快要着火,后面六个芯片有一半时间都在干等。我们重构了长序列的分块发射策略,将超长前缀均匀平摊到 8 个芯片上同时消化,彻底消除了木桶短板。
阶段验收:冷读与续聊,千万别被宣传忽悠了!
在同样的硬件环境下,我们在 241K 长度的真实超长 Prompt 上复测,结果如下:
241K 超长上下文优化对照表
| 241K 首次冷输入首字耗时 | 86.4 秒 | 48.2 秒 | |
| 长文本临时显存暴增 | +4.9 GiB | +0.26 GiB | |
| 极限高清大图处理 | 1025 Token 稳定通过 | ||
| 多轮对话已有缓存时的首字 | ~1.3 秒 |
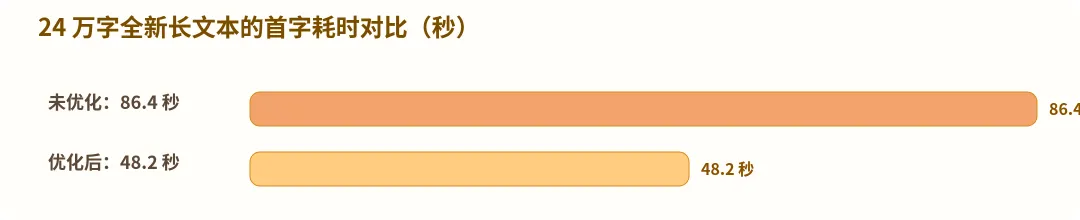
这里必须给广大读者科普一个行业防坑常识: 很多厂商宣传“支持 20 万字超长文本,首字响应只要 1 秒钟”,这种测试往往是在“多轮续聊且缓存命中(Prompt Cache Hit)”的理想状态下测出来的。 因为那 20 万字早就已经躺在显存里了,模型只是顺着往下说,当然只需要 1 秒; 但如果是用户第一次把一本全新的 24 万字小说拖进窗口,模型必须一五一十把所有矩阵完整算一遍,在这套 4 卡 MI250 拓扑下,48 秒 是我们榨干了所有算力后拿到的真实物理极限!
下期预告: “看图能看了,长篇小说能啃了,单人打字也飞快。 但当我们信心满满地把并发测试从 16 个人一路拉到 32 个人同时在线时,整机性能再次发生断崖式暴跌! 每次修改一个算子,真的要在电脑前坐等 7 分钟重启整台大服务器吗? 下一期,我们将推翻传统的调试模式,搭建一套如同‘F1 赛车零件风洞’的独立试验台! 随后,我们将迎来真实工程中最刺激的三个连环大反转,并在 32 路真实并发下,第一次将整机吞吐打穿千字大关……”