ARTICLE · 1187907
看懂OpenClaw底层逻辑:网关、记忆、工具调用,到底怎么配合?
上一期我们搞清楚了OpenClaw是怎么从“聊天”走向“干活”的,知道了它有大模型当大脑🧠、有Gateway当调度、有Skills当技能包🎒、有Tools当工具箱🧰。但这些东西,到底是怎么串起来的?
就好比你知道厨房里有灶台、有锅、有菜刀、有食材。但你还是不知道,一道菜到底是怎么从“点单”变成“端上桌”的🍳。
今天这期,我们就来拆一拆OpenClaw的底层逻辑。
简单说,OpenClaw能自己干活靠的是三件核心的事:一个调度中心、一个记忆系统、一套工具调用机制。再加上两个关键的设计前提:本地优先运行和沙箱隔离。
我们一个一个来👇。
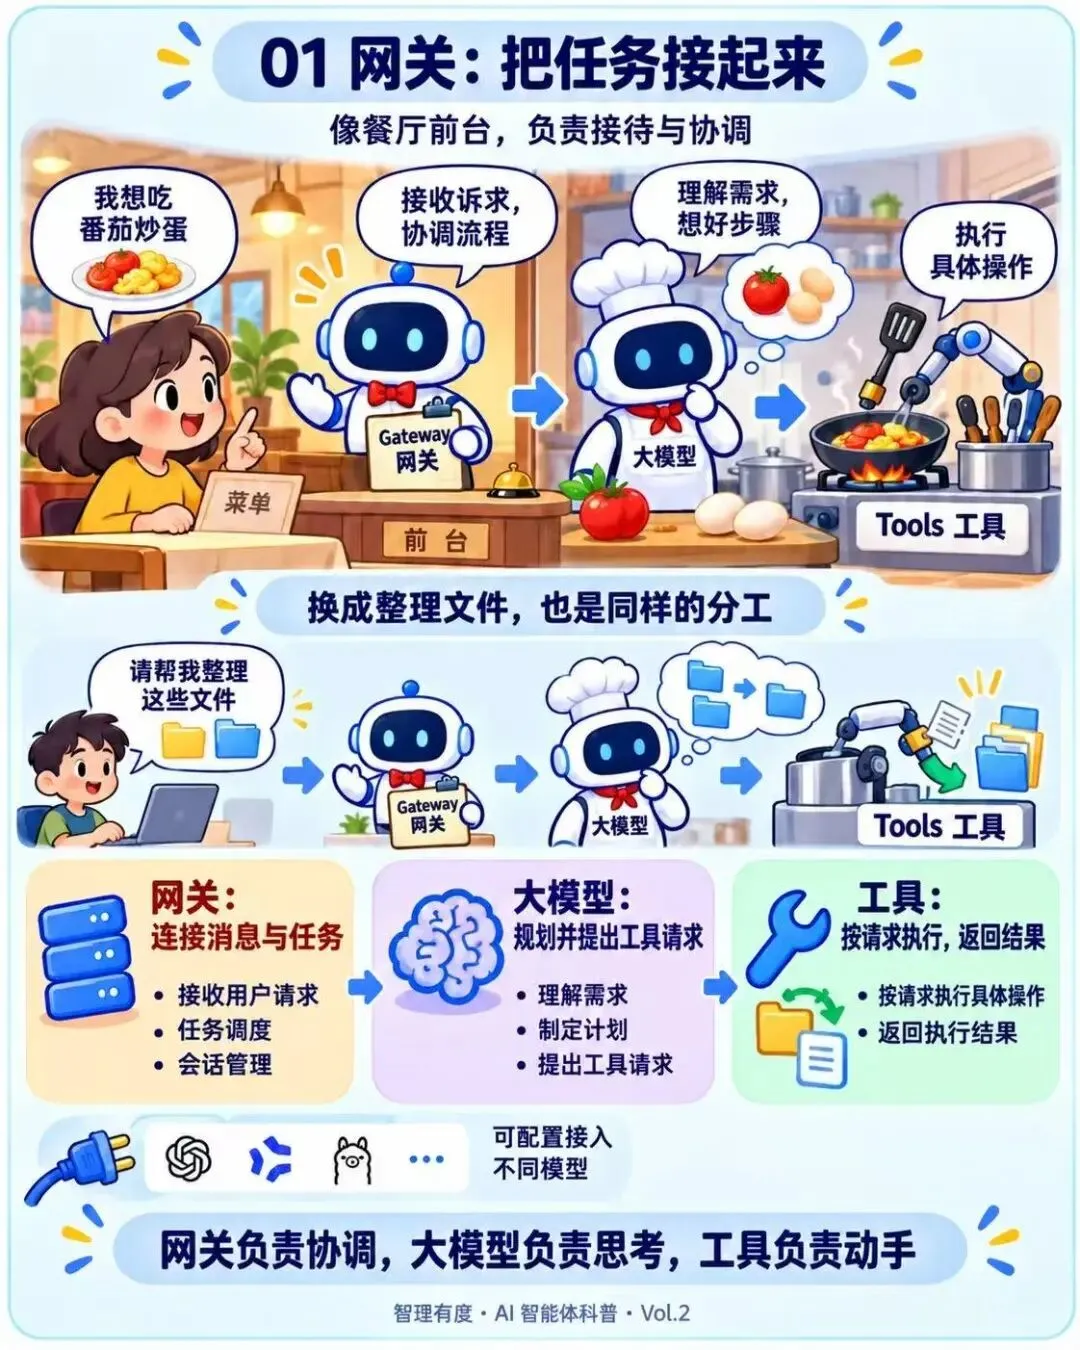
OpenClaw的Gateway,干的活跟这个前台几乎一模一样。
用户提出任务之后,Gateway要做的第一件事是接住请求。它得先搞清楚:你这句话到底是要干什么。这个判断,Gateway自己不做。它交给大模型去做。
大模型就像后厨的“主厨”👨🍳,负责“想”——这个任务该怎么拆、需要几步、每一步要什么能力。但大模型“想”完之后不会直接动手,它会把“我想干什么”告诉Gateway。Gateway再根据这个需求,去决定调用哪个Skill、哪个Tool、以什么顺序执行。
所以Gateway的核心职责,不是“思考”,而是把“想”和“做”连接起来。
这里还有一个很关键的设计:OpenClaw的Gateway采用的是标准化协议。就是说,它不绑定某一个特定的大模型。你今天用Claude,明天想换成GPT,或者换成国产的某个模型。Gateway不需要重写一套调度逻辑。换个“主厨”就行👌。
这也是OpenClaw被称为“开源智能体操作系统”的原因之一——它把调度这件事,做成了一个通用层,而不是跟某个模型绑死。
如果你用过ChatGPT或者类似的聊天AI,你肯定遇到过这种情况:上午你跟它说“帮我整理一下桌面文件”,它帮你整理好了;下午你问它“刚才整理的那些文件放哪了”,它一脸茫然:“什么文件?”🤷
这不是它故意装傻,而是大模型本身有一个硬伤:每次对话都是一张白纸,都是独立的,它没有“上一次”的概念。
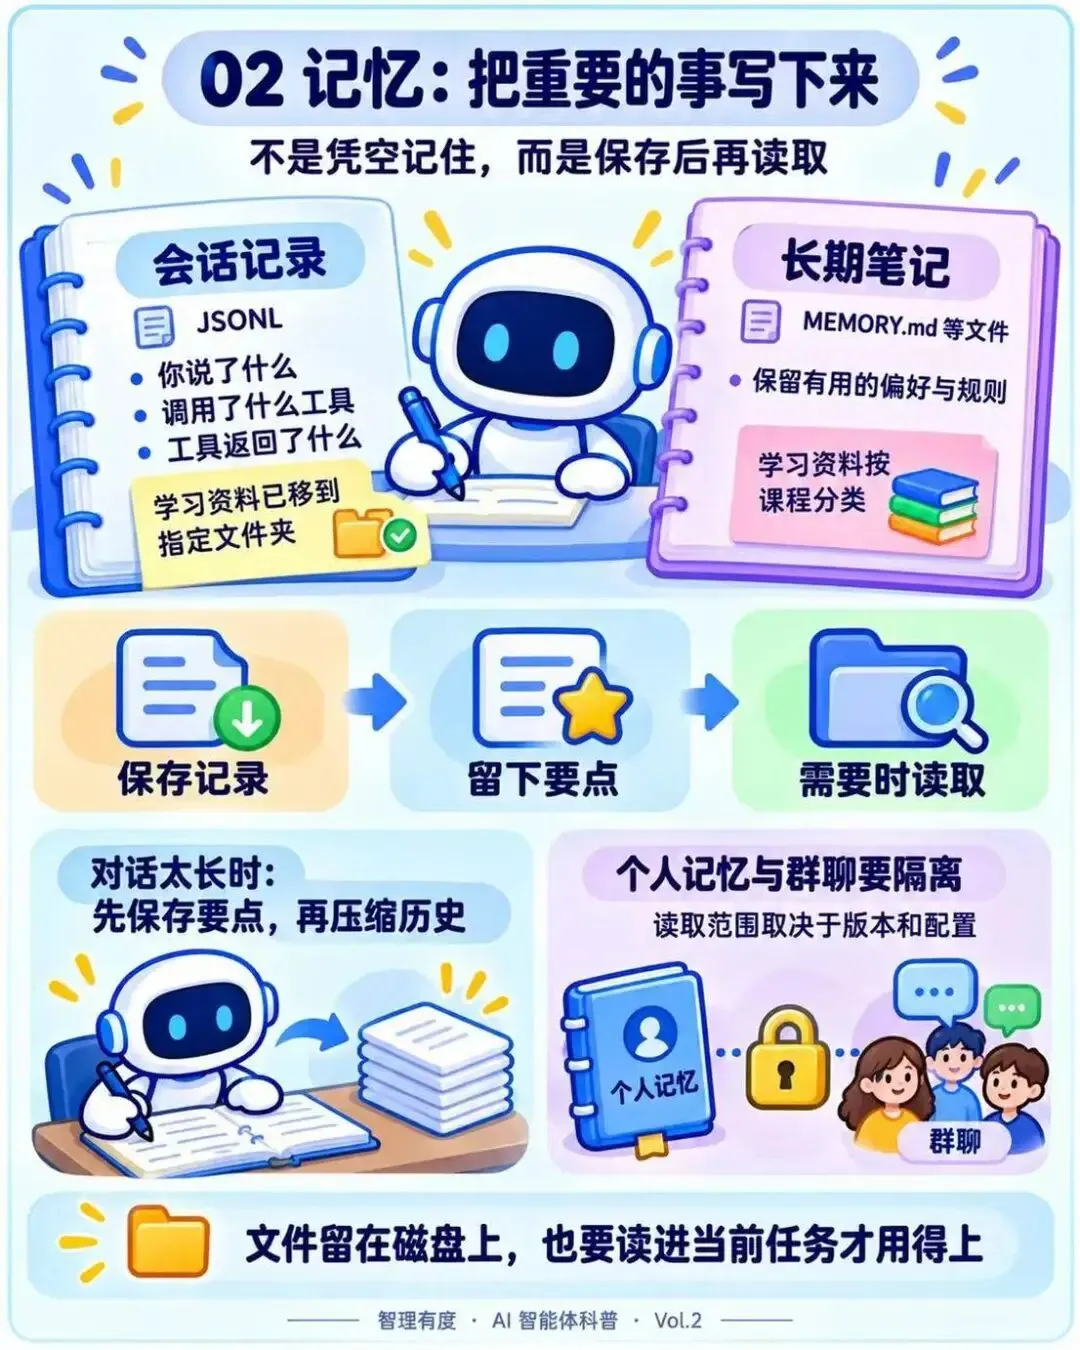
而OpenClaw解决这个问题的做法很“朴素”:用文件系统来做记忆。就是你自己电脑上那种文件夹和文件。OpenClaw把“记忆”这件事,变成了“往硬盘上写东西”。
具体来说,它有两层记忆:
▸第一层,短期记忆。每次会话的原始记录,会以JSONL格式存在本地。你可以把它理解成“今天的流水账”📝——你说了什么、它做了什么、中间调用了哪些工具,全都记下来。
▸第二层,长期记忆。有一个叫MEMORY.md的文件,存放的是精炼后的重要信息。记住那些“以后可能还用得上”的东西。比如你的偏好、你之前交代过的规则、某个任务的背景信息。
这里有一个对隐私场景特别重要的细节:MEMORY.md只在用户直接对话时加载,群聊场景不加载。
因为长期记忆里可能有个人偏好、工作习惯、甚至某些敏感上下文。如果在一个群聊里,智能体把这些信息带出来,就等于当着所有人的面把你的底牌翻开了。
所以OpenClaw做了一个很明确的隔离:私聊有记忆,群聊不带记忆。
“用文件做记忆”意味着本地优先。你的记忆数据,存在你自己的电脑上。而不是某个公司的服务器里。
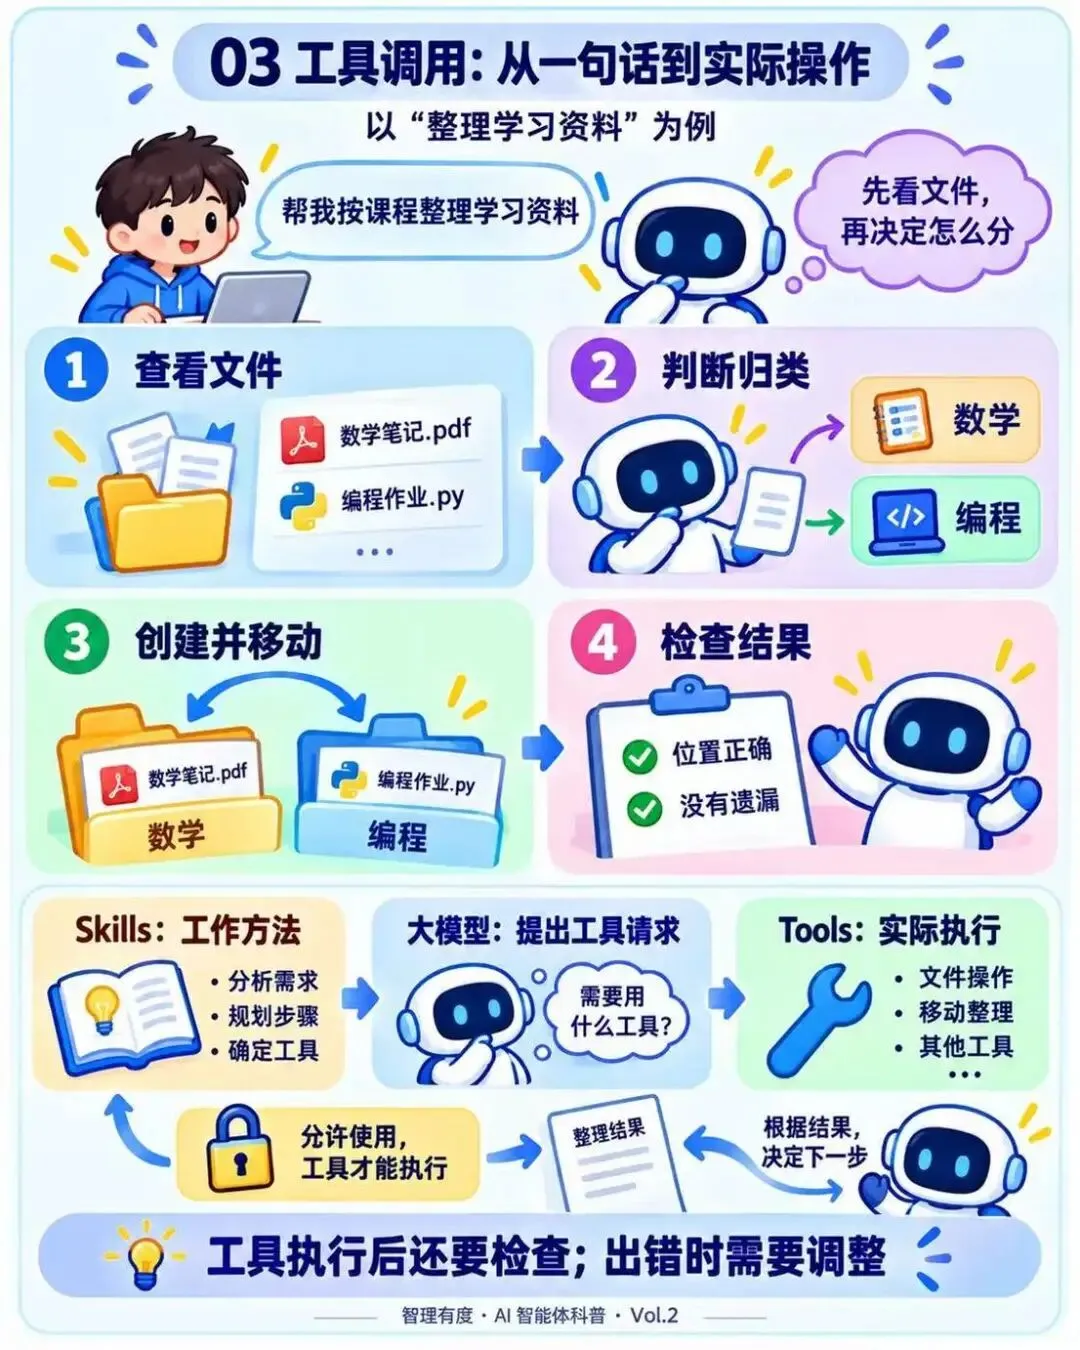
我们回到那个整理文件的例子。你说:“帮我把学习资料整理一下🗃️。”OpenClaw内部发生了什么?
第一步,大模型判断:这个任务需要什么能力?
它得出的结论是:需要“查看文件”“判断类型”“创建文件夹”“移动文件”这几项操作。
注意,这时候它只是在“想”,还没有动手🧠。
第二步,Gateway把这些需求翻译成具体的“工具调用请求”📝。
比如“列出桌面上的所有文件”“读取每个文件的扩展名”“在桌面创建一个叫‘学习资料’的文件夹”等等。
第三步,真正执行的是Tools(工具),不是大模型本身。
大模型只负责“决定要做什么”,工具负责“实际去做”。
这个分工很重要——大模型可以“想错”,但工具的执行是确定的。你让它“移动文件”,它就移动文件,不会自己发挥🔧。
那OpenClaw的工具是怎么组织的呢?它是分层的:底层是编码工具,比如读写、编辑文件;中间是平台能力工具,比如浏览器操作、消息发送、网页搜索;上层是插件工具,也就是第三方开发者扩展出来的能力。每一层都有对应的权限策略,不是所有工具都默认开放,也不是所有智能体都能调用所有工具。你给它什么权限,它才能用什么工具🔐。
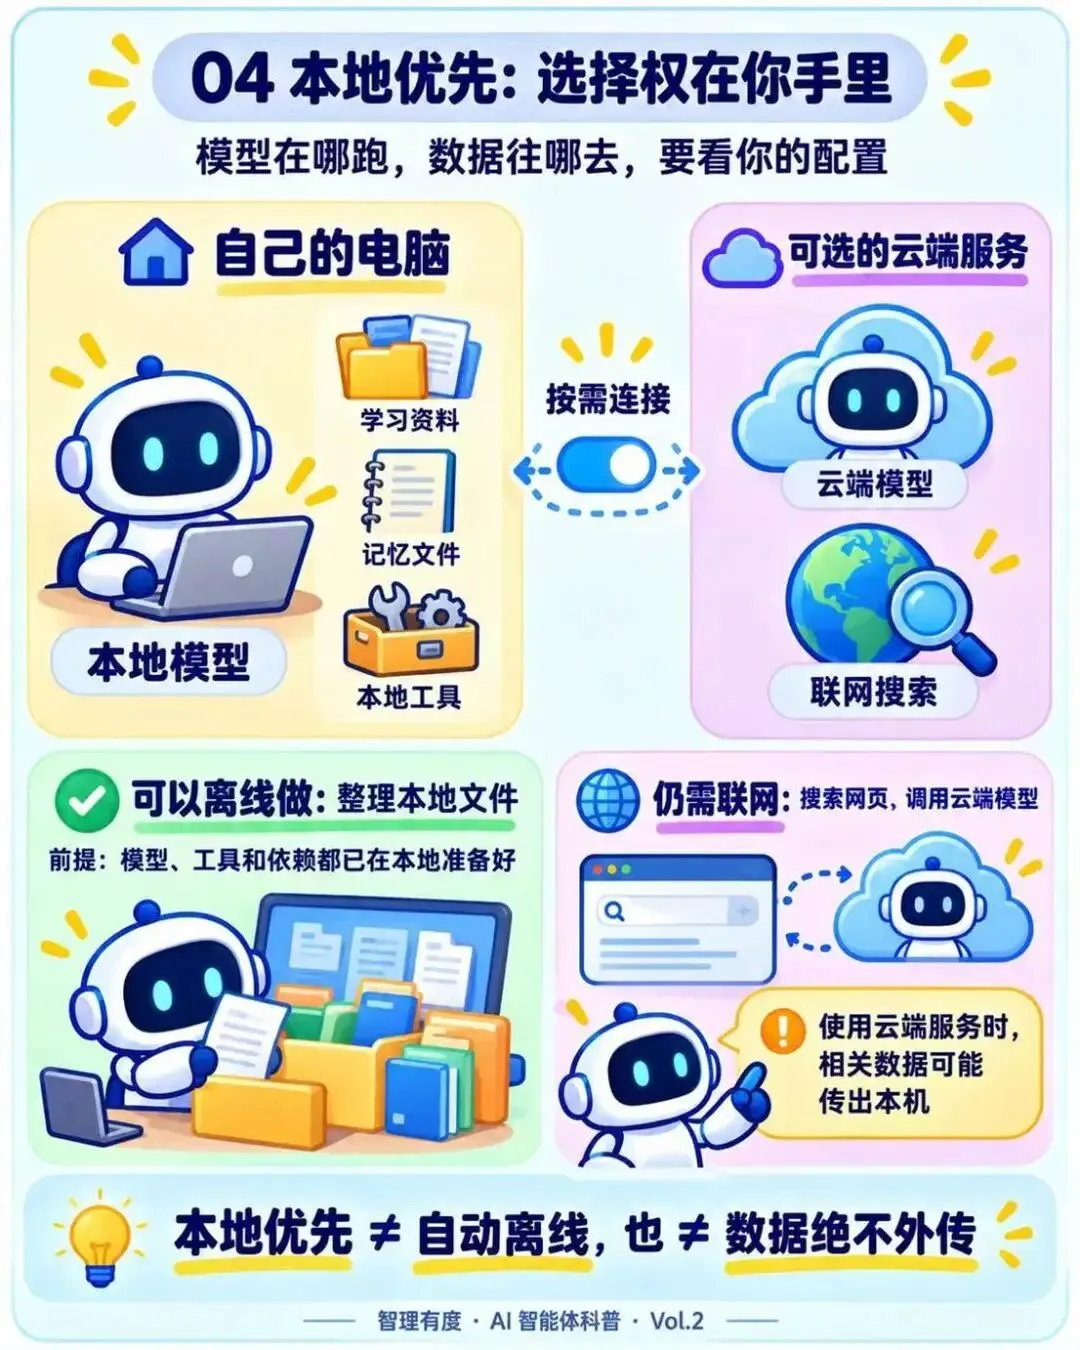
普通的云端AI是怎么工作的呢?你把问题发到某个公司的服务器上,服务器上的模型算完之后,再把结果传回来。整个过程,你的数据是“出去过”的☁️。
但OpenClaw的本地优先设计意味着:模型可以本地跑,数据可以本地存,任务可以在断网环境下执行。
本地优先,图的是控制权。
云端AI的逻辑是“你把数据交给我,我帮你算”;本地优先的逻辑是“数据留在你手里,算力也在你手里”。前者方便,后者可控。
🔘至于这种“数据留在自己手里”的设计,在具体场景里意味着什么,我们后面聊法律问题的时候还会再提到。
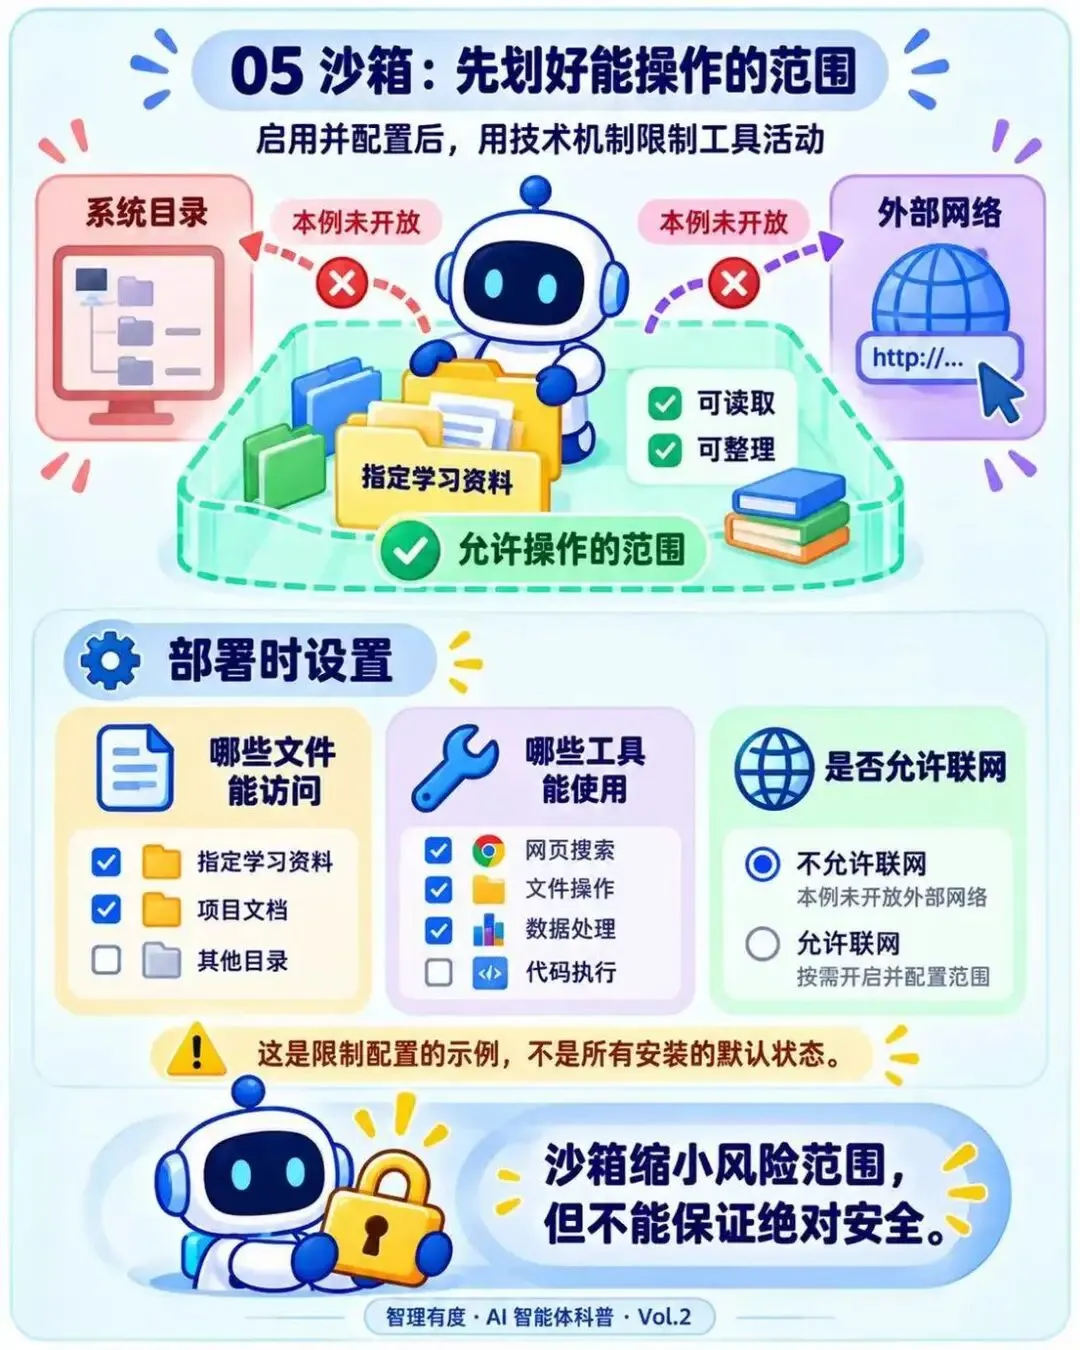
现在我们知道OpenClaw能调度、能记忆、能调用工具,还能在本地跑。但还有一个问题:它会不会乱跑?
比如,你让它整理桌面文件,它会不会顺手把系统文件夹也翻了?你让它查资料,它会不会自己连上某个不该连的网络?
这就是沙箱要解决的问题。
沙箱就像“给小朋友划一个铺了软垫的游戏区”🧸,小朋友可以在里面随便跑、随便玩,但跑不出这个圈。
具体到技术上,沙箱做的事情是:限制智能体能访问哪些文件、能调用哪些系统接口、能连接哪些网络地址。
你可以把它理解成:即使智能体“想”去访问一个不该访问的文件夹,沙箱也会在它迈出去之前拦住它。
而且这种拦截,是在操作系统层面实现的,不是靠“智能体自觉”。“自觉”这种东西,在技术系统里是不靠谱的,你不能指望一个AI说“我保证不乱跑”,你得用机制让它“想跑也跑不了”🚧。
沙箱还有一个好处:它让智能体的行为变得可预测。
你知道它只能在划定的范围内活动,所以你可以在部署之前就评估风险——它最多能碰到什么、最多能改什么、最多能连什么。
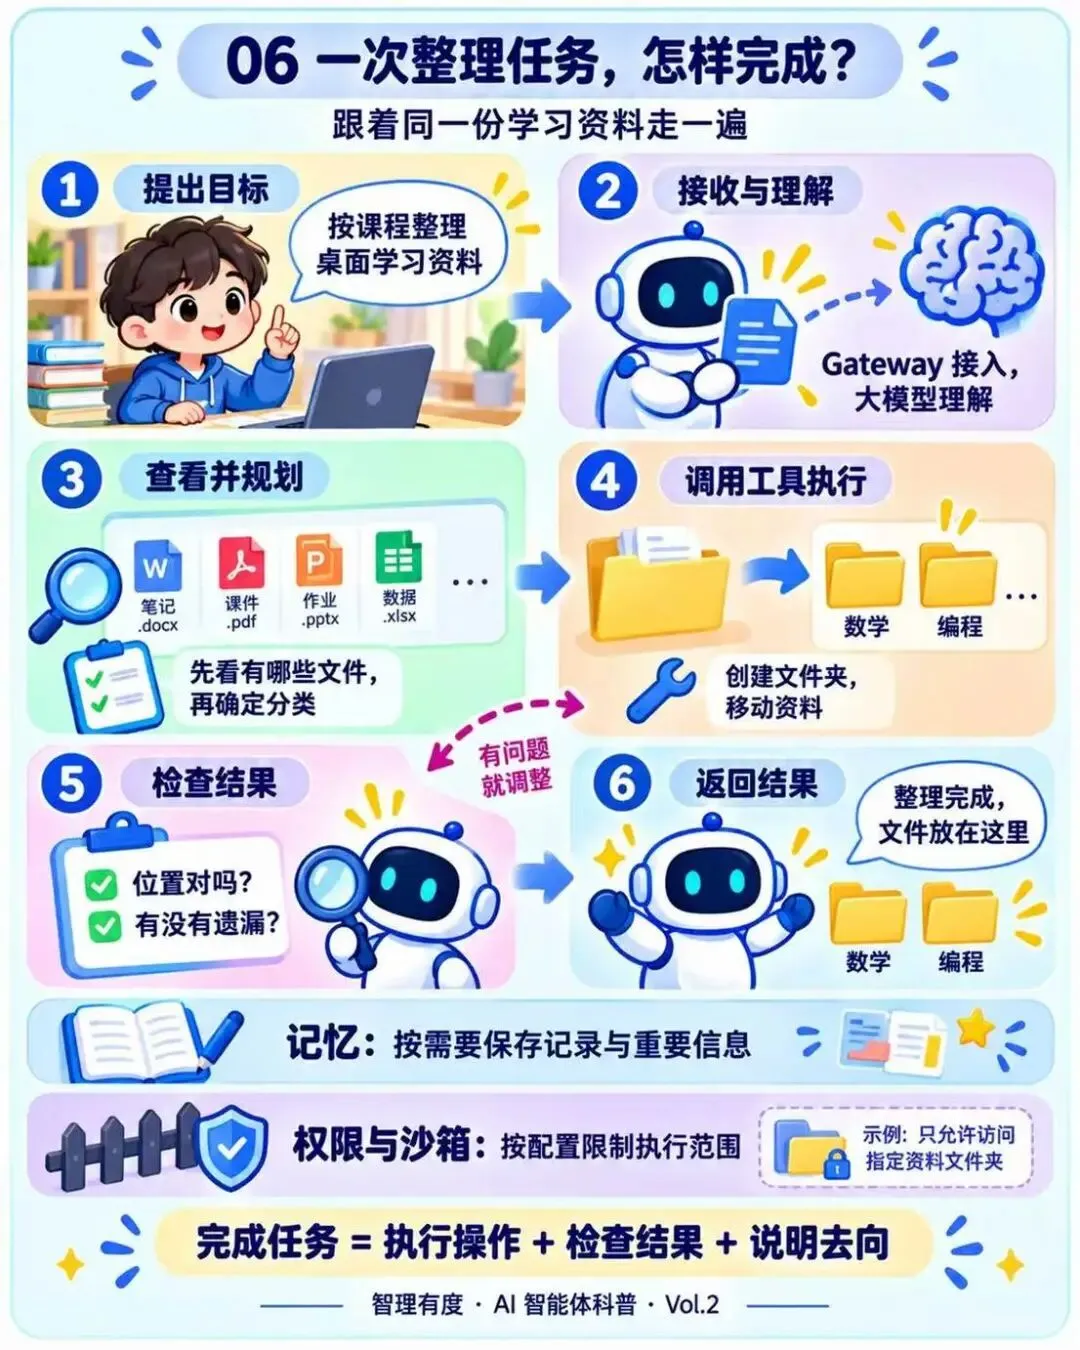
我们现在把上面讲的几个东西放在一起,看看它们是怎么协同的。
假设你对OpenClaw说:“帮我把桌面上的学习资料整理一下。”
第一步,Gateway接住请求。它把这句话传给大模型,让大模型判断:这是一个“文件整理”类任务。
第二步,大模型制定计划。它想好了:先查看文件,再判断类型,然后创建文件夹,最后移动文件。
第三步,Gateway调度工具。它根据大模型的计划,依次调用“列出文件”“读取扩展名”“创建文件夹”“移动文件”这些工具。
第四步,记忆模块同步记录。整个过程中,短期记忆在记流水账,长期记忆在判断哪些信息值得留下来。
第五步,沙箱全程限制范围。智能体只能访问桌面和指定文件夹,不能碰系统目录,不能连外部网络。
第六步,结果返回。任务完成,告诉你“整理好了”✅。
|写在最后
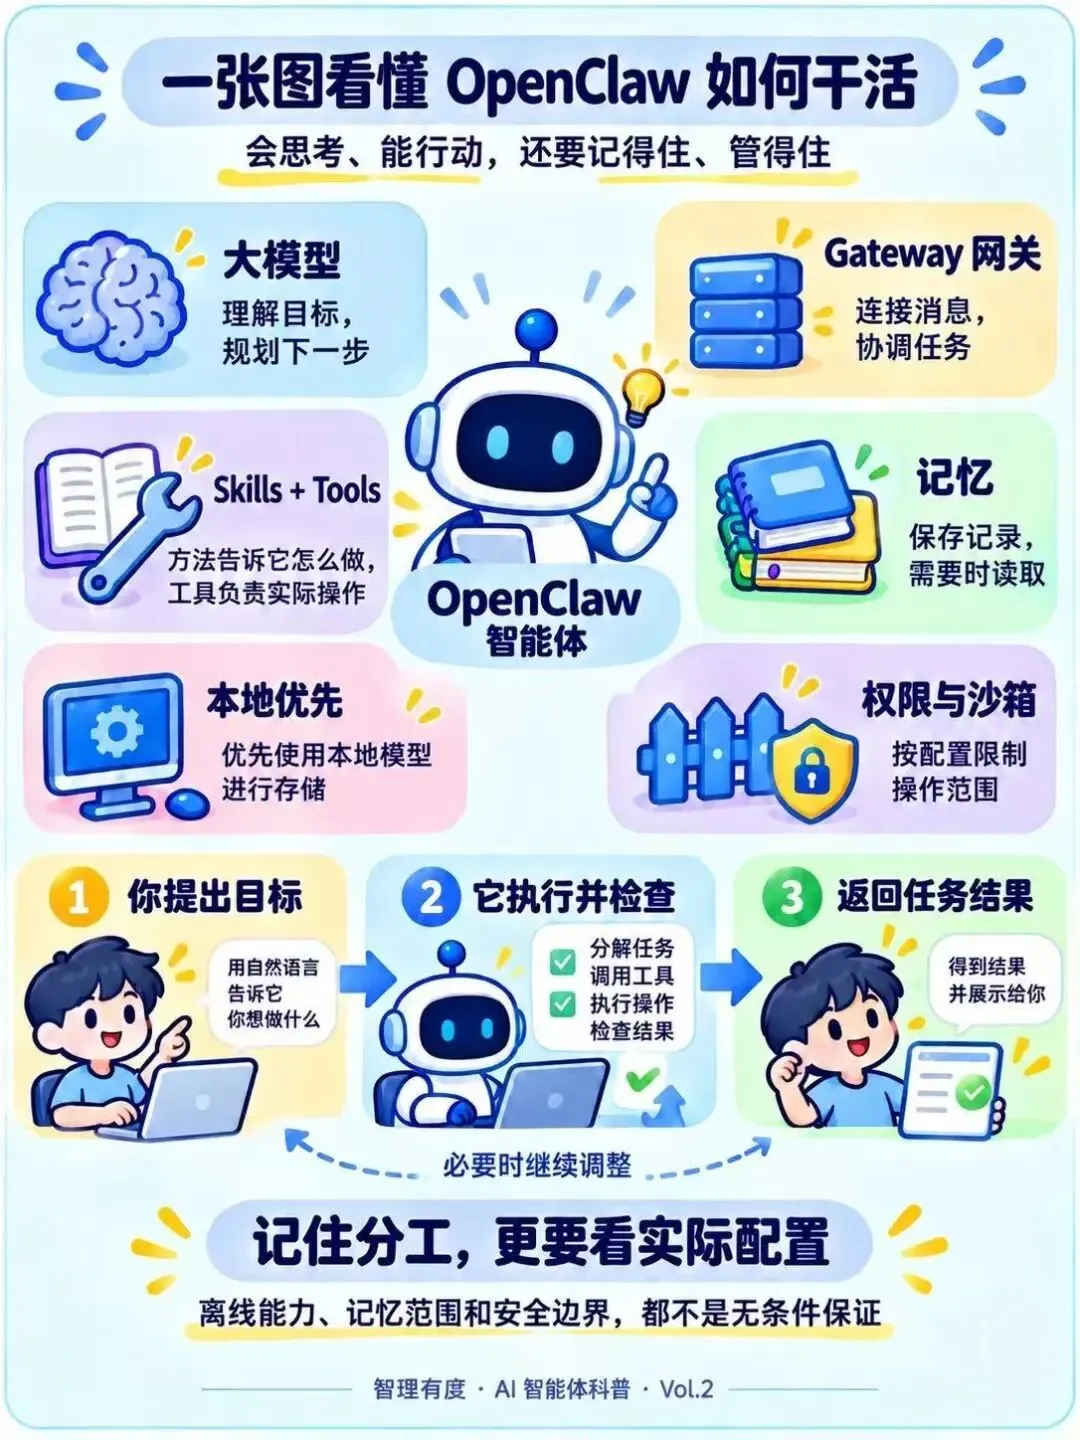
Gateway负责串联,大模型负责思考,工具负责执行,记忆负责积累,沙箱负责兜底。缺了任何一个,这件事都做不成。这些设计加在一起,才让OpenClaw有可能在政务这种敏感场景里落地。
而能不能真的落地、落地之后会带来什么法律问题,就是我们下一期要聊的事了。
|留言区聊聊
今天聊了几个设计,你觉得哪一个对政务场景最重要?
A.记忆存在本地,数据不出内网
B.沙箱隔离,智能体跑不出划定范围
C.工具分层,权限可以精细控制
D.本地优先,断网也能用
|下期预告
技术讲完了,法律问题就来了。
当AI真的开始“动手”了,法律上到底算谁在行动?它有没有“法律主体资格”?出了问题,谁来担责?
撰稿|郭睿
图片|郭睿
排版|雷逸扬
初审|王怡彤 安琪日
终审|王晶