ARTICLE · 1203295
Meta霸王条款惹怒全网:不让AI白嫖独立网站,就停用账号!被扒后连夜删词
2026年10月初的一天,独立网站“蒸汽朋克探索者”(Steampunk Explorer)的创始人斯蒂芬·比尔(Stephen Beale)像往常一样,打开了Meta的企业管理后台。
屏幕上弹出一道毫不起眼的浅色横幅。上面写着:《Meta商业服务条款》即将更新,并于2026年10月30日正式生效。
互联网巨头的服务条款动辄上万字,谁会逐字读完?但比尔偏偏多看了一眼在这份看似例行公事的合同里,藏着一只手,正越过社交平台的围墙,伸向他自己独立运营的网站。
比尔立刻把线索捅给了哈佛大学尼曼新闻实验室(Nieman Lab)。10月15日,尼曼实验室联合三位顶尖法律专家抛出深度调查,整个北美科技圈与传媒业瞬间炸锅。
原来,Meta在条款里埋下了一记重锤:只要你继续用Facebook、Instagram或WhatsApp的商业账号营业,就等于默认授权Meta派出爬虫,去掏空你站外的独立网站,拿去训练它的AI大模型。
不想被白嫖?条款里没有单独的“关闭抓取”开关条款列出的退出方式,是停止以商业目的使用Meta产品。
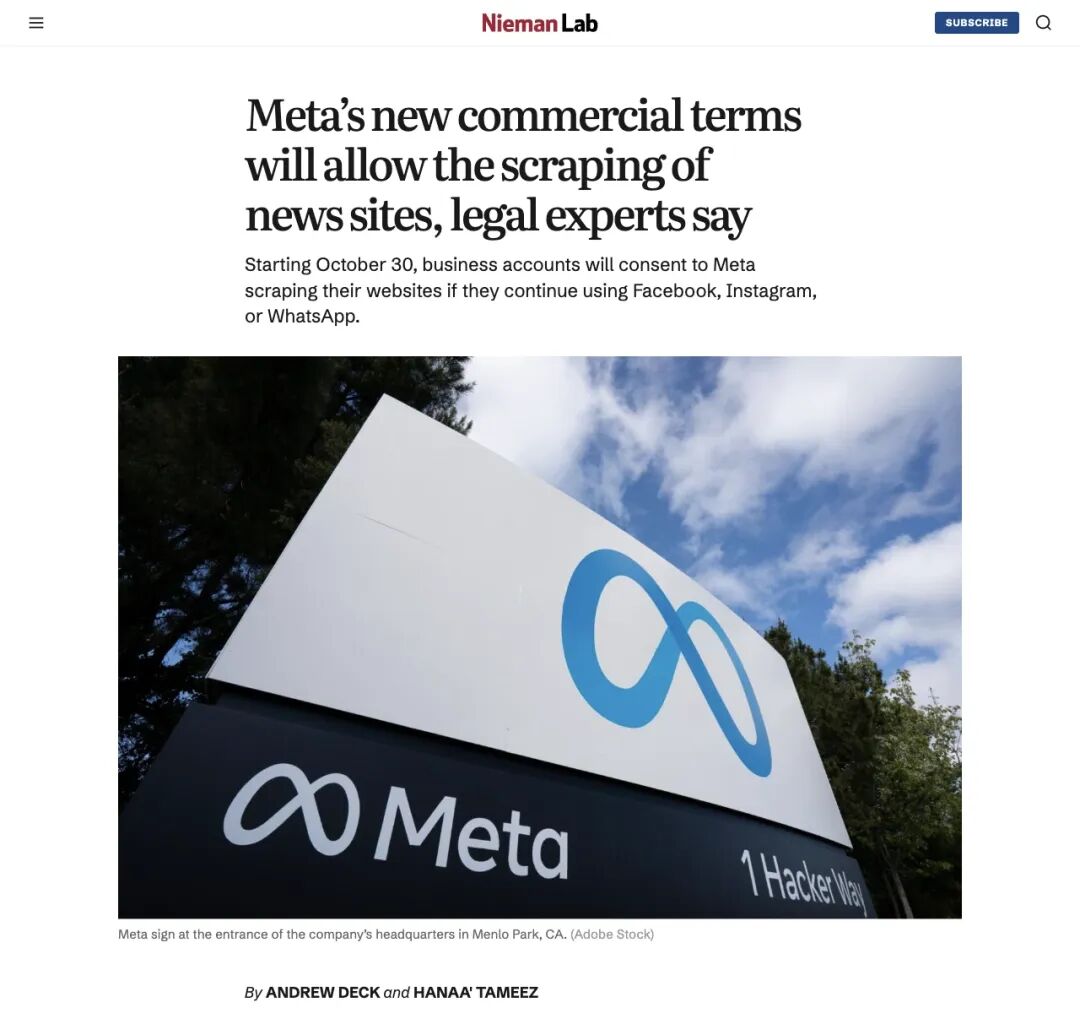
▲ 哈佛尼曼新闻实验室报道Meta新条款及法律专家的担忧
01围墙外的“特洛伊木马”:用你的账号,抄你的老家
这波操作涉及一个基本概念:什么是“商业服务条款”(Commercial Terms)?
普通人发发生活照、聊聊天,签的是个人用户协议,平台最多惦记你发在站内的动态。但只要你是媒体、品牌商、网店店主或自媒体创作者,想在Meta旗下运营主页、投放广告、使用WhatsApp商业版,你就必须签这份“商业条款”。全世界的媒体机构和品牌商,几乎人人都有至少一个Meta企业账号。
而在尼曼实验室曝光的初版新条款中,Meta塞进了这样一段话:只要企业继续使用Meta服务,即视为授权Meta使用网络爬虫、机器人等自动化工具,去访问、索引、缓存并抓取“与你的产品或服务相关联”的外部域名和网页;Meta可以使用抓来的任何内容,去开发、改进、研究和训练(train)旗下的产品与功能。
这段话里藏着两个让法律界倒吸凉气的魔鬼细节:
第一,它把爪子伸到了“围墙之外”以前平台薅羊毛,薅的是你发在它服务器上的帖子;现在,哪怕你在自己的独立网站上辛辛苦苦写了深度报道、整理了独家的商品数据库,只要这个网站跟你的Meta企业号“相关联”,Meta就主张有权顺着网线爬过去,把你的老家搬空。数字媒体高管杰森·金特(Jason Kint)一针见血地指出:这相当于在没有签署任何版权许可协议的情况下,强行征用全网数据,去喂养包括Muse在内的Meta AI帝国。
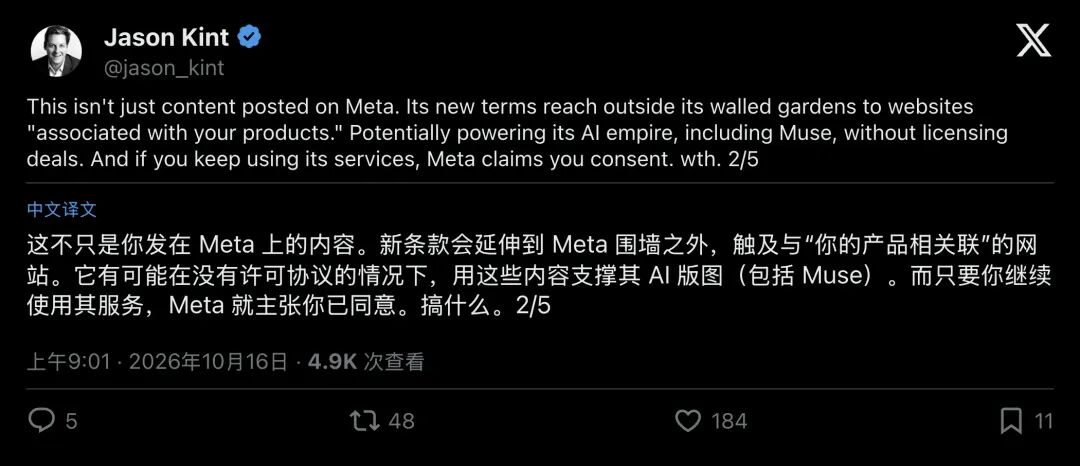
▲ Jason Kint指出,新条款越过了Meta的社交围墙,直接伸向企业站外的独立网站
第二,条款居然要求企业允许Meta创建“测试凭证”(test credentials)。什么是测试凭证?康奈尔大学法学院教授詹姆斯·格里梅尔曼(James Grimmelmann)点破了其中的玄机:从技术上讲,这等于允许Meta的爬虫在你的网站上“注册成虚假用户”,甚至大摇大摆地绕过你的注册墙和登录限制。
更讽刺的黑色幽默还在后面就在不久前,Meta刚刚开始推进“Meta One”订阅服务,对部分账号在站内发外部链接设置额度限制,想多发外链就得掏钱。把这两件事放在一起看:部分账号在Meta上发通往自己网站的链接,要给Meta交过路费;而Meta顺着链接抓取网站内容,却可能无需另付许可费。
面对这种“要么交出网站数据,要么自断流量活路”的二选一,代表上千家出版机构的新闻/媒体联盟(News/Media Alliance)直接掀了桌子,发表严厉声明痛斥该条款“令人愤慨,而且很可能违法”,是赤裸裸地滥用市场垄断地位。
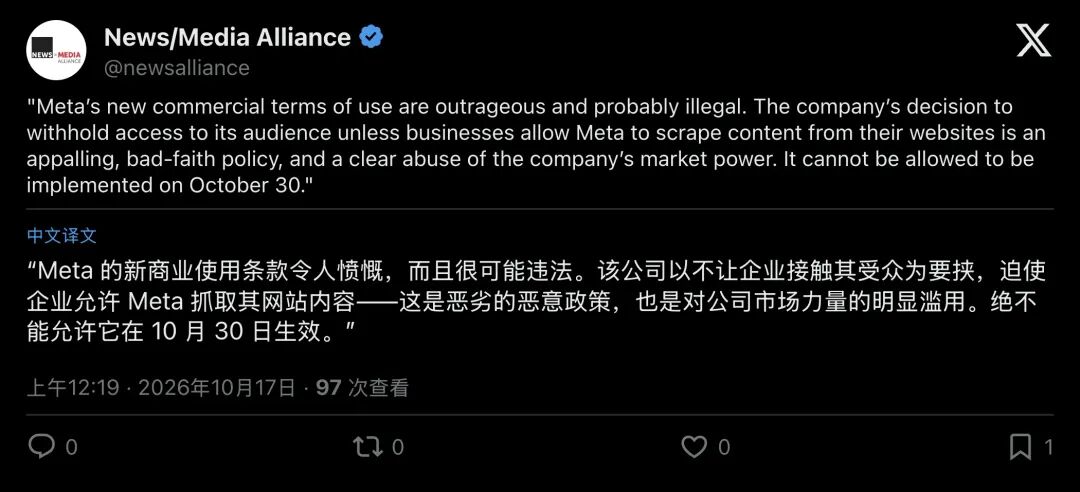
▲ 新闻/媒体联盟发表声明,痛斥Meta以切断受众触达相要挟,绝不能允许在10月30日实施
02公关翻车现场:“君子协定”挡得住“卖身契”吗?
舆论海啸在10月16日全面爆发眼看火烧连营,Meta传播负责人安迪·斯通(Andy Stone)坐不住了,在X平台上紧急转发相关汇总帖辟谣:
他称“这是假的(This is false)”,并表示Meta使用网络爬虫的方式没有变化,内容所有者仍可用robots.txt表达偏好。他将更新的目的解释为在站内广告和推荐时拉取第三方网站的在售商品信息,否认其针对新闻网站。
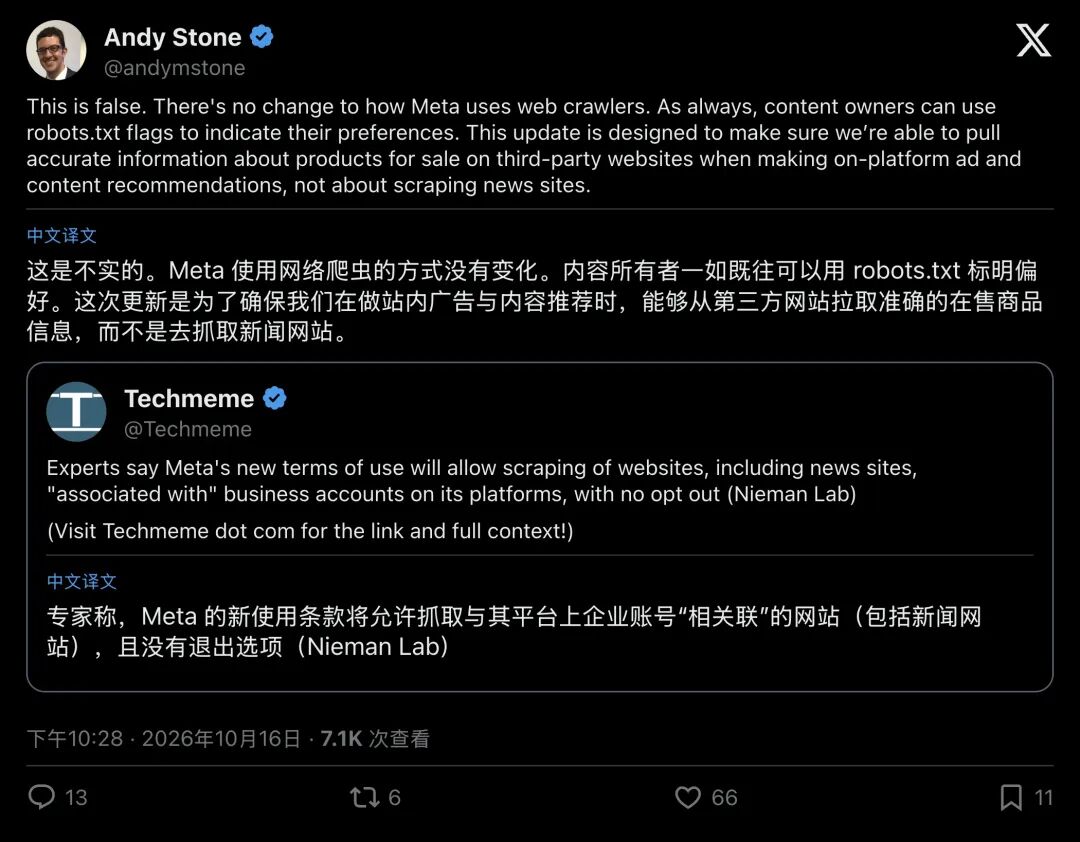
▲ Meta传播负责人Andy Stone出面灭火,坚称“这是假的”并搬出robots.txt作为挡箭牌
这番官方灭火,非但没能平息众怒,反而成了大型逻辑翻车现场。
网友史蒂夫·白金汉(Steve Buckingham)立刻在评论区送上了一记精准的逻辑绝杀:“人家原帖说的是你的新条款将‘允许’(allow)你这么干,又没说你‘现在正在’这么干。你回一句‘这是假的’,简直是答非所问!”
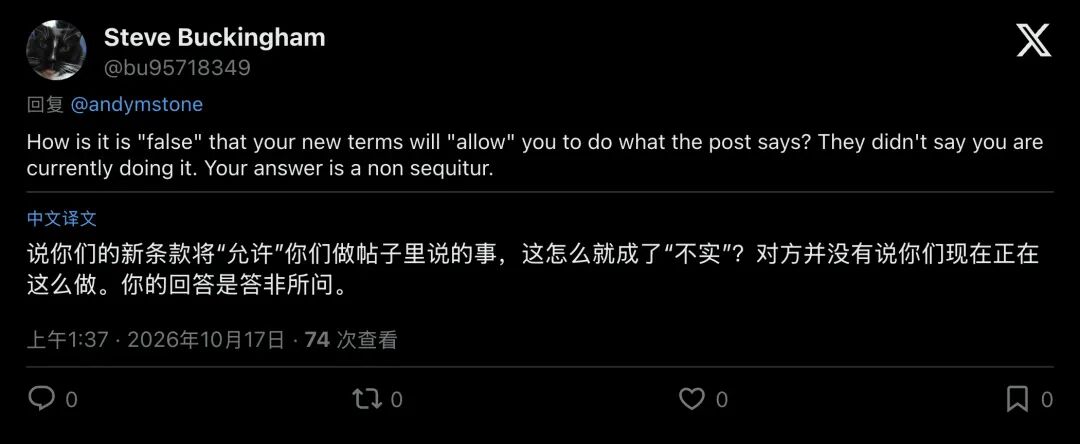
▲ 网友一针见血地指出Meta高管在玩文字游戏,偷换了“条款允许”与“正在执行”的概念
更关键的博弈,在于斯通搬出的挡箭牌,robots.txt。
很多非技术背景的读者可能会问:robots.txt到底是什么?简单来说,它是网站放在自家大门口的一块“请勿打扰”木牌,写着允许哪些爬虫进、禁止哪些爬虫进。网站仍需依赖爬虫运营者遵守这些访问规则,文件本身无法强行拦住爬虫。
我们翻开Meta自己的开发者文档就会发现,Meta旗下养着一整支分工明确的“爬虫特种部队”:有专门抓商品广告的meta-externalads,也有专门为“训练基础AI模型”而全网扫荡的meta-externalagent。而且,Meta在文档里白纸黑字地写着:部分按用户请求触发的拉取类爬虫(如Meta-ExternalFetcher),在特定场景下可能会直接绕过robots.txt的限制!
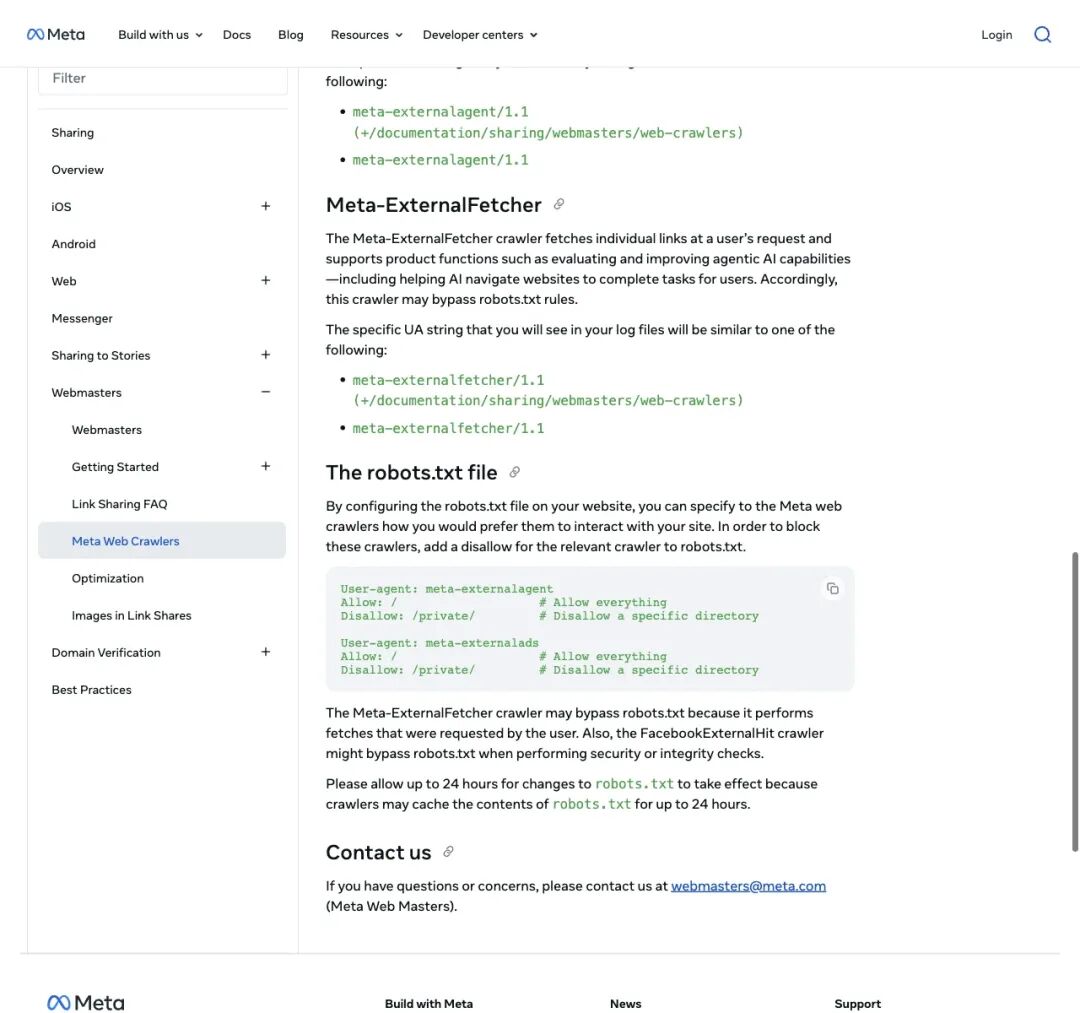
▲ Meta文档说明,按用户请求抓取链接的Meta-ExternalFetcher可能绕过robots.txt;这与训练爬虫的用途须分开看
这就是法律专家们最警惕的地方:合同里的授权范围,会影响网站对内容使用的控制。
当你在网站门口挂了一块robots.txt的“免进木牌”,却又在Meta后台接受了宽泛的抓取授权,未来一旦对簿公堂,法院会如何解释两者的关系,仍有争议。如果Meta只想抓点电商商品价格,为什么要在合同里索取如此宽泛的权限?
03连夜删掉“训练”二字!起底巨头认怂背后的法理死穴
就在安迪·斯通嘴硬说完“报道不实”几个小时后,戏剧性的一幕发生了:Meta自己动手改了条款。
科技媒体PCMag在跟进报道中增加更新:Meta似乎修改了公开可见的商业条款预览页。原先的“train”(训练)一词已被删去,网页抓取的用途也被收窄,明确写向“广告和商业产品”(advertising and business products)。Meta发言人称,“听到了大家的反馈”,因此在文本中做了澄清。
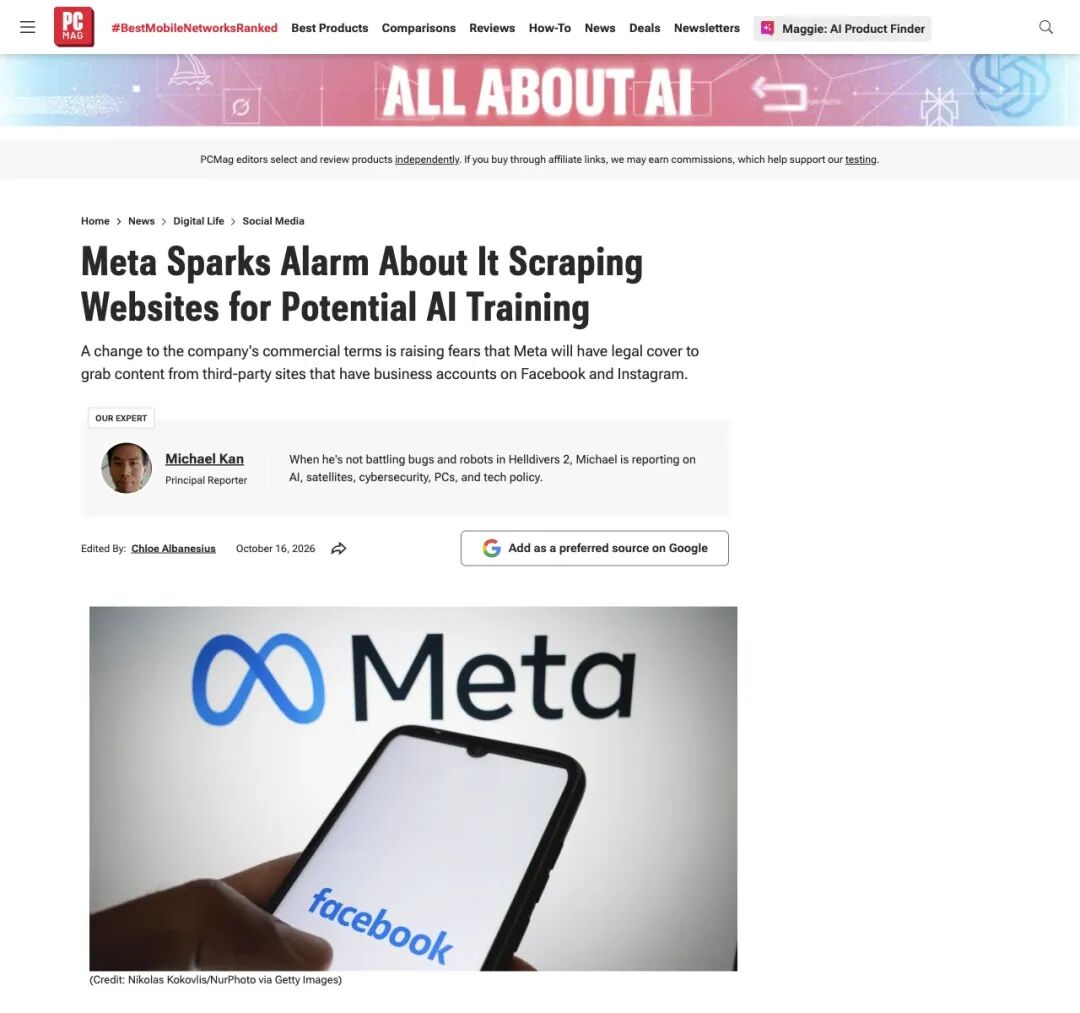
▲ PCMag报道商业条款引发的AI训练担忧;截图展示标题与配图,后续更新见报道正文
一家万亿美元市值的科技巨头,为什么前脚刚骂媒体“造谣”,后脚就心虚地连夜删词?
因为法学界的大拿们已经把手术刀架在了这套机制的死穴上。这场风波的本质,是AI巨头在版权战场受挫后,试图用“合同法戏法”完成一次惊险的越狱。
过去几年,AI公司抓取全网数据训练模型,靠的都是版权法里的“合理使用”(Fair Use)当护身符。但随着《纽约时报》起诉OpenAI等世纪官司越打越深,“合理使用”这面盾牌正在出现裂痕。为了买下合法语料,Meta此前不得不像OpenAI一样,乖乖掏出真金白银,与CNN、福克斯新闻、《今日美国》等大媒体签署动辄数百万甚至数千万美元的AI内容授权协议。
每一家都去谈,太贵了于是,有人想出了一条“捷径”:既然“合理使用”抗辩不保险,为什么不直接改写商业服务条款,把“未经许可的盗采”变成“你签字画押的默示授权”?
算盘打得很精,但在法律天平上,这套设计踩中了三颗致命地雷:
- “霸王条款”的执行力争议
:这种平台单方拟定、用户只能接受或离开的格式条款,通常被称作“附合合同”。知识产权诉讼律师马特·托皮克(Matt Topic)指出,相关材料在许可市场可能价值数百万美元,把这种授权埋进服务条款令人惊讶。他同时提醒,法院是否执行尚不清楚,出版方应当按条款可能被执行来应对。 - 实习生点鼠标,能卖掉整个报社吗?
格里梅尔曼教授点出了一个近乎荒诞的法律漏洞:很多大媒体或大企业的Meta主页,平时是由初级社媒小编或实习生在打理的。一个小编为了发条日常动态,在后台点了一下“同意更新”,他在法律上有什么代理权限,替整家集团把独立网站的版权资产拱手让人?更何况,新闻网站上还有大量路透社、美联社的特许供稿和自由摄影师作品,媒体自己都没权利转授权给Meta,这条“全站抓取授权链”在法律事实上根本无法闭环。 - 反垄断法下的“搭售”疑问
:威斯康星大学法学教授本杰明·索贝尔(Benjamin Sobel)将这套安排类比为反垄断法中的“搭售”(Tying):企业要使用受商业条款约束的Meta产品,就得一并接受抓取许可。是否构成违法,仍需结合具体事实作法律判断。
这些法律疑问,让条款的执行前景充满变数,也给出版方留下了争辩空间。
04倒计时仍在继续:下一次弹窗,请看清你的数字地契
删掉了“训练”,危机就彻底解除了吗?并没有
打开Meta商业条款的预览页面,那道写着“2026年10月30日正式生效”的顶部横幅依然挂在那里。虽然用途被暂时收窄到了“广告与商业产品”,但允许派驻网络爬虫、允许创建“测试凭证”的条款原封不动地留在文本里;“不同意就彻底停止商业使用”的铁腕规则,也一个字都没改。
管道已经铺好,阀门依然握在平台手里。今天它可以因为舆论压力删掉“训练”,明天当风头过去,或者换一种更隐晦的“优化商业系统”措辞,数据依然会源源不断地流向巨头的服务器。
故事又回到了10月初当独立站长斯蒂芬·比尔看到条款更新弹窗时,枯燥的法务字眼牵动了他对网站命运的担忧。
在算力与数据饥渴症的驱使下,围墙花园的领主们已经不再满足于收割你在花园里种下的庄稼。下一次,当你的工作后台再次弹出那行熟悉的“服务条款已更新,继续使用即代表同意”时,不妨多停顿三秒钟。
因为你随手点下的那个“确认”,可能正把自家数字领地的使用权免费交给平台。