ARTICLE · 1203299
DIA-NN 引擎源码考古 · 1.7.12 · 第一回 · 先把引擎的「地层」看个全貌 ~
上一篇 《DIA-NN 最新源码里能看到什么、能学到什么:一份公开仓库的观察报告》 收尾留过一句话:“下期顺着 1.7.12 版的引擎继续下探,看看还能看到哪些软件内部的细节”。这一回来还这个愿:挖开 1.7.12 发行包里那份 diann.cpp,把实际分析过程中,数据走过的那条路,一段一段展示给观众老爷们看。
可真把这份文件挖开,才发现细节远比想象的多 —— 装载、打分、校准、定量,每个环节里都有讲究,一篇塞不下。所以小编索性多开几篇,把这次引擎考古的结果一篇一篇介绍给观众老爷。眼下这篇先做整体的总览:这台引擎由哪些零件组成、一份数据进来要过哪几关,先把全景立起来。这条线后面往哪深挖,文里也先给个影子。
上一篇里 “最新版源码里看不到的” 那一串问题 —— 打分器怎么训练、decoy 怎么生成、蛋白推断怎么实现 —— 这次正好一并学习。那篇末尾就交代过:这些里头有一部分,在早期完整开源的旧引擎里其实读得到。1.7.12 的 diann.cpp 整份躺在发行包里,当年算法怎么写的,都在这份文件里。当然,话得说明白:咱们挖的是历史上的引擎,最新版里是不是还这么干,闭着源谁也说不死;能坐实的,是当年这些题是怎么解的、每步为什么这么设计。
发掘对象:一台带着历史痕迹的单文件引擎
先看发掘对象本身。1.7.12 的发行包是个标准的 Visual Studio 工程全家桶,顶层一眼能数完:
DiaNN-1.7.12/├── src/ # 核心引擎:diann.cpp(456 KB、11,260 行)+ cpu_info.h(CPU 探测)├── diann/ # 引擎的 VC++ 工程:diann.vcxproj / .filters├── cranium/ # 自制神经网络库:7 个 .h 纯头文件写完(matrix / network / optimizer…)├── eigen/ # 第三方线性代数库 Eigen,完整源码内嵌├── mstoolkit/ # 质谱文件读写工具包,三大依赖打包在肚子里│ ├── include/ # sqlite3.h、zlib.h、expat.h、mzParser.h …│ └── src/ # sqlite-3.7.7.1、zlib-1.2.8、expat-2.2.0、mzParser、MSToolkit├── GUI/ # C# WinForms 图形界面:独立的 GUI.sln + Form1.cs 主窗体├── WiffReader/ # Sciex .wiff 格式读取桥接层:WiffReader.cpp├── Setup/ # 安装包工程:Setup.vdproj├── diann.sln # 顶层 Visual Studio 解决方案├── README.md # 项目说明:官方自我介绍 + 命令行用法与教程├── LICENSE.txt # 授权:CC BY 4.0├── DIA-NN GUI manual.pdf # 官方 GUI 手册(350 KB)├── linux-build-gcc-7 # Linux 构建脚本(gcc-7)├── linux-build-old-gcc # Linux 构建脚本(旧版 gcc)└── _config.yml / .gitignore # GitHub Pages 配置 / Git 忽略规则真正的老底在 src/diann.cpp:456 KB、11,260 行(ReadAllLines 口径),从原始数据装载、FASTA 酶切、修饰展开、理论谱生成,到搜库、打分、校准、q 值、蛋白推断、MaxLFQ,再到报告输出和 main 总控,全流程写在同一份文件里。所谓 “单文件引擎”,字面意思就是字面意思。
小编碎碎念:这么干在软件开发界算稀有动物。主流工程讲究模块拆分、各管一摊,一份文件写到上千行就该琢磨着拆了;把上万行全塞进一份文件的,数得出来的大概两类。一类是刻意的 “单文件发行” 流派:C 语言圈知名的 stb 系列单头文件库、SQLite 分发的那份单文件版都这么干,图的是往任何项目里一塞就能编译。另一类是科学家写代码的传统:从读数据到出结果全在一份 main.cpp 里,模块化是什么,能吃吗。diann.cpp 两边都沾点边 —— 形态上是科学家的 “一锅炖”,成色上倒真把一整套引擎炖得有条有理。
README 里也留着满满的历史痕迹。开篇自称 “a fast and easy to use tool for processing data-independent acquisition (DIA) proteomics data”,主打深度神经网络和 library-free 搜索;文里还写着 “推荐使用最新版 1.7.11”(原文:it's recommended to use the latest version - DIA-NN 1.7.11),可包里装的已经是 1.7.12。
这痕迹的来历,跟 1.7.11 的包一对照就清楚了:引擎源码从 10,245 行涨到 11,260 行,逐行对比一千多行不一样;README 两个包里却一字不差。所以那句话不是谁在推荐旧版,而是 1.7.11 当 “最新版” 那阵子的文档,原样跟着 1.7.12 一起打了包。代码在推进,说明文档没跟上,这种痕迹在老版本里一翻一堆。
地层剖面:11,260 行的内部构造
diann.cpp 的内部不是一锅粥,自上而下像地层一样叠着,每层管一摊事。完整剖面有二十三层,这里挑主干层给观众老爷过一遍:
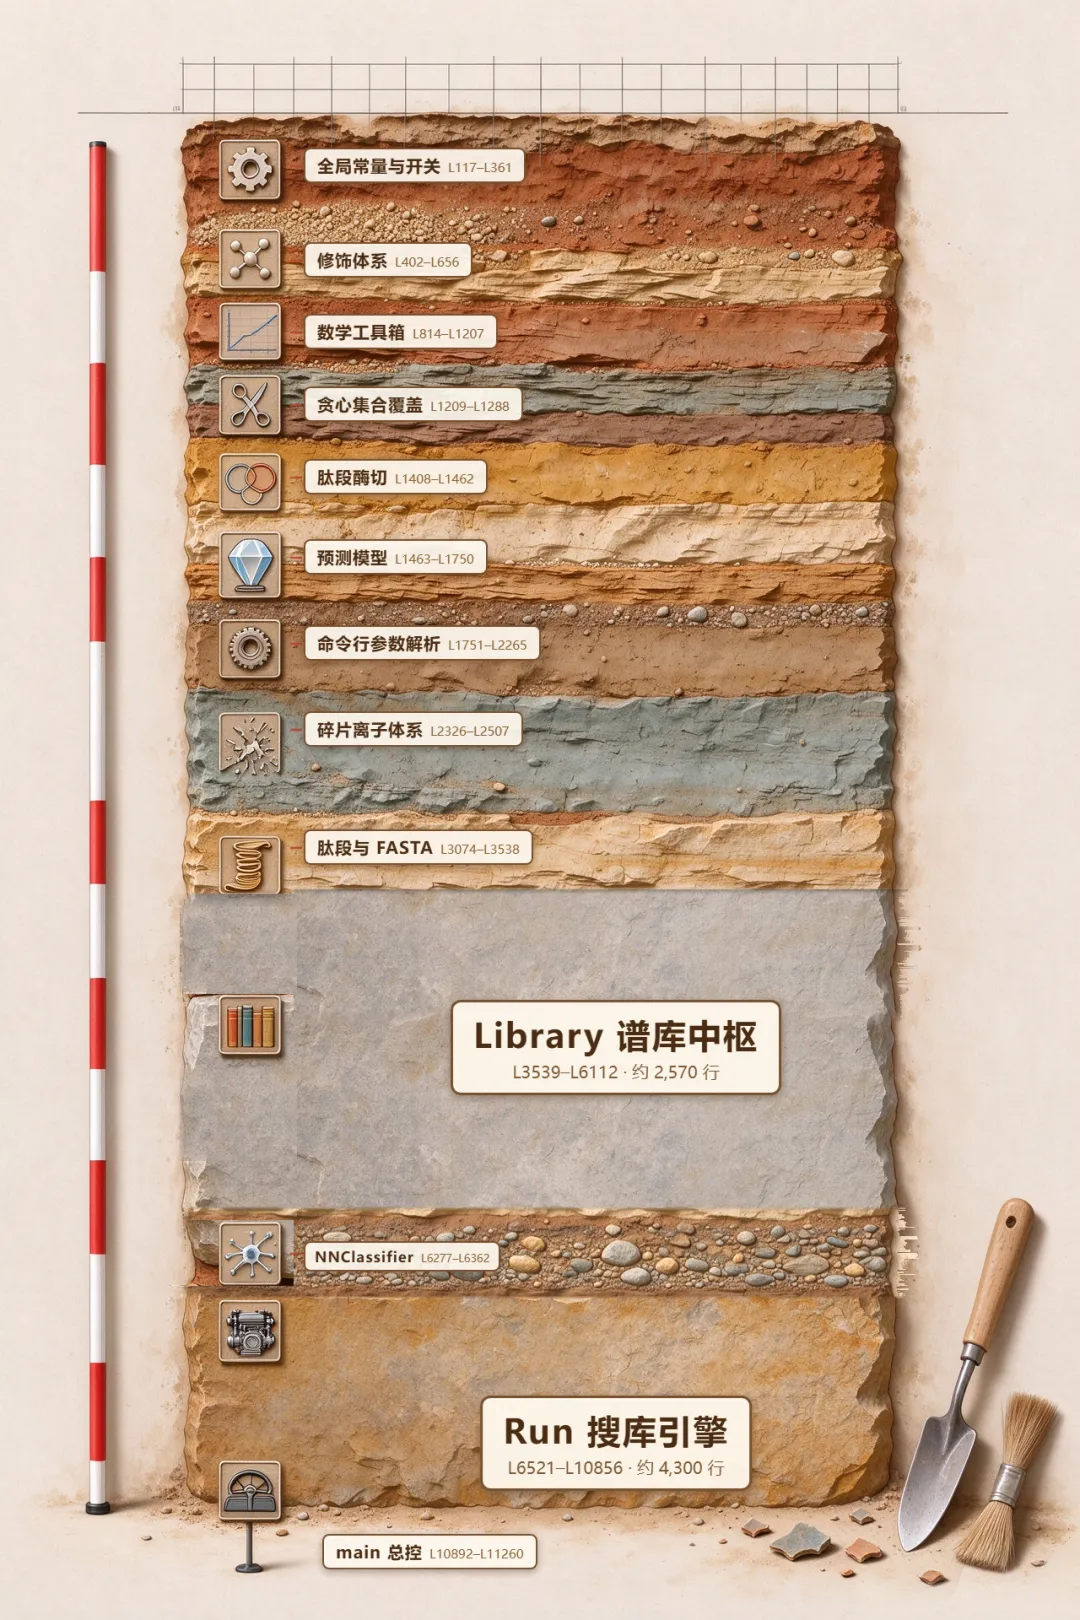
体量一眼可见:Library 和 Run 两个巨类加起来近七千行,是全文件工作量的重心,常规重活最扎堆的地方。谱库中枢管 “该查什么、查完怎么归拢”,搜库引擎管 “怎么在原始数据里找证据”,正好是后面 “怎么找、怎么判” 两块的主料。
小编碎碎念:看行数容易顺出一个错觉 —— 越长越金贵。可小编这些年看代码的体感是:行数量得出工作量,量不出创新浓度。真正亮眼的点子,可能就藏在几十行里;几千行的巨层,多是读写、簿记、校准这类体力活,是开发时真金白银砸进去的苦功夫。工作量最大的地方,和最亮眼的地方,从来不必然重合。
这层剖面里还埋着一个招牌与实物的反差。README 主打的 “深度神经网络”,在源码里其实只占一角。碎片强度和保留时间的基础预测是线性加权模型 —— 电荷、氨基酸组成、位置这些特征按规则构造、直接加权,权重从谱库最小二乘拟合出来,可解释、跑得快。
神经网络的正主是 NNClassifier(L6277–L6362):挂在搜库引擎的迭代闭环里,给 “这证据像真还是像假” 重打分 —— 默认 12 个网络做 Bagging,每个是 5 个隐藏层的微型塔形结构(25-20-15-10-5),输出取平均。
就这么大点家当:类本体 86 行,加上训练、打分辅助代码和 Run 里的装配调用,一共约 240 行,只占全文 11,260 行的 2%;真正的网络运算在随包的 cranium 微型库(7 个头文件、约 1,400 行)。
至于深度学习谱库预测,源码里只有一张 “门票” —— 十几行接口声明(两个函数加一个类,包在编译开关里),实现没随包提供,README 明言只有官方构建才带、且仅限 Windows。基础活交给线性模型,要紧关头才上网络,这个取舍本身就值得琢磨。
工程风貌:这台引擎的纪律
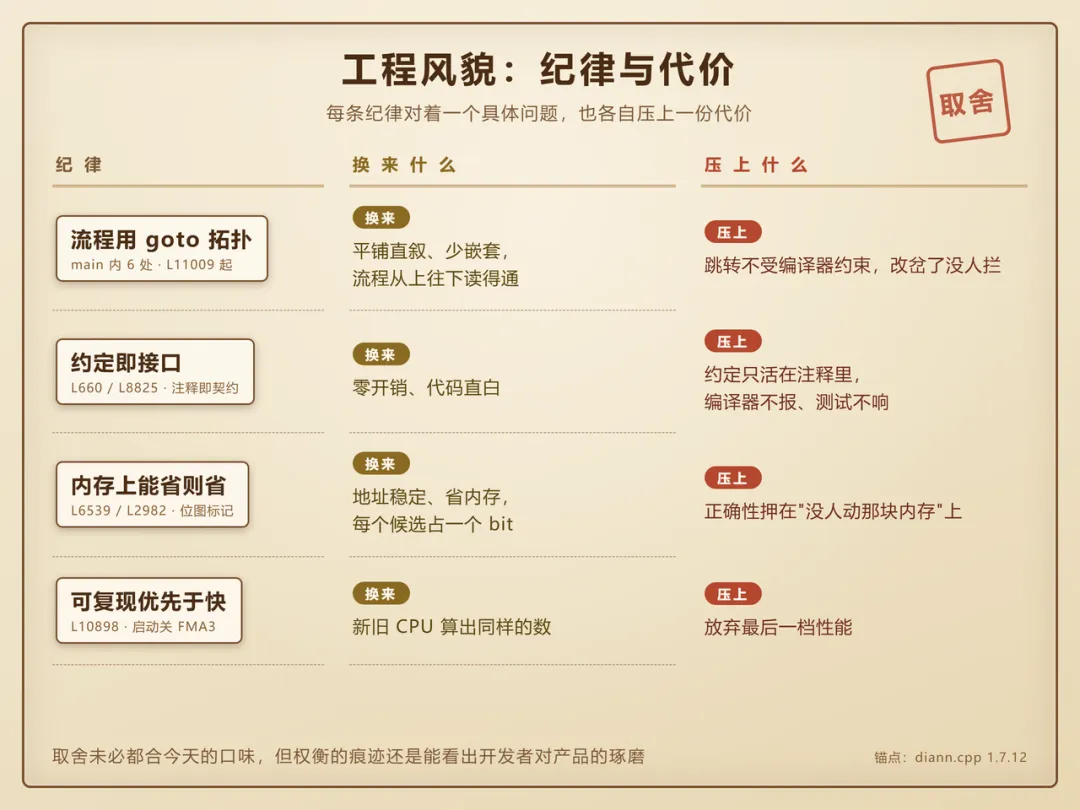
11,260 行塞进一份文件,按今天的主流工程审美不算常规写法。可真顺着代码读下来,里面有一套自洽的纪律,大多冲着科研软件的要害去:算得准、跑得快、结果可复现。不过纪律不白来,每条下面都压着一份代价;值不值,得看取舍站不站得住。
补个前提:这类取舍只有 “工具链攥在自己手里” 才做得起。DIA-NN 随包带全部 C++ 源码,程序主体就是拿这份源码编译出来的 —— “编译” 就是把源码翻成电脑能直接跑的程序的那道工序 —— 用什么编译选项、开不开某条捷径、内存怎么摆,都由开发者定。这跟今天常用的数据分析不是一个玩法:R、Python 脚本底下的数值库是别人编译好的成品,那道工序早在人家打包时就做完了,脚本插不上手。所以下面几条该读成 “自己掌握工具链的程序做的取舍”,不是 “写脚本照做” 的清单;对常用 R、Python 的读者,它们更像参照 —— 同样的问题在脚本世界也存在,只是那边管不到这么底层,通常靠锁环境、容差比较兜底。
流程用 goto 拓扑,不玩嵌套。 goto 是个老资格的跳转指令:程序跑到这一行,直接 “传送” 到别处的标记接着干。main 里的流程分支就是一串 goto 跳转。这写法放到今天算争议选手 —— 正经的 C++ 编码规范让它靠边站(C++ 核心指南 ES.76 明说 “避免 goto”,https://isocpp.github.io/CppCoreGuidelines/CppCoreGuidelines#es76-avoid-goto ),可 Linux 内核那种巨型代码库反而推荐拿它收尾(内核代码风格指南第 7 节专讲用 goto 做 “集中的函数退出”,https://docs.kernel.org/process/coding-style.html )。在单文件巨构里,它换来 “平铺直叙、少嵌套”:流程从上往下读得通,不用在层层大括号里找北。代价也明摆着:跳到哪、跳得对不对,编译器都不管,跳转不受编译器约束,改岔了没人拦。
约定即接口。 原始数据扩展名清单的注释里明确写着必须按字母序排,因为查找走的是二分 —— 二分查找好比查字典:先翻中间一页,看要找的词在前半还是后半,再对折了接着翻,几下就到;前提是字典必须按序排好,乱了序这法子就失灵。装载函数的注释里也写明前提:谱须按采集时间有序,好比排队必须按先来后到,代码直接信这个约定干活。文档没写到的地方,注释就是契约。好处是零开销、代码直白;风险是约定只活在注释里 —— 谁打乱了字母序或时序,编译器不报、测试不响,只能靠后来的人肉眼守约。
内存上能省则省。 一趟分析要把大量谱图的峰数据放在内存里随取随用,内存自然是金贵资源,于是能省则省:谱图的峰数据用链表套数组装着,每块数据落地后地址就不再变 —— 这叫地址稳定(这是 C++ 标准给链表的明文保证,https://eel.is/c++draft/list.modifiers ),好比给每块数据发了固定门牌号;谱头只登记门牌号(指针),用的时候照号取数,全程不搬数据。“这个前体搜过没有” 这类标记用位图管理:一排小格子,每个候选占一个 bit,打个勾就记住。省内存的账算得精,代价是把正确性押在 “没人动那块内存” 上 —— 数据一旦挪窝,门牌号就成了空号,也就是指针悬空,这类错编译器同样拦不住。
可复现优先于快。 启动时主动关掉 FMA3 指令集。FMA 是新 CPU 才有的一条捷径指令:把 “乘完再加” 两步并作一步算,中间少一次四舍五入,快是快一点;可新旧 CPU 一个走捷径一个不走,同一道算式的结果就会在小数点后很远的地方出现细微差异(这个舍入差异有带代码实证的专文详解,https://www.mjr19.org.uk/IT/reproducibility.html )。注释写得明白:关掉它,是为了让新旧 CPU 算出同样的数。为什么把这件事看得这么重?科研工具出的是定量结果,要经得起复核:同一批数据,今天在这台机器跑、过阵子换台电脑跑,出的数应当对得上;差着小数点后十几位的一点点,碰上卡在阈值边界的样本就可能翻出不同结论。而要管住每一步算式,就得从编译那一刻下手 —— 宁可放弃最后一档性能,也要让同一份数据在哪台机器上都算出同样的数。
这些纪律单拎出来大多算不上新发明,凑在一台 2020 年前后的科研工具里,更像一张取舍清单:每条纪律对着一个具体问题,也各自压上一份代价。取舍未必都合今天的口味,但权衡的痕迹还是能看出开发者对产品的琢磨。
九步工序:你的数据从进来到出去
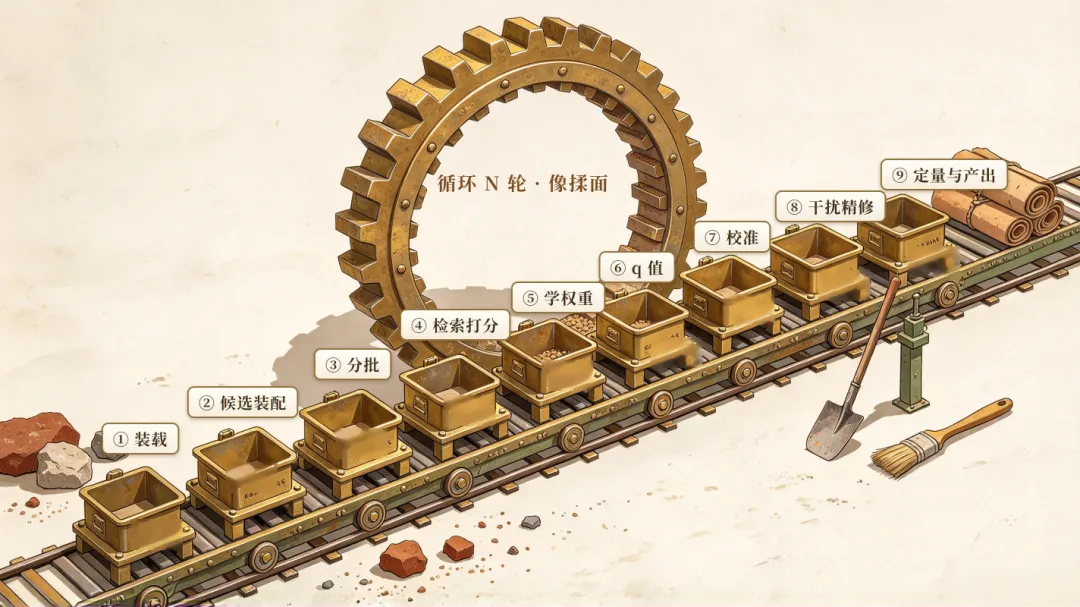
看完部件和纪律,看工序。一份原始数据进来以后,引擎走的是这么一条线:
report.tsv 和各种矩阵 |
DIA-NN 的论文(DIA-NN: neural networks and interference correction enable deep proteome coverage in high throughput)给这台机器的卖点写在标题里:神经网络和干扰校正,落点是深度覆盖、高通量。神经网络学着把真信号和噪声分开;干扰校正收拾 DIA 数据里共流出信号互相搅局的老大难 —— 两样冲的是同一个目标:往深里覆盖,还不耽误速度。
工程上另有一层门道,文献不大会写,源码里却明摆着:中间那四步 —— 检索打分、学权重、q 值、校准 —— 不是过一遍就完,而是循环转 N 轮,像揉面:每一轮拿上一轮的确定答案,把质量误差、保留时间这些参数调准,再搜下一轮;参数调得越准,下一轮搜得越干净。这圈循环本身不算独家 —— 搜库软件校准参数再重搜,本是常规动作;但卖点恰恰要靠它打底:参数校得越准,网络打分和干扰校正才越靠得住。DIA-NN 把这圈常规动作做成了无人值守、一口气跑完,全自动、省心好用是它的落点;“高通量” 是另一笔账,落脚在 “快” 上:软件自己跑得快,还扛得住短梯度、大批量下的深度 —— 前者是效率功夫,后者又回到卖点头上。
写在最后,也写在开始
一段话收个底:1.7.12 的 DIA-NN 是一台单文件引擎,内部地层分明,九步工序,包含揉面式的迭代;Paper 的招牌上写着深度学习,规则式线性模型承载了大多数的基础活,神经网络只用在刀刃上;经典算法用得也扎实,放到今天依然耐看。
这一回带着观众老爷们只看全貌。往后的篇目,小编准备顺着数据这条线分三段来挖:怎么找(前三步),怎么判(中间四步加干扰精修),怎么出定量结果(最后一步)。每个环节里都有门道,这里先立个框架。
如果这篇对各位观众老爷有用,请伸出您尊贵的小手点个赞,小编也有更多的动力接着往下写 ~
相关文章
DIA-NN 往期文章,按发表顺序:
• 《DIA-NN 输出文件 「地图册」:从 log 到 report,告别信息 「迷茫」,关键内容一查就有 ~》 —— 输出文件都在哪、都是什么 • 《GUI 能摸的 DIA-NN 参数有限?让咱们来一起看看 Windows 命令行下有没有 「隐藏宝箱」线索 ~》 —— 命令行参数盘点 • 《想让 DIA-NN 融入蛋白质组数据分析 Pipeline?试试给它搭个 Linux 「移动小屋」?》 —— Linux 部署与集成 • 《DIA-NN 最新源码里能看到什么、能学到什么:一份公开仓库的观察报告》 —— 新仓库观察,也是本篇的前情
另有一篇 target-decoy 与 FDR 的科普:《质谱鉴定的 「打假办」,FDR:我来算算这伙里面骗子占多少!》,感兴趣可以翻翻。