ARTICLE · 1207805
本地AI语音克隆工具怎么选?
一、模型推荐(按显存)
显存 | 模型 | 描述 |
|---|---|---|
1–2GB | LuxTTS | 显存占用极小,效果不错 |
2–8GB | Qwen3-TTS | 稳,4GB 以下用 0.6B,6–8GB 用 1.7B |
12GB 以上 | IndexTTS2、Breeze TTS 2 | 整体效果好 |
它是基于 ZipVoice 架构进行蒸馏与推理优化,第一次用确实很惊艳,1G显存能达到这种效果,我觉得很强了
这个档位选择就多了,但考虑到速度和输出质量,我推荐:OmniVoice和Qwen3-TTS
OmniVoice效果是不错,个人感觉是不稳定,需要多抽卡
Qwen3-TTS就好多了,使用社区加速版,4G以下显存用0.6B版,6-8G显存使用1.7B版
VoxCPM2也不错,甚至我认为是克隆相似度最高的模型,只是做长篇阅读每一段容易不统一
大显存就没什么顾虑了,我也没有充分测试的条件,根据其他博主的测评和推荐
IndexTTS-2效果是好过IndexTTS-2.5的
Breeze TTS 2整体效果最好
Fish Audio:如果显存足够大,24GB以上可以尝试S2 Pro,48GB可以尝试Drama 3
二、主流模型对照
按显存从小到大排,★ 是我推荐的:
模型 | 显存占用 |
|---|---|
Kokoro-82M | GPU < 1GB;纯 CPU 约 1.9GB |
LuxTTS ★ | 约 1GB |
ZipVoice | 约 1–2GB |
Qwen3-TTS 0.6B ★ | 约 2GB |
OmniVoice ★ | 约 2–3GB(量化后 0.66–1.6GB) |
VoxCPM 1.5 | 约 5–6GB(量化约 3GB) |
CosyVoice3 | 约 5–8GB |
Qwen3-TTS 1.7B ★ | 约 6GB |
IndexTTS-2.5★ | 约 6–12GB(按 10GB+ 准备更稳) |
VoxCPM2 ★ | 约 8GB(量化 6–8GB) |
Breeze TTS 2 ★ | 约 12–24GB |
三、安装
安装有两种方式
第一种,下载整合包:去 B 站这类平台找博主做的整合包,一般解压即用,不用碰环境。记得装完先让 AI 扫一遍代码,看看有没有安全问题,避开带木马的钓鱼整合包。
第二种,让 Agent 搭建:安全性更可控,直接跟workbuddy对话即可
帮我在某个文件夹里部署 Qwen3-TTS 官方示例,镜像源优先使用国内源。
缺点就是,Python 依赖里有部分包仍要走国际源,下载会慢一些。
四、二次开发
安装完毕只是官方示例,如果要和自己的工作流程绑定,就需要二次开发了。
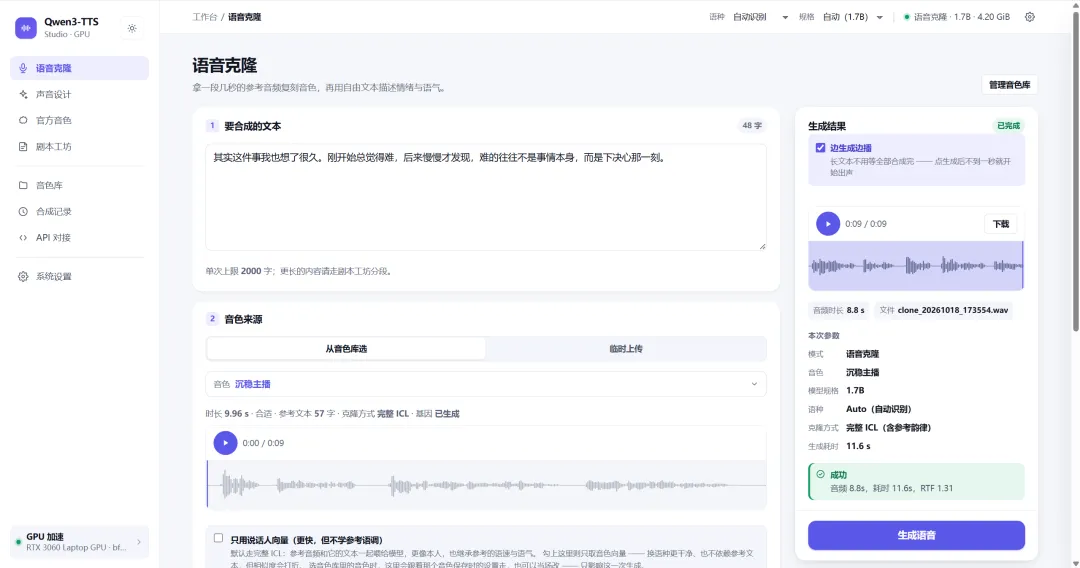
如今,直接告诉AI需求即可,比如我帮朋友搭建的这个,Qwen3TTS原生功能为:语音克隆、音色设计、语音合成。
我参考了下其他人的整合包,增加了剧本工坊、音色库、API对接。
API对接页面,可以发给AI阅读,让它调用模型能力,执行语音合成任务,比如把稿子扔给它,让它帮你完成口播稿的录制。
五、最后说一句
今天看到一条新闻,一位明星在微博维权:有人用他的形象和声音做带货,还对着观众承诺产品效果。
AI 让很多事情变简单了,但也让违法的门槛变低了。如今 AI 视频已经以假乱真,声音也一样。
技术本身没有立场,用在正确的地方很重要。