ARTICLE · 1210187
DeepSeek 悄悄换了新模型:App 里回答更短更快,这几种用法更好使了
今天如果你打开手机里的 DeepSeek App,或者顺手在电脑网页端问了两个问题,可能会隐约觉得有点不对劲:回答吐字的速度好像变敏捷了,而且以前动不动就给你列「一、二、三、四、五」外加一段毫无营养客套总结的长篇大论,今天突然收敛了许多。
这不是你的错觉,也不是网络突然变好了。
2026 年 10 月 17 日,DeepSeek 悄悄更新了底座模型,版本号定为 DeepSeek-V4.1-Flash-1017。没有铺天盖地开发布会,网页端、手机 App 和 API 接口已经在同一天完成了静默同步。虽然开源社区里权重已经放出来了,但对绝大多数不碰代码、只把 DeepSeek 当日常工具的普通读者来说,真正值得关心的只有一件事:这东西换了之后,在日常使用中到底会变好用,还是变得更容易偷懒了?
需要先框清一个前提:目前关于这个模型的所有能力描述,基本都来自官方更新文档与基准参数,第三方独立的深度盲测和体验报告还没有大范围出来。咱们不看吹得天花乱坠的宣传,单聊聊它反映到 App 界面上,会对你的日常使用带来哪些肉眼可见的变化。
到底更新了什么?一句话说清
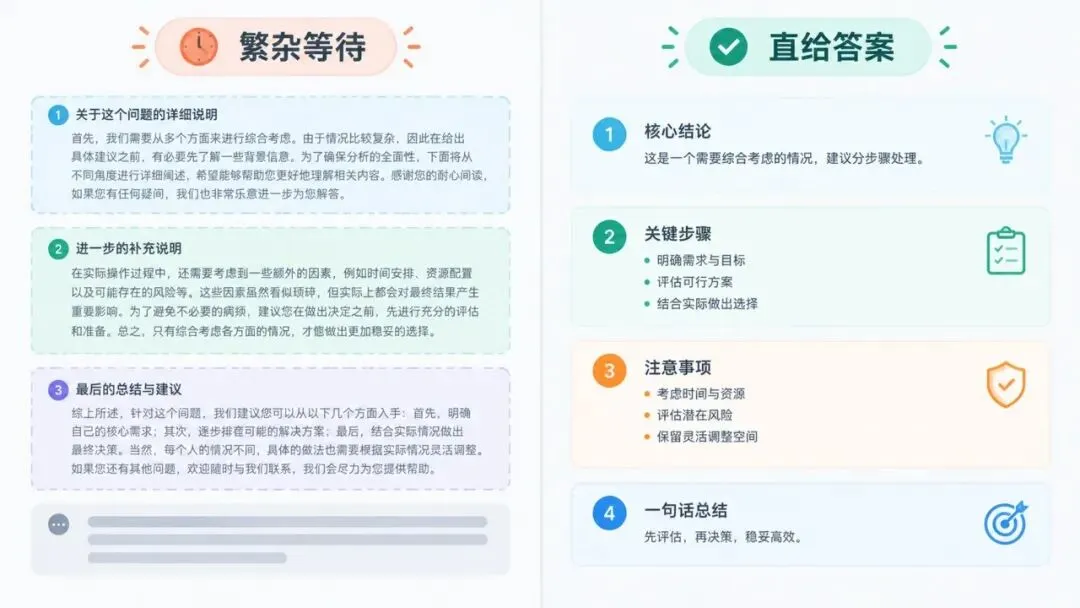
按照官方说明,这次的核心逻辑非常明确:在保持甚至提升原有模型性能的前提下,主动缩短输出长度,大幅减少整个任务的运行耗时。
过去一年里,不少大模型都患上了严重的「废话通病」——你问一个简单问题,它恨不得把整本百科全书的起承转合都搬出来,开头一句「很高兴为您解答」,中间塞满正确的废话,结尾再来一句「希望以上内容对您有所帮助」。不仅读起来累,手机端生成时还要干等几十秒。
这次静默上线的 V4.1-Flash-1017,官方主打的刀法就是「砍水字数、提执行速度」。它并不是单纯把模型切成了轻量版,而是在回答机制上做出了调整,偏向直奔主题。
对你常用的几种姿势,影响大不大?
把这个新底座放到真实的手机 App 和网页端使用场景里,不同习惯的人感受会完全不同。
1. 日常快速问答与查常识:会更好使
如果你平时用 DeepSeek 就是查个菜谱、问个报错含义、确认某个名词概念,这次的体验提升会最直观。以往这类需求最怕 AI「过度发散」,你只想知道生抽和老抽的区别,它从大豆发酵历史讲到食品工业规范。新模型在官方设定中收紧了输出长度,回答更偏向直接给答案、分点简明扼要。从提问到全文字符吐完,手机屏幕上的等待感明显变短。
2. 资料总结与搜网提炼:会更好使(但别盲信)
伴随这次底座升级,官方同日开放了底层的搜索提取接口(Search & Fetch),虽然这主要是面向系统底座的技术更新,但也意味着 App 端联网搜资料时的抓取与归纳逻辑步调一致了。现在让它联网查最新的资讯或整理一段长网页,它更倾向于把干货抽成干脆的要点,而不是大段大段复述网页原文。不过这类提炼也有代价:回答变短了,有时候可能会漏掉原本藏在长文里的细碎背景,重要信息依然需要点开参考源二次确认。
3. 长文润色与创意写作:感觉差不多,甚至要改提问习惯
如果你习惯把 DeepSeek 当成「扩写工具」,让它帮你把 100 字的想法写成 1500 字的发言稿或故事,你可能会觉得它有点「收敛过度」。因为底座偏向减少冗余输出,如果你的提示词只写「帮我润色一下这段话」,它很可能只会改掉错别字和病句,顺带把结构收紧,而不会主动替你添加大量修饰描写。要想让它像以前那样写得洋洋洒洒,你必须在提示词里明确补充「请详细展开论述、增加具体事例与细节描写」。
4. 辅助写脚本、改代码与自动化小项目:核心受益区
在官方测试指标中,提升幅度最大的其实是编程与智能体(Agent)链路。反映到普通人能接触到的工具上,情况会变得很有意思:
• 直接在 App 里问代码:以前写一段稍复杂的脚本,模型常常在中间穿插大量原理解释,代码还没写完就撞上长度限制或者中途卡顿;新模型给代码更干脆,直给实现方案,查错时一针见血。 • 桌面端与辅助工具用户:这次更新官方明确提到了对各类代码与智能体环境的适配优化。如果你在用 DeepSeek Harness(官方建议版本不低于 0.2.1-rc.1)、腾讯 CodeBuddy,或者在日常办公中用过 WorkBuddy 这类自动化工具,会发现工具调模型处理长链路流程时的阻塞感降低了,多步调用的总等待时间缩短明显。
怎么自己感受差异?3 个可复现的小实验
官方数据说得再漂亮,不如在自己的手机上试几把。你可以打开 DeepSeek,用下面这几个简单的提问方式,自己摸一摸它的脾气变化:
实验一:测废话率
输入提示词:「请用一句话告诉我,熬夜为什么会伤肝?不要任何开场白和结束语。」 观察点:看它是否真的能克制住打招呼的冲动,能不能在两行文字内干净利落地把核心机制讲完。
实验二:测代码提炼与执行利落度
输入提示词:「写一段提取文本中所有手机号的 Python 正则表达式,附带 3 个测试用例即可。」 观察点:看它是在前面长篇大论介绍什么是正则,还是直接给出代码块,并在末尾只给出一两句必要的说明。代码输出越利索,说明模型调优的倾斜越明显。
实验三:测长文浓缩
把一篇动辄两三千字的行业新闻或公众号长文直接丢给它,提示词填:「提取这篇文章的核心事实与 3 个主要观点,用无序列表列出。」 观察点:对比以前的模型,新版在归纳这类长文本时,是否去掉了空泛的宏观评价,只保留硬核事件与数据点。
别踩坑:用新版别交「智商税」
每次大模型只要有一点风吹草动,网上就会冒出一堆似是而非的解读。借着这次更新,有几个务实的提醒值得记一下:
1. 别把官方跑分直接等同于个人体验:官方给出的基准测试提升,通常是在极其标准的提示词和特定评测集下跑出来的。实际在 App 里,你的提问方式千奇百怪,别指望换了个版本它就能从「智能工具」瞬间变成「全知神仙」。 2. 千万别去花冤枉钱买所谓的「新版升级激活码」:这次更新是全端覆盖的,无论网页端还是 App 端,你只要正常使用,后台就已经切到了新模型,没有任何付费解锁门槛。任何宣称「花钱代开新模型内测」的都是灰产套路。 3. 调用 API 的用户不需要改配置:如果你平时自己搭小工具、调 API,调用的模型名称依然沿用 deepseek-flash,计费单价和调用方式没有任何改动,后台已经自动平滑过渡,不需要去翻文档折腾配置换参数。
模型更新换代越来越像手机操作系统的深夜推送,悄无声息就完成了替换。工具变得更快、废话变少,对每天用它解决具体问题的人来说永远是件好事。
今天打开 App 时,不妨试着用更简洁直接的话去交代任务——既然它学会了少说空话,那咱们也省点打字功夫,让它把速度跑出来。