ARTICLE · 1221379
从瀑布到敏捷,再到AI原生:软件工程正在进入第三个时代
从瀑布到敏捷,再到AI原生:软件工程正在进入第三个时代我做了20多年的软件和互联网应用,经历过瀑布开发,也经历过敏捷开发。二十多年下来,不管方法论怎么变,有一个底层前提其实一直没变:软件最终还是要靠人写出来。 瀑布解决大型项目怎样计划,敏捷解决需求变化以后怎样降低风险。需求排期、Sprint、Story Point,本质上都围绕人的执行能力来组织。 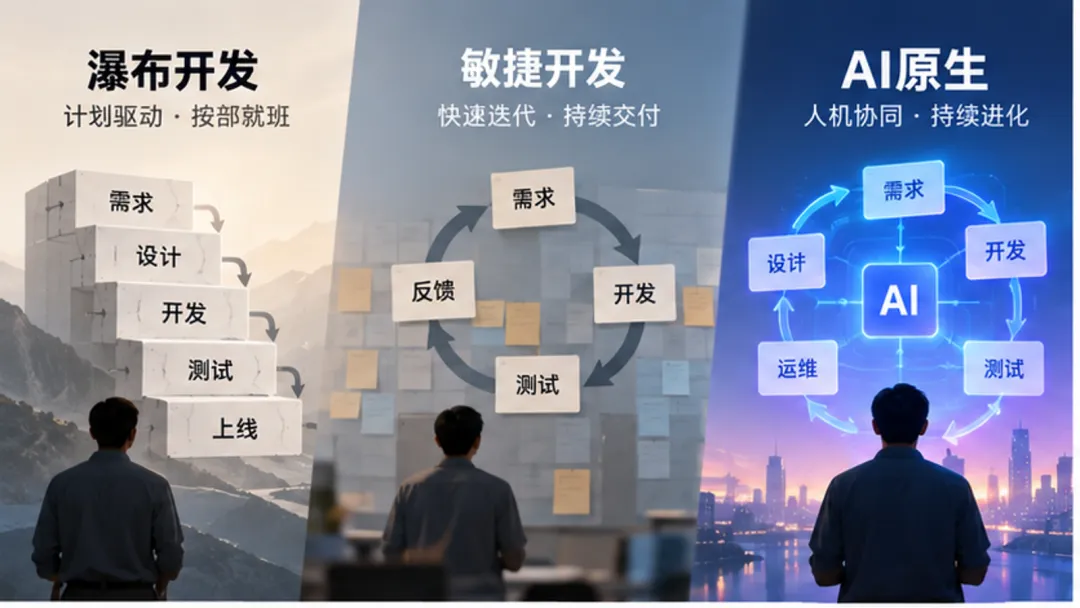
但最近一两年,我越来越明显地感觉到,这个前提开始变了。 在我自己的开发过程中,Coding Agent已经承担了大量具体编码工作。以前按天、按周计算的任务,现在很多可以压缩到几个小时。真正让我在意的,不是“AI让程序员快了多少”,而是当Coding越来越便宜以后,我们还要不要继续按照过去的方式组织软件开发? 这可能才是Vibe Coding背后更大的变化。 DORA在2025年的AI辅助软件开发研究中发现,90%的技术从业者已经在工作中使用AI,超过80%的人认为AI提高了生产率。但DORA把AI形容成一个放大器:组织原来的工程体系顺畅,它会放大优势;原来就混乱,它也会放大问题。 这和我的实际感受很接近。Coding Agent首先改变的是执行速度,但速度上去以后,新的瓶颈很快暴露出来:需求是否清楚、Agent是否理解系统、代码如何验证,以及谁来判断结果够不够好。 所以我并不把AI-native软件工程理解成“敏捷开发+Coding Agent”。如果只是把程序员的工作交给AI,而PRD、测试、上线方式全部不变,那只是局部提效。 敏捷为什么喜欢两周一个Sprint?因为团队需要一个稳定窗口,把需求、开发和测试组织起来。开发能力有限,所以必须估工时、排优先级。 Coding Agent正在削弱这个前提。 OpenAI在2026年2月公开过一个很极端的内部实践:他们从空Git仓库开始,让Codex生成代码、基础设施、工具和文档。五个月后,仓库达到约100万行代码,一个从3名工程师起步的小团队合并了约1500个PR。随着吞吐量上升,瓶颈很快从Coding转向人的QA能力和注意力。 后来OpenAI又公开Symphony,把Linear这样的任务系统变成Agent调度器,每个开放任务对应一个Workspace,由Agent持续执行,人在需要判断时再介入。一些团队采用后,落地PR数量提升了500%;但工程师同时管理三到五个Agent会话以后,上下文切换又成了负担。 这个变化很有意思:Agent越来越快以后,瓶颈又回到了人,只是已经不是人的Coding速度,而是注意力和决策能力。 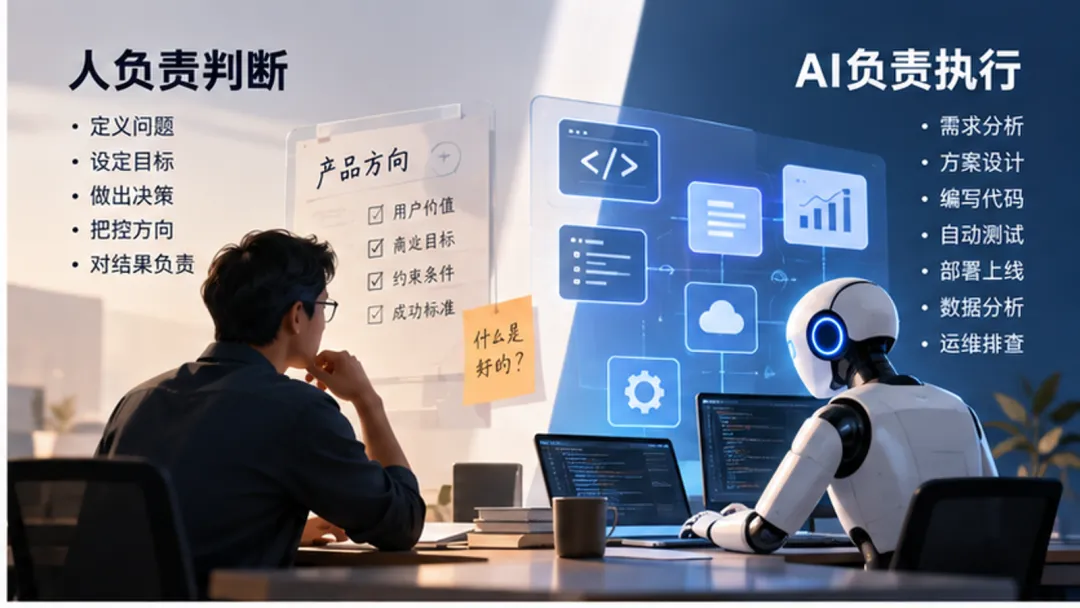
所以我不认为Sprint会马上消失,但它的重要性会下降。未来更值得关注的,可能是一个产品想法从提出、实现、上线,到获得真实反馈到底需要多久。我更愿意把它叫做Idea-to-Feedback Time。 开发速度提高以后,我最近越来越在意另一件事:AI到底能不能“看懂”一家公司。 它不只是能读代码,还要知道功能为什么存在,过去做过哪些决定,哪些业务规则不能碰,Design System有什么限制,这次需求的验收标准是什么。 传统软件公司里,大量重要信息在人的脑子、会议和聊天记录里;但对Agent来说,运行时拿不到的信息基本等于不存在。 OpenAI在前面的项目里后来把Repository Knowledge当作System of Record,用AGENTS.md做索引,再把架构、设计和执行计划放入结构化、版本化的docs目录。原则很简单:不要给Agent塞一本说明书,而是给它一张找到正确上下文的地图。 这也是为什么我现在会特别强调“AI可读”。 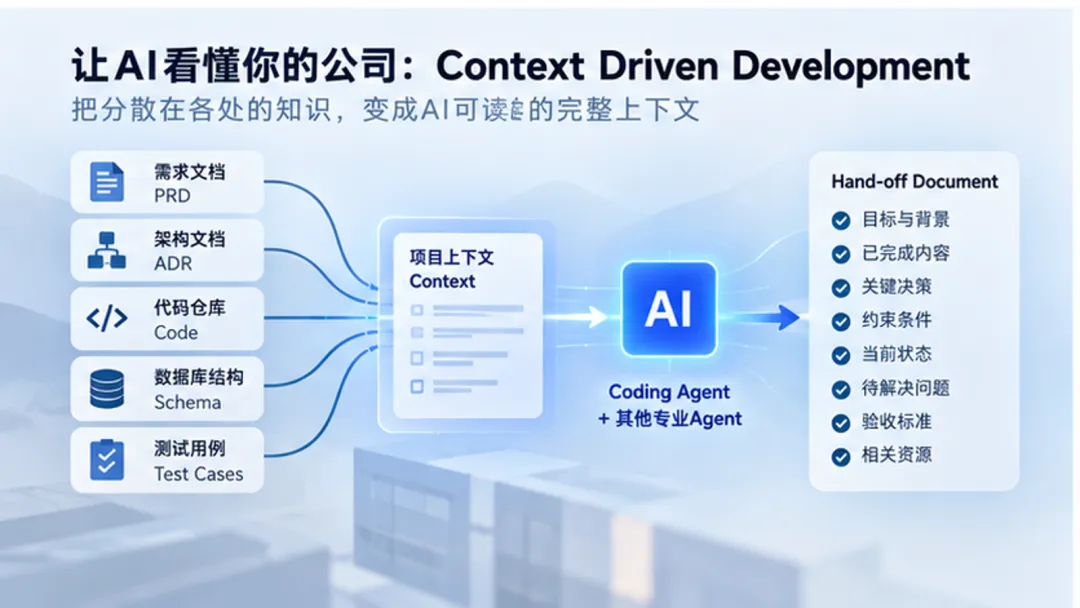
我认为以后一个阶段完成,交付物不应该只有PRD、设计稿或者代码,还应该有一份面向下一个Agent的Hand-off Document:目标是什么,已经完成什么,做过哪些关键决定,哪些约束不能改变,还有什么没有解决,验收标准是什么。 需求、设计、开发、测试、部署和运维之间,不再主要依赖人的口头交接,而是依靠一条持续完整的上下文链。我会把这种方式叫做Context Driven Development。 代码生成更快,并不等于软件交付一定同比变快。 METR在2025年做过一个随机对照实验:16名熟悉自己开源项目的资深开发者完成246个真实任务,允许使用当时主流AI工具的一组,实际平均反而慢了19%。研究者也强调,这只是早期2025年的特定工具、开发者和成熟代码库,不能推广成“AI让所有程序员都变慢”。 这个反例说明,生成代码和交付产品是两件事。DORA后来的研究也观察到类似张力:AI让初始代码生成更快,但部分时间会重新花到审计和验证上,而且可能同时带来更高吞吐和更大的交付不稳定性。 所以在AI-native软件工程里,我认为一个越来越重要的能力会是Verification Engineering。 当Agent一天可以产生过去几天的代码,人不可能继续靠逐行Code Review兜底。测试、接口契约、安全规则、架构边界、数据校验、UI自动化、线上指标,都应该尽量变成机器可以执行的验证规则。 人的角色也会往上移动,集中在几个关键节点:这个需求值不值得做,哪个方案更合适,什么风险不能接受,以及最终谁对结果负责。 我一直觉得“品味”在这里很重要。AI可以很快给出十个方案,但产品不需要十个方案,它需要有人知道哪一个应该留下。 我最近在生产环境里用AI做运维和数据分析,这种变化有时比写代码更明显。 以前线上出现问题,产品或客服发现后交给运维,再找开发,大量时间花在重新传递上下文。如果Agent能够同时读取代码、日志、Metrics、数据库和部署记录,很多问题在产品或运维这一层就可以完成初步定位,开发只处理真正涉及系统修改和架构判断的问题。 数据分析也一样。过去是功能上线以后,运营做报表,产品再根据数据提下一轮需求;现在AI已经可以直接查询生产数据、发现异常、分析用户行为,再把结果带回产品决策。 一旦这些链路接起来,软件开发就不再是“需求—开发—上线”到此结束,而会形成一个持续循环: Intent → Context → Agent Execution → Verification → Production → Feedback → New Intent 这就是我现在理解的AI-native Software Engineering。 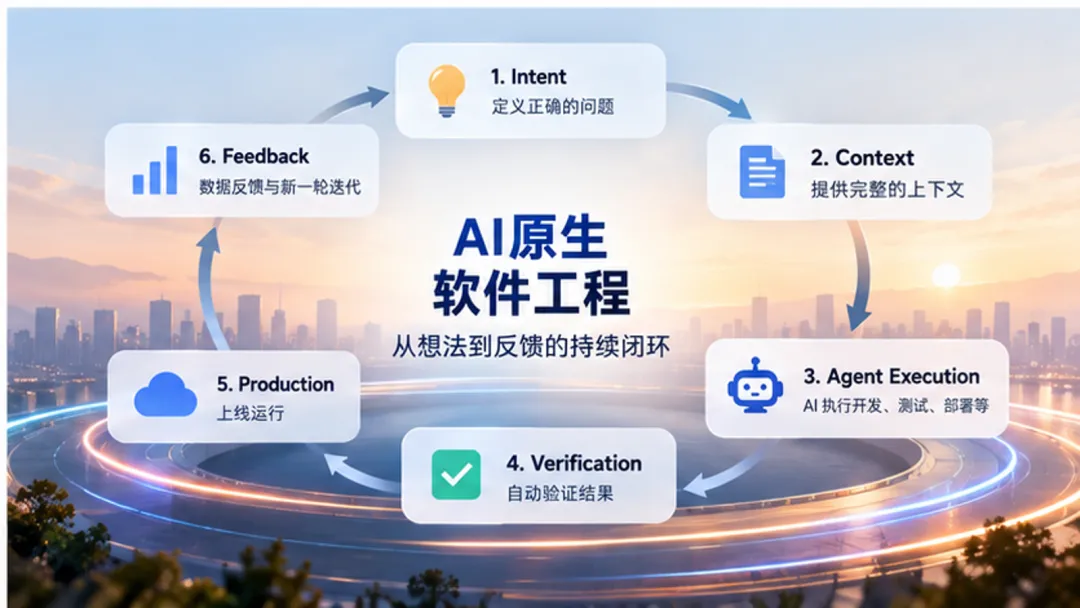
瀑布主要解决大型项目怎样计划,敏捷主要解决变化怎样快速响应。到了AI时代,问题开始变成:当执行能力越来越充足以后,怎样让AI持续获得正确的上下文,在可验证的边界里执行,并且只在真正需要判断的时候把决定交给人。 所以回头看,我并不觉得Vibe Coding本身是这次变化最重要的部分。它只是最先被大家看到的一层。 我做了二十多年软件,现在反而越来越觉得,未来软件工程最稀缺的可能只剩下三样东西:高质量的Context、人的Judgment,以及可靠的Verification。 代码会越来越便宜,但把一个模糊的想法持续变成一个真正好用、可靠,而且有人愿意负责的产品,依然不会便宜。 我把DeepSeek Harness接进生产环境后,发现AI运维真正改变的不是查日志
Coding变快以后,原来的瓶颈开始转移
Sprint不会消失,但它可能不再是最重要的时间单位
软件公司的资产,会从代码进一步转向Context
AI越会写代码,Verification和人的判断反而越重要
开发、运维和数据分析,会逐渐连成一条反馈链
欢迎订阅微信公众号--“Laoer杂谈”
推荐阅读:
拒绝“PM 缝合怪”与半成品魔法:揭秘 Meta 打造现象级 Agent 的内部方法论
155款App拉黑豆包手机:大厂怕的不是AI乱花钱,而是AI不看广告
跑分破纪录、内部重写百万行代码,为什么程序员实测 Gemini 4 还是觉得不如 Claude?
Andrej Karpathy画出AI的0.2%漏斗:真正拉开差距的,已经不是会不会用ChatGPT
AI 有没有意识还没定论,Anthropic 为什么先限制虐待它?
中美AI竞争真正的胜负手,不是谁的模型更强,而是谁先让AI研究AI
苏姿丰花82亿美元请来李飞飞,AMD真正缺的可能不是更快的GPU
Gemini 4 Argon已经开始赢跑分了,但真正的考试还没开始
Muse、dots都来了,但Personal Agent到了中国可能要换一种玩法
GPT-6 Luna比DeepSeek还便宜,AI模型真正的价格战才刚开始
ChatGPT 推出三年后,OpenAI 最终活成了它最不想成为的微软
Claude最新Playbook里,真正重要的不是AI写代码,而是公司开始变得“机器可读”
当OpenAI们开始自己造芯片,英伟达为什么要花140亿美元买Hugging Face?
连Sam Altman都没真正用上Codex,AI还缺一次iPhone时刻
OpenAI断供Cursor之后,编程Agent真正的战争才刚开始