ARTICLE · 1235264
我雇了3个人抄PDF,AI一天就把活干完了
# 我雇了3个人抄PDF,AI一天就把活干完了
19份PDF,24列字段,9个上架渠道。
先说结论:AI帮你省的不是"识别有多准",而是雇人录入的工资和抄错之后赔的钱。
先看项目
这不是一个“给员工配个AI助手”的项目,而是把一条真实业务链路重做了一遍。
谁在花钱
真实情况:一家连锁烘焙品牌的策划、运营和电商团队
输入
真实情况:新品、促销、单店活动等图片型PDF通知
原来的代价
真实情况:3个人花半天抄一份通知,抄错了返工重来
AI介入
真实情况:文本解析、页面渲染、视觉读表、批量预填
系统输出
真实情况:24列上架信息、门店渠道拆行、重复拦截、CSV和Excel导出
现在的代价
真实情况:6份PDF一次写入18条SKU,不用人工逐条录入
下面这张图来自真实通知。品牌和抬头已经裁掉,只保留产品明细表。
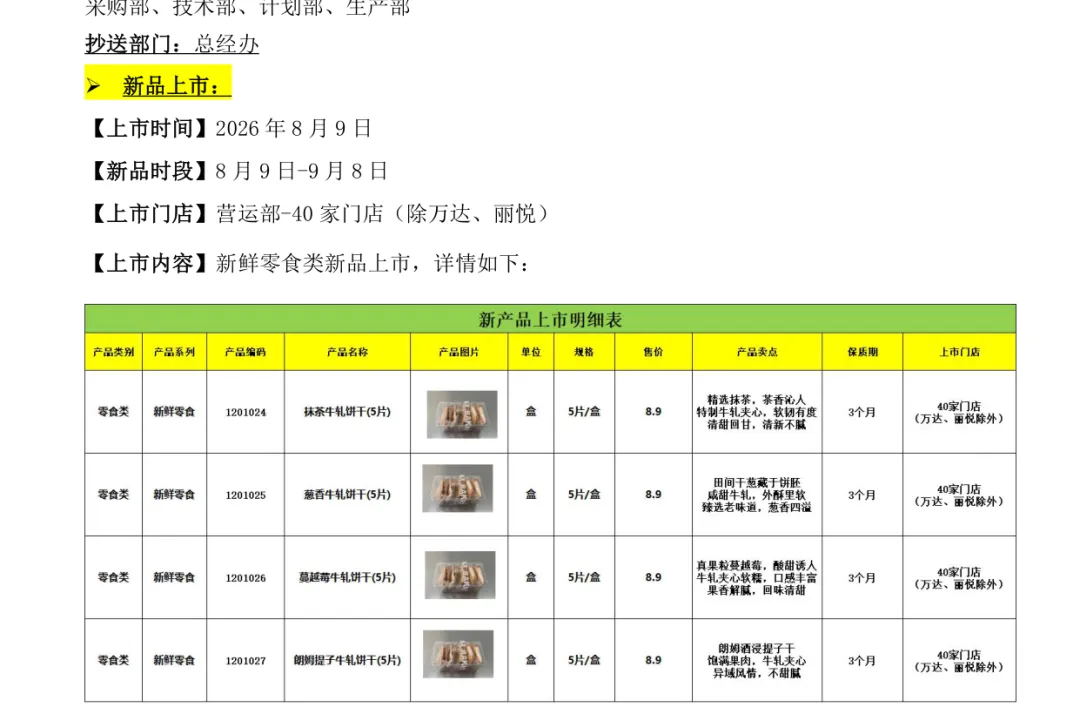
图片型PDF中的产品明细表
这不是OCR问题,是业务口径没固化
一开始很容易把它理解成识别问题。找更强的模型,把图片读出来,不就完了?
真做进去才发现,模型只是其中一段。更难的是,读出来的内容要放在哪一列,哪些字段必须统一,哪些异常必须拦住。
最后定下来的上架主表有24列。
基础信息
关键字段:通知文号、类型、产品类别、系列、SKU、名称
为什么要固定:防止多个系统各叫各的名字
价格活动
关键字段:原价、活动价、活动类型、活动规则
为什么要固定:防止把日常价和活动价混用
商品详情
关键字段:规格、单位、口味、保质期、卖点
为什么要固定:支撑详情页和渠道上架
门店范围
关键字段:门店范围、上架门店
为什么要固定:处理“全部门店”和“除外名单”
渠道范围
关键字段:渠道范围、上架渠道
为什么要固定:同一商品要分发到不同渠道
运营状态
关键字段:产品图片、库存限购、备注
为什么要固定:保留人工确认和完成状态
上架渠道固定为9项:门店POS、美团团购、美团外卖、抖音直播、微商城、社群、微信小店、视频号、快团团。
AI到底接在哪一段
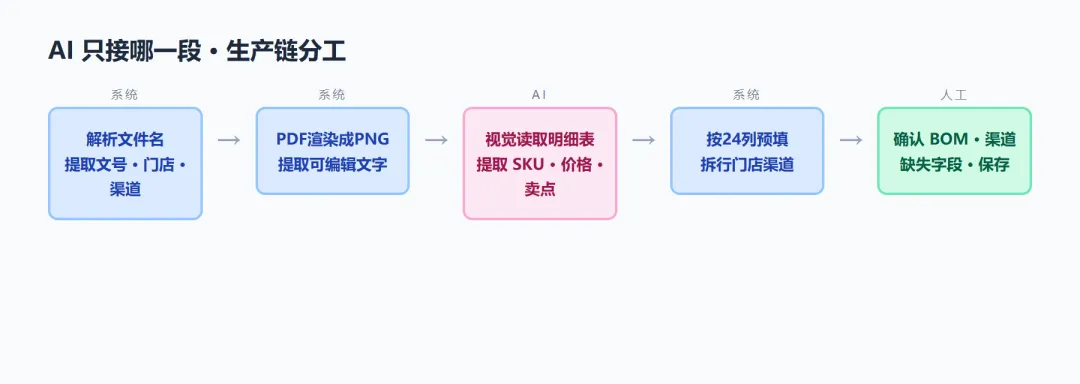
AI只接一段的生产链分工
这个项目没有让AI直接“接管运营”,只让它进入一条有边界的生产链。
1
谁来做:系统
实际动作:解析文件名和通知标题,提取文号、类型、门店范围、渠道范围
2
谁来做:系统
实际动作:从PDF提取可编辑文字,同时把每一页渲染成PNG
3
谁来做:AI
实际动作:读取图片型产品明细表,提取SKU、名称、规格、价格和卖点
4
谁来做:系统
实际动作:按24列结构预填,生成待确认记录
5
谁来做:系统
实际动作:把门店和渠道解析成标签,多门店多渠道自动拆行
6
谁来做:人工
实际动作:检查BOM、门店范围、渠道含义和缺失字段,再保存
系统先用PDF渲染把每页变成图片,再让视觉模型只处理“产品明细表”那一页。这样做的代价是多一步人工判断,好处是不会把整份通知里的广告话术、陈列标准和生产BOM一起吞进去。
真正让项目返工的是4个业务坑
这部分比“模型多聪明”重要得多。
BOM当SKU
表面现象:AI读出了原料和工艺标准
业务真相:那是生产用料,不是售卖商品
最后怎么处理:产品表和BOM表分开识别,非明细表只备查
11店当全部
表面现象:一份PDF解析出几十家门店
业务真相:“11店分批”不是全部门店
最后怎么处理:先解析范围,再从上市门店章节提取具体名单
占位SKU重复
表面现象:3款产品只保存了1款
业务真相:三行SKU都写成短横线,被当成同一条
最后怎么处理:占位SKU改用“文号+产品名称”判重
美团含义不明
表面现象:渠道标签命中两个结果
业务真相:美团团购和美团外卖是不同渠道
最后怎么处理:系统提示人工确认,不替业务猜
第一版最危险的地方,不是少读了字段,而是把“看起来像数据”的内容写进了系统。
比如现烤类PDF里常有产品工艺标准。人一看就知道那是BOM,AI看到“产品名称、规格、用量”,很容易把它当商品明细。
所以后来加了一条硬规则:服务场景、销售话术、陈列标准、入机说明、BOM、工艺标准,全部不进上架主表,只放进“其他表格”备查。
第二个坑更隐蔽
有一份通知写的是“11店分批”。系统第一版把“11店”识别成了通用门店范围,结果展开成数据库里的全部门店。
修复后,系统先看门店范围,再去正文的“上市门店1、上市门店2”章节提取具体名单。最终准确命中11家门店。
第三个坑差点吞掉3个SKU
有一份PDF包含3款麻薯布丁,但原文件没有提供单品SKU,提取结果只好写成短横线占位。
第一版用“文号+SKU+渠道”判重。三行都是短横线占位,系统就认为它们是同一条,最后只保存了1款,另外2款被跳过。
修复方式是把占位SKU归一成空值,改用“文号+产品名称”判断不同商品。
第二次导入时,3款全部进入系统;再次导入同一批数据时,3款又全部被正确拦截。
结果怎么证明
这个项目没有做正式工时测量,所以我不写“节省了多少分钟”或“效率提升百分之多少”。这里只列能核对的交付数字。
已梳理通知
当前结果:19份图片型PDF
上架主表
当前结果:24列固定字段
渠道枚举
当前结果:9个上架渠道
单批视觉写入
当前结果:6份PDF,18条SKU记录
演示库变化
当前结果:5条记录增加到23条
门店范围修复
当前结果:1份PDF准确命中11家门店
多SKU修复
当前结果:1份PDF的3款产品全部保存,重复导入全部拦截
原来的人力代价
当前结果:3个人花半天抄一份通知
系统截图如下。这里展示的是上架填报、门店和渠道标签,以及商品类型化详情。
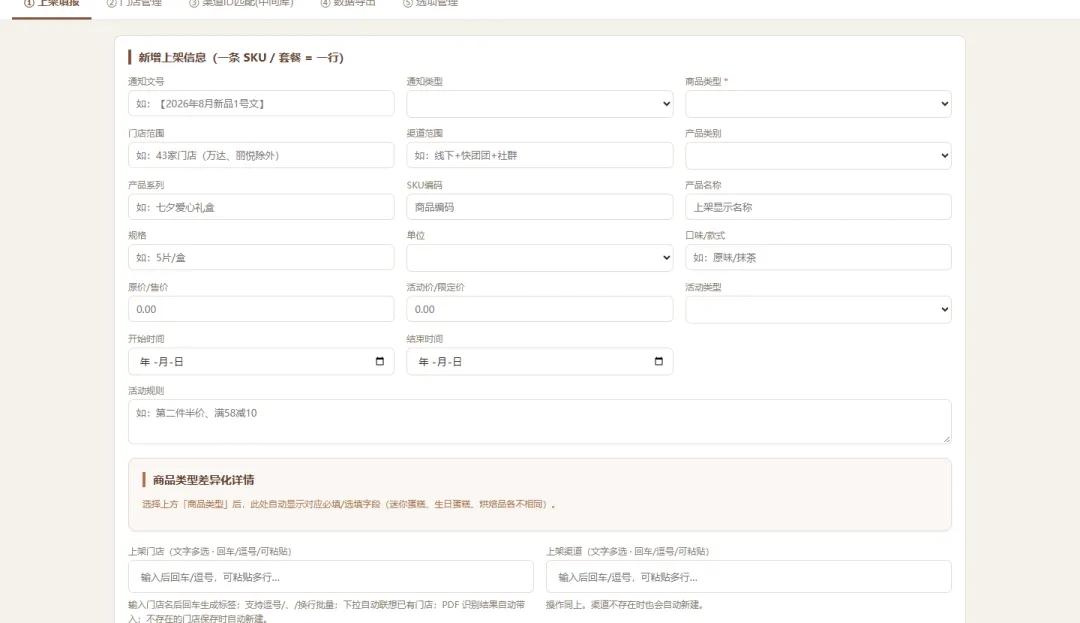
上架信息填报系统
小团队能抄的4条
• 先定你要什么结果,再选工具。你关心的不是"模型多聪明",而是"录入能不能不出错"。
• AI帮你省的是重复录入的时间,不是替你做业务判断。该确认的还是要人确认。
• 把渠道拆开。一个渠道出错只改一个渠道,不用整批返工。
• 让系统先拦错误,再让人确认。而不是让人从头抄一遍再检查一遍。
这套东西听着不炫,但它能被验收。
普通AI帮你写了一篇文章。好的AI落地帮你省掉一个人每天重复做的事。
边界也要说清楚
这个项目不是“PDF一上传就全自动”。图片型表格仍然需要视觉读取,门店和渠道仍然需要人工确认,原文件没有的SKU和保质期只能标为缺失。
它没有解决所有业务问题。它解决的是"你的运营每天在做的最耗时间、最容易抄错"的那一小段。
小团队AI落地最现实的样子,不是多一个聊天框,而是把你雇人做的那件重复事,改成机器做、人确认。
你团队里最想先改造的,是找资料、录数据,还是跨系统搬数据?