ARTICLE · 1245767
【AI观察】全球第四只卖1/5价,开源卷出新姿势
明躺暗卷AI观察 · 第 23 期
每天早上 7 点,8 篇硬核科技解读:事件复盘 · 原理拆解 · 产业算账
▲ 点上方蓝字关注,明早 7 点不见不散
10月24日凌晨,月之暗面发布Kimi K3.1 Pro。3万亿级参数、100万Token上下文、全球开源模型规模第一,Artificial Analysis智能指数55分冲进全球第四——而它的价格,只有GPT-6 Astra的五分之一。国产大模型第一次在「最强」与「最便宜」两个榜单上同时露脸。本篇拆解这颗模型的成色,顺手教你把它用起来。
◈ AI观察 ◈
本期观察对象:月之暗面Kimi K3.1 Pro——一次选在凌晨的突袭式发布,把「全球参数规模最大的开源模型」纪录刷新到了3万亿级。有意思的是,发布前两天,一款名为Kibitz的神秘模型就潜伏在竞技场里被网友逐帧对比,疑似就是K3.1的匿名测试版。国产大公司的发布,已经学会了先潜水再亮牌的节奏。
◈ 成绩单:四张榜,一张比一张硬 ◈
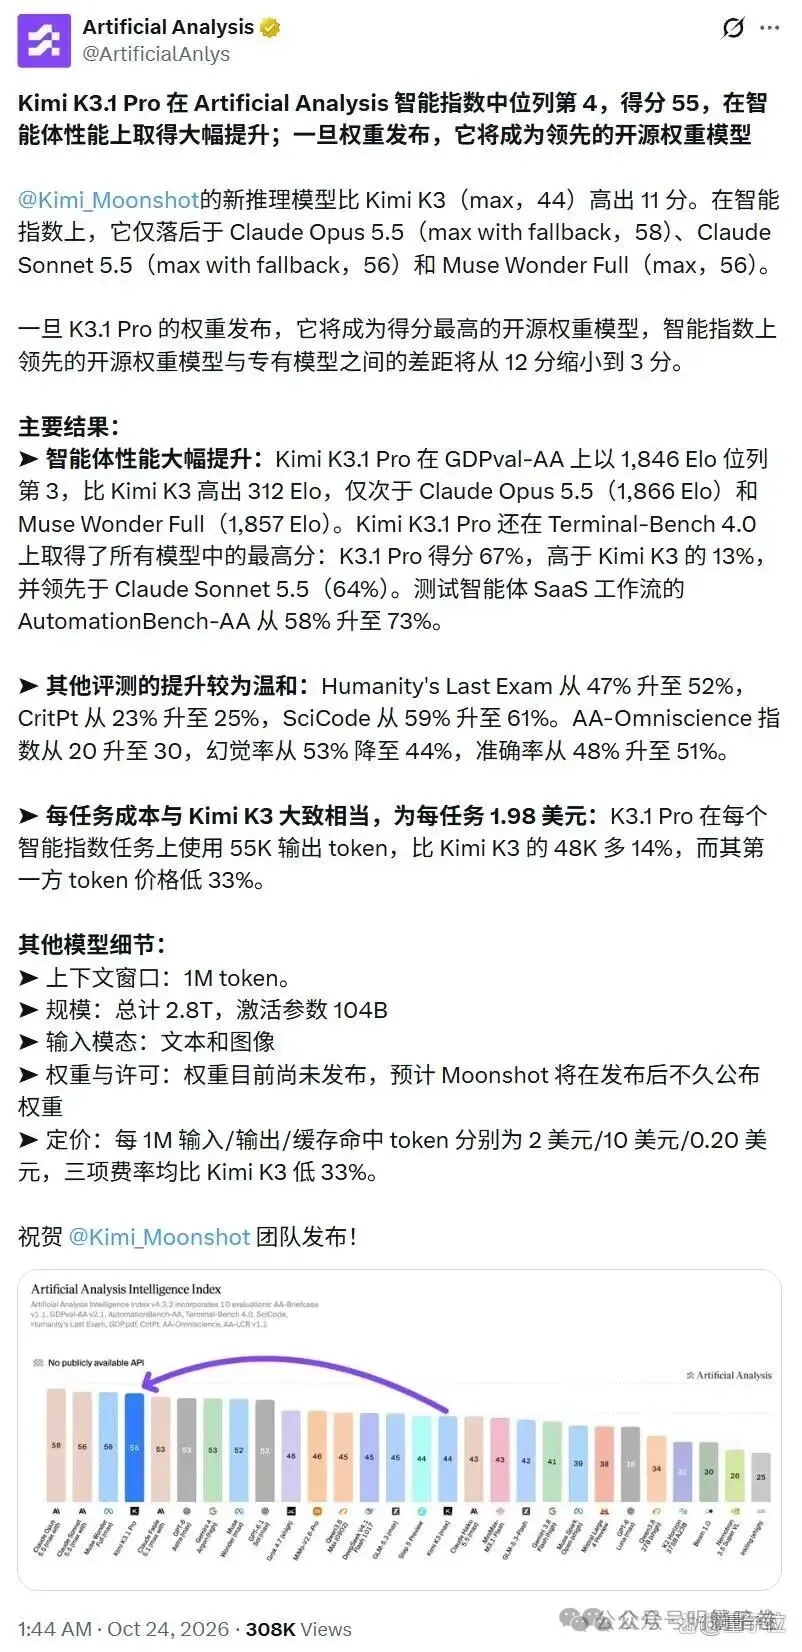
第一张是Artificial Analysis全球大模型智能指数:K3.1 Pro拿到55分,全球第四,较上代K3暴涨11分——这个跨度意味着它一跃进入全球前沿模型第一梯队,紧追其后的是一众闭源旗舰。
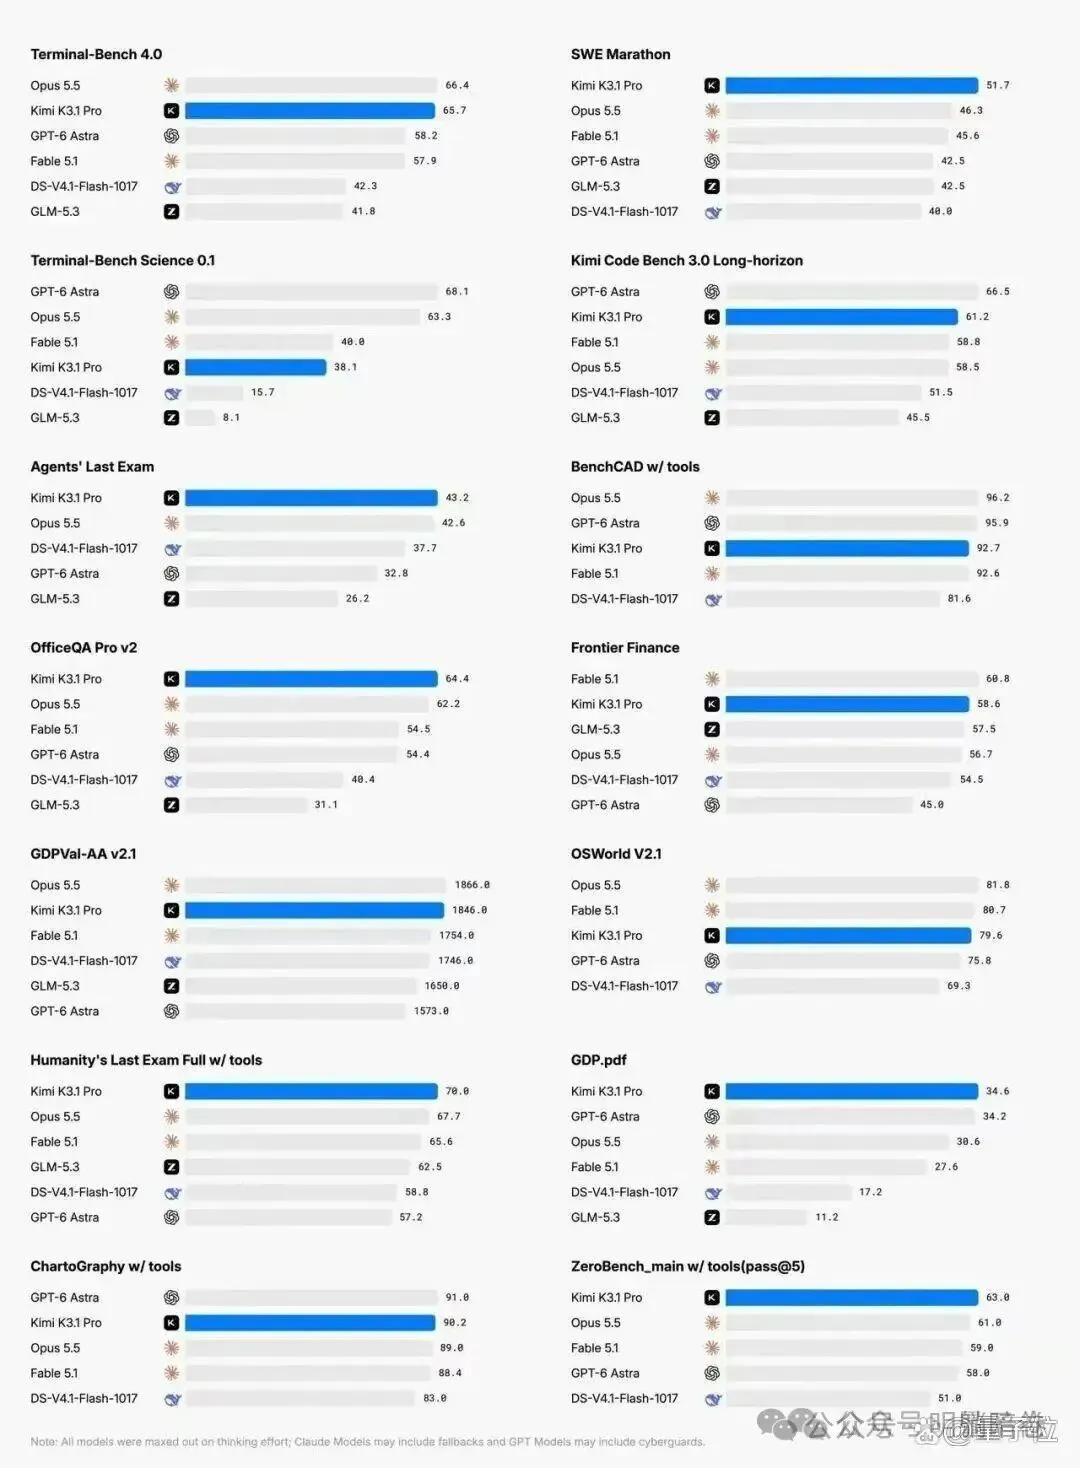
第二张是Terminal-Bench 4.0,专测编程智能体在真实终端环境里的任务执行:K3.1 Pro得分65.7%,超过GPT-6 Astra的58.2%,与榜首Claude Opus 5.5的66.4%只差0.7个百分点。编程智能体测评反超GPT-6,是这次发布被讨论最多的一句话。
第三张是3D与空间推理:BenchCAD基准(从多视角渲染图重建3D模型)借助工具得分92.7%;第四张是金融:OfficeQA Pro v2拿64.4分创当前最优成绩,商业运营基准得分约为K3的4.2倍。幻觉压力测试Kimi Hallu Bench Hard里,单项事实陈述错误率从23.4%降到8.3%——大模型的「一本正经胡说八道」,这代收敛了六成多。
图片来源:百度资讯(AI棒)
◈ 技术拆解:3万亿参数,激活的只有1/27 ◈
K3.1 Pro总参数规模2.8万亿,采用MoE混合专家架构,每次推理只激活1040亿参数——相当于一座27层的大楼,每次任务只点亮其中一层。激活参数决定推理成本,总参数决定知识容量,MoE让「聪明」与「省钱」第一次可以兼得。
训练方式是这次的关键:K3.1 Pro并非新基座,而是基于7月发布的K3做大规模后训练升级——强化学习(RL)被扩展到数百个下游领域,让模型在反复训练中学会「按领域办事」。编程、3D、金融的长板,都是这样一根根补出来的。
两个工程细节值得注意:一是官方在训练数据中剥离了网络攻击相关数据,编程能力不降反升——安全与能力的取舍有了新证据;二是100万Token上下文窗口,足够一次塞进上百份文档做跨文档核对。
◈ 产业账:五分之一的价格,赌的是什么 ◈
价格对比最具冲击力:K3.1 Pro的API每百万Token输入1.3元(缓存命中)/13元(未命中)、输出68元,综合成本约为GPT-6 Astra的五分之一。这不是赔本赚吆喝——MoE架构的稀疏激活,让单位智能的推理成本结构性低于稠密大模型。
开源策略是更大的赌注:11月4日前开放完整权重,任何人都能下载、微调、私有化部署。对月之暗面,开源换的是生态位——全球开发者用你的模型做二次开发,你的技术栈就成为事实标准;此前英伟达已为K3做推理优化、提速1.68倍,K3还接入了Codex企业通道,开源生态的复利已经开始滚动。
背景板是冲刺IPO的月之暗面:已完成上市前最后一轮融资、估值约500亿美元、计划明年一季度赴港。这轮发布的时机耐人寻味——在招股书的关键窗口,用一份全球第四的成绩单讲「技术领先」的故事,比任何路演PPT都有说服力。
◈ AI工具 ◈
本期工具:Kimi K3.1 Pro本体。发布当日即已全线可用,覆盖网页、App、办公与代码四条产品线,这是国产新模型里「发布即可用」完成度最高的一批。以下上手方法与实测口径均来自官方说明与公开测评。
◈ 开源生态账:权重开放后会发生什么 ◈
11月4日权重开放后,K3.1 Pro会经历三类二次生命。第一类是学术界的白嫖式研究:高校实验室下载权重做对齐、蒸馏、安全研究,论文引用反哺模型影响力;第二类是企业的私有化部署:金融、政务等数据敏感行业,把模型搬进内网,跑在自有算力上。
第三类最值得盯——开发者的微调创业:拿3万亿参数的底座做垂直领域微调(法律、医疗、工业),历史上Llama生态孵化出的创业公司已成规模,K3.1 Pro是第一个进入第一梯队的国产候选底座。
对照国际棋局:OpenAI此前指责「有组织蒸馏」并把矛头指向过月之暗面,闭源阵营对开源的态度日趋防御。开源模型逼近闭源性能的每一步,都在压缩闭源厂商的定价权——五分之一的价格差,就是这条博弈线上的最新战报。
图片来源:量子位
◈ 上手:五个入口,各管一摊 ◈
入口一:kimi.com网页版与Kimi App,普通用户主力入口,问答、写作、读文档、3D Make都在这里——3D Make是本次新上线的功能,输入文字或草图生成3D模型,在线预览编辑后可直接下载去3D打印,或导出视频分享。
入口二:Kimi Work,办公场景,主打长文档处理与表格分析;入口三:Kimi Code,编程场景,编程智能体能力的主场;入口四:Kimi API(platform.kimi.com),开发者入口,模型选kimi-k3.1-pro即可;入口五:Highspeed高速版,同等智能、输出速度快2到3倍,价格约2倍——赶时间的场景值得加钱。
选择逻辑很简单:手机上随手问用App,办公室处理百页报告用Work,写代码用Code,做产品集成走API,需要立刻出结果切Highspeed。
◈ 实测口径:三个场景的真实表现 ◈
场景一:编程。Terminal-Bench 4.0的65.7%意味着它在真实终端任务里的多步执行、工具调用已进入第一梯队;公开实测显示它能自己驱动Unity、Unreal、Godot等游戏引擎,结合网络搜索与3D生成做完整交互体验,一次23轮的连续Agent测试可全程自主跑完。
场景二:3D创作。给一段文字描述、一张草图或参考图,它能推断形状、比例与空间关系并重建可用3D模型;无需外接MCP连接器,可直接编写并运行Blender与CAD脚本——参数化建模(机械零件、定制家具)是它被验证过的舒适区。
场景三:金融。OfficeQA Pro v2考察基于真实金融文档的检索、跨文档核对与多步数值推理,64.4分的当前最优成绩意味着财报比对、招股书拆解这类「读百份文件出一张表」的任务已经可用。边界同样明确:幻觉错误率降至8.3%但不为零,关键数字与结论,仍然需要人工复核。
图片来源:百度资讯(量子位)
◈ 适用与边界:什么人该立刻用 ◈
三类人可以立刻上手:程序员(编程智能体已对标闭源旗舰)、内容创作者(3D Make零门槛出模型)、研究与投资从业者(百万Token上下文啃长文档)。相对国产同行,它的差异化在Agent连续任务与3D空间推理;相对GPT-6,差异化在价格与开源。
两件事别指望:一是把开源权重当免费午餐——自己部署要买GPU集群、养推理工程师,百万级起步;二是把它当唯一事实来源——压力测试的8.3%错误率聚焦的正是易错场景,时效信息与关键决策,交叉验证不可省。
一句话定位:它是目前「性价比最高的第一梯队模型」——不是最聪明的那个,但可能是最划算的那个。
◈ 速查:四类人,四种用法 ◈
重度写作者:100万Token上下文是最大红利——把几十份参考资料一次性扔进去,让它做综述与交叉核对;配合追问「给我页码出处」,可核验性远超上一代。
程序员与独立开发者:Kimi Code入口直连编程智能体能力,多步任务执行已是它的强项;预算敏感的团队可以等11月4日后自部署,用闲置GPU跑推理。
内容创作者:3D Make+游戏引擎能力是差异化武器——文字到3D模型、脚本到交互Demo,出片速度是传统工作流的数倍;需要精度的地方(材质、拓扑)仍需专业软件收尾。
普通用户:App日常问答已够用,Highspeed版留给赶时间的场景。唯一提醒:任何关键决策信息,让它给来源链接——8.3%的错误率是压力测试口径,日常更低,但不为零。
◈ 结尾 ◈
凌晨一点发模型,白天冲上全球第四,下周开放权重——国产大模型的节奏,卷成了硬件发布的速度。
你会为开源权重自己搭一套,还是直接用API?评论区聊聊你的选择。
◈ 往期推荐 ◈
1 ·赚37亿落袋2亿,寒武纪的钱进了仓库
2 ·4.19亿人开的豆包,吃掉AI大盘近八成
3 ·大模型要出海先登记,2万亿参数是红线
👇 划到这里不容易——觉得有收获,点个「赞」和「在看」,明躺暗卷今晚出选题就有劲了
⏰ 明早 7 点:一副AI眼镜的产业账、车机九十年进化史,继续深挖
# Kimi # # 开源模型 # # AI工具 #