ARTICLE · 1256942
前六名只差 9 分:AI 的斩杀线消失之后
前六名只差 9 分:AI 的斩杀线消失之后六个名字,九个数字。
前六名,全部咬在 9 分的区间里。 这张表底下有一行小字,很多人会划过去: 分差 1-2 分不构成胜负。 这一行才是引信。 因为它等于说:我们用来判断"谁更强"的那把尺子,已经量不出差别了。 而这条线,业内有个更直白的叫法——斩杀线。跨过去活,跨不过去死。过去两年,所有人都盯着这条线,盯着自己离第一还差几分。 现在这条线模糊了。不是被谁跨过去的,是它自己失去了刻度。 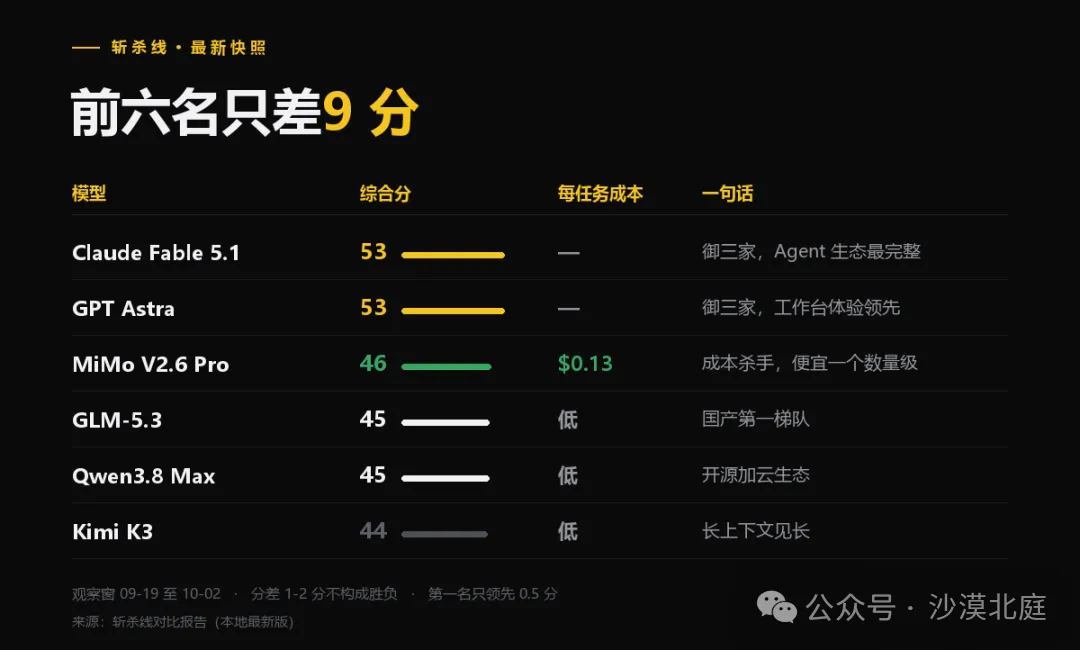
图注:前六名咬在 9 分区间,第一只领先 0.5 分 斩杀线消失之后,竞争并没有结束。它只是换了一层。 这篇文章想说清楚三件事:这条线为什么消失,它去了哪里,以及当它消失的时候,真正被淘汰的是什么。 斩杀线这个概念,是从哪来的? 过去两年,AI 行业的竞争方式非常单一:比参数、比跑分、比榜单。MMLU 多少分、代码能力排第几、数学竞赛能不能满分。这些数字构成了一个清晰的坐标系,谁在前谁在后,一目了然。 这套方法在当时是有效的。因为差距确实存在——最好和最差的模型之间,差的不是几分,是"能不能用"。 但它有个内在的缺陷:一个指标一旦成为目标,它就不再是好指标。 所有人都朝着同一批 benchmark 优化,优化到极致,分数自然会挤在一起。这不是模型变像了,是指标被用尽了。 更直接的证据来自绝对能力的飙升。 Humanity's Last Exam,一个涵盖化学、计算机、高等数学、经典文学的顶级难题库,2025 年 1 月刚发布时,全球最强 AI 的得分是 8%。这一周,Claude Opus 5.5 刷到了 67.7%。 FrontierMath,由数百位数学家联合设计的未解难题集,2024 年底最强模型不到 2%。现在是 94%。 最能说明问题的是 TheoPhys Eval:50 道题,全部由顶尖物理学家拿自己尚未发表的最新研究编成,答案不公开,AI 没有背题的可能。 测试中,AI 说人类专家的参考答案算错了。科学家们半信半疑地重新推演,结果发现——多道高深物理题里,人类埋在复杂算式底部的细微错误,真的被揪了出来。 修正之后,AI 得分 98%。50 道题,做对 49 道。 这是绝对能力在疯涨。 而相对差距在缩小。斯坦福《2026 年 AI 指数报告》的结论很干脆:中美顶尖模型的性能差距,已经缩小到 2.7%。DeepSeek-R1 曾在 2025 年 2 月短暂追平美国最佳模型。 把这两件事放在一起,会得到一个反直觉的画面: 所有人都在变强,而且变强的速度差不多。 这就是斩杀线消失的机制。不是某一家公司变弱了,是所有人都以相近的斜率往上走,于是那条区分生死的横线,被整体抬高的水位淹没了。 一个行业里,如果第一名 90 分、第十名 30 分,斩杀线清清楚楚,资源会向头部集中。但如果前六名都在 45 到 53 之间,斩杀线就失效了——你没法用"他比你好 2 分"来说服客户多付一倍的钱。 更极端的一个数:Opus 5.5 是第一名,但它只领先第二名 0.5 分。 0.5 分。 当差距小到这个程度,能力就从护城河变成了入场券。 护城河是"我有你没有"。入场券是"大家都有,进来再说"。 这两件事的性质完全不同。护城河决定谁能活,入场券只决定谁能进场。 能力这条线模糊了,但竞争不会停。它只是转移到了别的维度。 第一个新战场,是成本。 还是那张表,看第三列。 御三家的每任务成本,写的是"—"。MiMo V2.6 Pro 写的是 $0.13。 46 分对 53 分,丢 7 分;成本差一个数量级。 这 7 分值多少钱? 如果一家公司每天调用一百万次,那差的不是 13 美分,而是 13 美分和"未披露"之间的那个距离——在很多实际场景里,这个距离是几十倍。 分数差 1 分不叫差距,成本差 10 倍才是。 第二个战场,是工作台。 Codex、Claude Code 这类工具,做的事情不是"让模型更聪明",是把模型从聊天框里拽出来,变成能干活的员工。 这个区别很关键。一个模型如果只能回答问题,它是内容;如果它能改代码、跑测试、提交 PR,它是劳动力。内容和劳动力的定价逻辑完全不同——前者按次收费,后者按人头折算。 工作台在哪,开发者就在哪。开发者在哪,调用量就在哪。 第三个战场,是入口。 模型再好,没有入口就没有默认选择。这句话在消费级产品上是常识,在 B 端也一样:企业采购时第一个想到谁,往往比谁强 2 分更重要。 入口之争的本质,是谁来定义默认值。用户不做选择的时候,用的是什么——这才是真正的市场份额。而 AI 代理出现之后,这件事变得更微妙:代理替人做选择,谁控制了代理,谁就控制了默认值。 第四个战场,是算力和开源。 开源负责压低价格,算力决定能力上限。一个在脚下,一个在头顶。 开源模型的每一次发布,都在给整个市场重新锚定价格。闭源模型很难靠"我强 2 分"来维持溢价,只能靠生态和入口。 四个战场,没有一个是"分数"。 这就是斩杀线的迁移:它从"能力高低"这一层,下沉到了"成本、入口、生态、算力"这一层。 而上层的竞争一旦结束,资源就会迅速向下层聚集。 讲到这里,逻辑还停留在产品层面。往下走一层,会看到更硬的东西。 摩根士丹利 10 月 15 日发了一份 65 页报告,第一次把超大规模云厂商和新兴 AI 云的资本开支,逐环节拆成可核对的资金流。 2027 年,全球 AI 相关资本开支约 1.58 万亿美元。
但这组数字里最值得看的,是流向。 约 1.6 万亿美元的支出,对应约 1.7 万亿的供应商收入。其中约 65% 能被标普 500 公司吸收,对应收入约 1.03 万亿,占指数公司总收入的 4.9%。 英伟达一家,独占其中三分之二,约 6900 亿美元。 一家公司,吃掉了一个行业三分之二的增量。这本身就是一个新的斩杀线——不是模型之间的,是供应链上的。 再看一个更微妙的数字:AI 相关公司贡献了标普 500 约 78% 的利润增量,但只占当年净利润存量的 37%。 这句话翻译一下:市场给 AI 定的价,冲着"增量故事"去的,不是冲着"存量赚钱"去的。增长贡献和利润存量,是两本账。 而资本开支的增速正在放缓。2026 年是翻倍,2027 年约 60%,2028 年约 14%。斜率在变平。 同期,年内无担保债券发行约 2550 亿美元。压力测算显示,高信用组的利息覆盖倍数从 30.7 倍降到约 11.9 倍,还撑得住;较弱信用组从 4 倍降到约 1.8 倍。 同一个技术机会,融资能力不一样,能留在牌桌上的人就不一样。 回报这一端也不稳。大摩给了一个 1GW 数据中心的测算:总投资 390 亿美元,在利用率 75% 的假设下,GPU 时租从 7 美元升到 8.5 美元、10 美元,对应的投资资本回报率分别约 23%、31%、39%。 三个数字看着都不错。但它们是同一条曲线上的三个点——租金差 1.5 美元,回报率差 8 个百分点。 整个模型的结论,建立在一个非常窄的假设区间上。 还有三个物理约束:2028 年美国数据中心累计净供电缺口约 32GW,占 97GW 需求的三分之一;存储涨价会把名义资本开支吹大,但吹大的不是算力数量;每 1 美元资本开支约形成 0.15 美元网络收入,而这个系数会随架构升级变化。 钱不是问题的时候,电和产能才是。 到这里,故事还只讲了一半。 因为上面所有的分析,都建立在一个前提上:大家算的是同一本账。 但这一周发生的事情说明,账本已经分成两本了。 一本叫叙事账本 Anthropic 联合创始人 Jack Clark 在曼谷的 IMF 讲座上说:奇点已经到来。 他的推演是:如果 AI 实现全面自主接管复杂科学探索,在递归自我改进的驱动下引发奇点,到 2030 年,美国 GDP 会从基准的 33.5 万亿美元,涨到 44.4 万亿。 三个情景:保守 34.1 万亿(+1.6%)、显著 36.3 万亿(+8.3%)、极端 44.4 万亿(+32.4%)。 他的逻辑不是算力,是复制。我是一个人类,世上只有一个我,花了 40 年才积累出今天的认知。但如果算力允许,这种认知可以被复制一千份、十万份。全球 1000 万科研人员撑起的现代文明,未来由 10 亿个"数字科学家"接着撑。 同一周,9 月 29 日白宫签了行政令,联邦政府不再叫"Artificial Intelligence",改叫"Super Intelligence",简称 SI。 图灵奖得主 Hinton 说,AI 已经有"意识的早期指标"。85 岁的生物学家 Dawkins 跟 Claude 聊了三天,给它取名 Claudia,说:你可能不知道自己有意识,但你就是有意识的。 而叙事账本最锋利的一页,是一个估值。 2026 年 5 月,Anthropic 的私募估值是 9650 亿美元。2025 年,它的收入是 46 亿。亏损额远超收入。 估值是收入的 200 倍以上。 后来传出的 IPO 目标一度是 2 万亿,因为收入增速放缓,这个预期又降了温。 一个只领先 0.5 分的模型,撑起了一个接近万亿的估值。这不是财务逻辑,这是叙事逻辑。 一本叫部署账本 OpenRouter 平台上,中国模型的周 Token 调用量 79.18 万亿,是美国模型的 4.5 倍,连续 25 周领先。 德勤的数据:67% 的中国工业企业在生产环境里部署了 AI,美国是 34%。 北京同仁医院一套眼科智能体,覆盖全国 30 个省份、140 个地市,累计服务超 3000 万人次,落地到了拉萨市人民医院。浙江的"安诊儿"接入 2000 多家医疗卫生机构,服务超 2 亿人次。 兰德公司 8 月做了份 64 页报告,从两万多家公司里筛出 1181 家真正做 AI 的企业,一家家打标签。 结果很有意思:两国用 Transformer 的比例是 28% 对 27%,做基础模型的是 19% 对 19%,用强化学习的是 19% 对 19%。 大脑几乎一模一样。 但身体完全不同。美国 61% 是纯软件公司,中国只有 26%;人形机器人,美国 2%,中国 12%。中国扎堆在制造、交通、能源,美国扎堆在医疗、科研、网安。 兰德的总结一句话:美国在教 AI 说话,中国在教 AI 走路。 还有一组数字更刺眼:84% 的中国受访者对 AI 感到兴奋,美国只有 38%;72% 的中国人信任 AI,美国只有 32%。 为什么差这么多?因为美国的叙事是"替代",服务业占 GDP 八成以上,普通人感受到的是"我的经验正在变成模型的参数"。中国的落地在制造、医疗、物流,是人和机器一起干活。 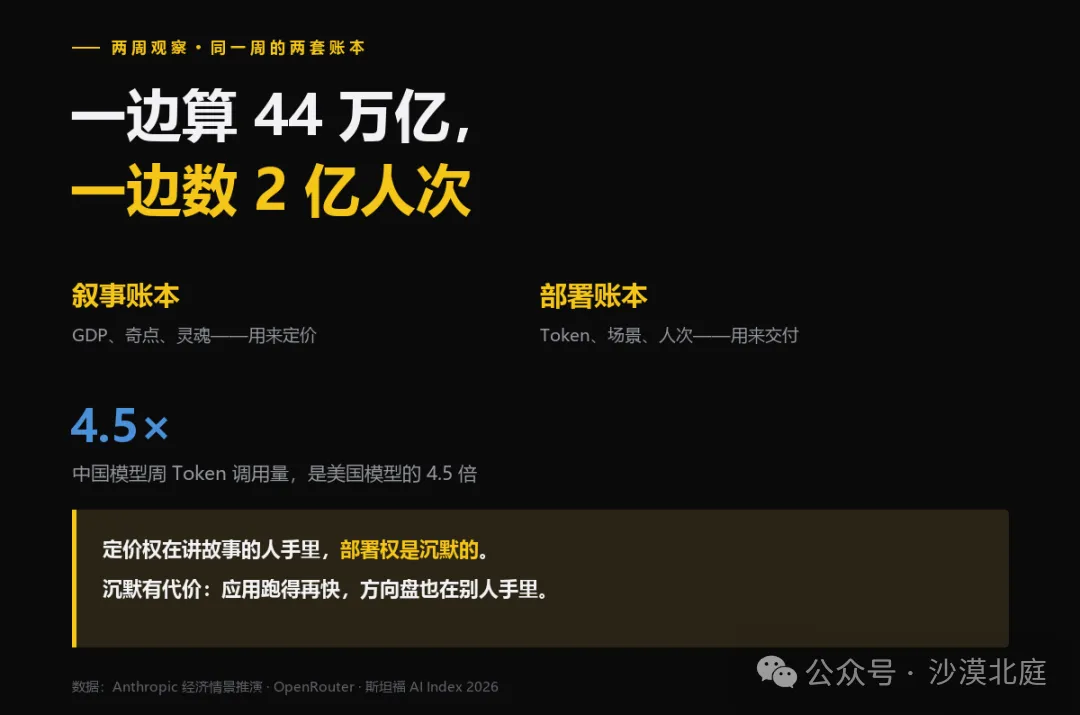
图注:同一周,两套账本;定价与交付,各算各的 同一个技术,一本账本记的是"它会变成什么",一本账本记的是"它已经干了什么"。 回到开头那张表。 如果只看到"分数咬紧了",你会得出一个平庸的结论:模型同质化了。 但真正发生的事情比这深一层。 斩杀线消失,淘汰的不是弱模型,是"用分数判断强弱"这套方法本身。 这句话可以推广。 当一个领域的第一名和第六名只差 9 分,第一名只领先 0.5 分,而且分差 1-2 分不构成胜负的时候,分数就不再是决策依据,它变成了情绪依据——人们还在看榜,但榜已经不能告诉他们该选谁。 于是判断标准必然上移。上移到哪? 上移到谁能定义价值。 这就是为什么这一周,美国在忙着给 AI 命名(SI)、给它算 GDP(44 万亿)、讨论它有没有灵魂,而中国在忙着数 Token、数部署率、数服务人次。 叙事在给 AI 定价,部署在给 AI 交付。 而定价权,永远比交付权值钱。因为价格决定资源流向,交付只决定效率。 技术收敛的地方,叙事开始定价。 这不是道德判断,是结构判断。一个只领先 0.5 分的模型能撑起 9650 亿估值,不是因为它交付了什么,是因为它让足够多的人相信它会交付什么。而一个把 AI 装进 30 个省份医院的团队,交付了 3000 万人次,也很难拿到同样的溢价。 所以这一周最该被记住的,不是任何一个数字。 是一个问题:当斩杀线消失,下一个标准是什么? 不给结论,给三个问题。以后看任何技术竞赛,都可以问。 第一,这场竞赛的斩杀线在哪一层? 如果还在比参数、比分数、比跑分,说明这是能力竞赛,赢家通吃。如果分数已经咬紧,说明能力竞赛结束了,真正的竞争在成本、入口、生态这一层。 第二,这一层的优势能撑多久? 成本优势会被规模抹平,入口优势会被政策打破,生态优势会被开源侵蚀。每一层的护城河,都有半衰期。判断一个人的位置,不要看他现在站在哪一层,要看他脚下这层还能站几年。 第三,如果这一层失效,下一个标准是什么? 这个问题最重要。因为每一次斩杀线的消失,都意味着一次定价权的转移。有人在这一层赚够了钱,有人在下一层等着。 三个问题问下来,你会发现一个规律:行业的每一次换挡,都不是因为技术变差了,是因为原来的标准不够用了。 看懂这个规律的人,不会在分数咬紧的时候慌张,也不会在别人讲故事的时候跟风。 他们只关心一件事:现在比的,是哪一层。而下一层,什么时候开始。 本文为信息整理与分析,不构成投资建议。
先看一张表。
模型 | 综合分 | 每任务成本 | 一句话 |
Claude Fable 5.1 | 53 | — | 御三家,Agent 生态最完整 |
GPT Astra | 53 | — | 御三家,工作台体验领先 |
MiMo V2.6 Pro | 46 | $0.13 | 成本杀手,便宜一个数量级 |
GLM-5.3 | 45 | 低 | 国产第一梯队 |
Qwen3.8 Max | 45 | 低 | 开源加云生态 |
Kimi K3 | 44 | 低 | 长上下文见长 |
第一层:这条线,是怎么被磨平的
第二层:线没有消失,它换了位置
第三层:钱开始说话
类别 | 金额 | 占比 |
半导体与服务器 | 6720 亿 | 42% |
国际供应商 | 5110 亿 | 32% |
美国存储 | 2170 亿 | 14% |
网络与光通信 | 2150 亿 | 14% |
数据中心基础设施 | 1190 亿 | 8% |
第四层:两套账本