ARTICLE · 1272259
今天,AI把计算机科学的“地基”拆了,然后发现自己正站在上面
嘿,朋友们,我是老张。
今天早晨我把几条新闻摊在桌上,看了很久。
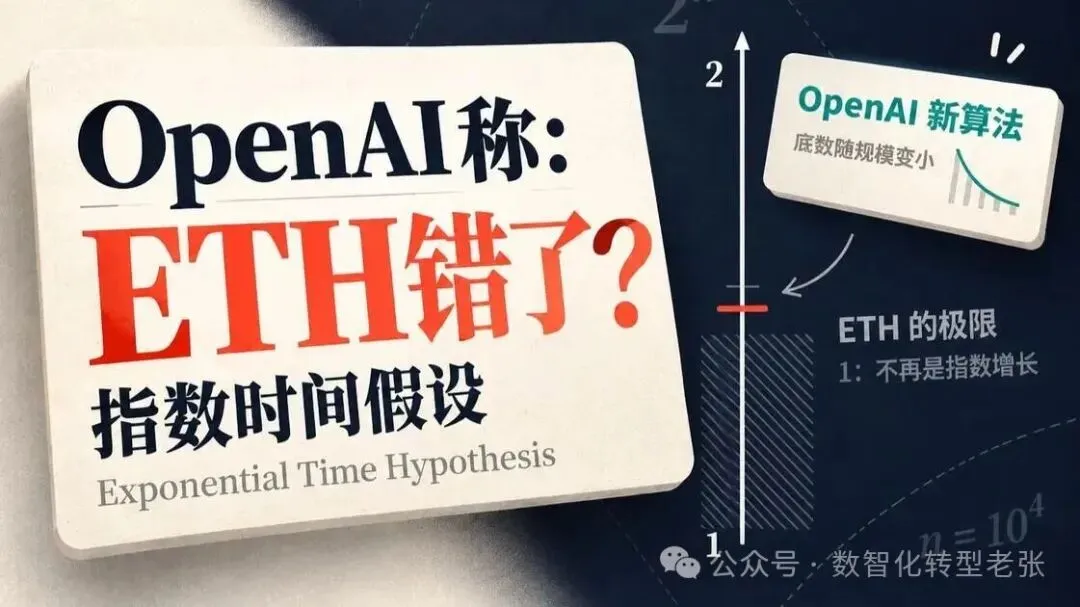
一条来自理论计算机科学:OpenAI和Anthropic在同一天宣布,各自的内部模型独立证伪了统治学界27年的“指数时间假设”(ETH)。Anthropic那篇论文的署名作者只有Claude,消耗1400万输出Token,没有任何人类输入。OpenAI的版本从自然语言证明到Lean形式化验证,只用了一天。
另一条来自算力基础设施:英伟达和甲骨文宣布Vera Rubin NVL72在OCI上扩展至吉瓦级规模,推理成本降至Blackwell的1/10,每兆瓦Token吞吐量提升10倍。关键设计不是“更多的GPU”,而是把Agent工作流里那些GPU等CPU的间隙,用一颗专门的Vera CPU填上——GPU负责“想”,CPU负责“在两次思考之间干活”。
还有一条,来自生成范式:扩散智能开源了Clover-35B-A3B-Preview。它不是自回归模型,它用块扩散并行生成,在Agent任务上中位执行时间1.52秒,对比自回归+扩散混合方案3.21秒,成功率98.6%对95.9%。SWE-bench Verified 73.6,Terminal-Bench 2.1 51.7,同尺寸下全面压过自回归对手。
老张把这三件事放在一起,看到的是同一个动作,但它的方向,和昨天、前天都不一样。
昨天聊的是“墙”——监控被拔出来、迁移摩擦被砍掉。今天聊的是“地板”——AI正在改写它自己赖以运行的理论假设、效率结构和生成范式。
不是“AI变强了”。是AI开始动那些“强”本身所依赖的底层假设了。
第一刀:ETH被证伪,动摇的不是“能不能算得快”,是“什么算难”
先把这个事的技术分量说清楚。
1999年,Impagliazzo和Paturi提出ETH:3-SAT这类问题,不存在亚指数时间的通用解法。最坏情况下,求解时间绕不开指数级增长。
这个假设在过去27年里,不是“一条参考意见”。它是几百篇论文的地基。图论、数据库、计算几何、计算生物学——大量研究以“ETH成立”为前提,去证明某些问题“本质上就是难的”,从而划定算法优化的理论边界。
现在AI说:这个地基是错的。
Anthropic的论文标题是《A 2^o(n) Time Algorithm for 3-SAT》。OpenAI的版本更直接:《指数时间假设是错的》。两篇论文都公开了Lean形式化证明,由ETH的提出者Impagliazzo和Paturi本人带队审验。
老张要你们注意一个细节:这不是“AI找到了一个更快的算法”,这是“AI推翻了一个关于‘快’的边界的假设”。前者是在给定的游戏规则里赢了;后者是告诉所有人,游戏规则本身写错了。
这意味着什么?意味着过去27年里,所有以ETH为前提的“下界证明”,都需要重新审视。不是那些证明错了,是它们所依赖的那个“不可能”的前提,可能不再成立了。一个领域的“禁区地图”被撕了,上面标着“此路不通”的地方,现在需要重新勘探。
而且Anthropic的版本里有一个让老张后背发凉的表述:核心算法由Claude在零人类干预的情况下独立推演发现,唯一作者是Claude。1400万输出Token,相当于一个顶级博士后一到两年的科研工作量,在几天内完成。
AI不是在“帮人类做证明”。它在做“人类没有做出来的证明”。
第二刀:Vera Rubin的1/10,不是“芯片更强了”,是“GPU不再为CPU的活买单”
再说算力这条线。
“推理成本降至1/10”这个数字,如果只看GPU,是解释不了的。单颗Rubin GPU的算力提升,不可能带来一个数量级的成本下降。
真正的变化藏在架构分工里。
英伟达和甲骨文这次做了一件很具体的事:把AI负载拆成两类,分别用专用硬件承接。GPU密集型的前沿模型训练和推理,交给Vera Rubin NVL72;而Agent在两次模型调用之间执行的那些CPU密集型任务——工具调用、测试代码、检索数据——交给Vera CPU专门处理。客户可以独立伸缩CPU和GPU资源。
老张给你翻译翻译这个设计在解决什么。
Agent的工作流,从来不是“GPU从头跑到尾”。一个Agent执行任务,是“调模型→调工具→调模型→调工具”的交替循环。在“调工具”的那段时间里,GPU是闲着的。它等着CPU把工具调用的结果喂回来。传统架构里,CPU只是“管管数据搬运”的配角,工具调用的速度不够快,GPU就得空转。
Vera CPU的定位,就是把这段“GPU空转等CPU”的时间,用一颗专门为Agent工作流优化的CPU填上。高单线程性能加速单个tool call,高内存带宽支撑多并发Agent任务。OpenAI已经确认把Vera引入生产环境,用于agentic sandbox工作负载。
“1/10成本”的本质,不是GPU变便宜了,是GPU不再为它不擅长的事情买单。当算力系统开始按“Agent工作流的真实形态”来设计分工,而不是按“训练一个大模型”的形态来堆卡,效率的释放是结构性的。
第三刀:Clover证明了一件事——自回归不是Agent的唯一语法
第三条线,看起来最“小”,但老张觉得它的长期含义可能最深。
自回归模型生成文本的方式,是“词语接龙”:一个Token一个Token往外吐。这个范式统治了语言模型十几年。Agent时代的所有推理优化——KV Cache、投机解码、Prefill/Decode分离——本质上都是在让“串行生成”跑得更快。
Clover换了一个范式:块扩散,并行生成。它把待生成的内容分成若干块,块内多个位置同时更新、相互参考,块与块依次推进。在Agent任务上,中位执行时间1.52秒,对比自回归+扩散混合方案3.21秒;成功率98.6%对95.9%。六项Agent评测中均取得所列最高分,SWE-bench Verified 73.6,Terminal-Bench 2.1 51.7,同尺寸下超过自回归模型Qwen3.6-35B-A3B。
老张要你们注意的不是这些数字,是这件事在“范式层面”说明了什么。
过去大家默认一件事:Agent要调用工具、要连续执行任务,必须用自回归模型,因为工具调用需要“看到上一步结果再决定下一步”,而自回归的串行特性天然适配这种“逐步推进”的逻辑。扩散模型以前在Agent任务上不稳定,工具调用格式出错、同一步骤反复尝试——这是行业共识。
Clover的突破在于:它用并行生成的范式,把“连续操作”这件事做对了。它重构了门控Delta网络,让历史记忆压缩进持续更新的状态,当前生成的块通过双向注意力相互参考,模型自己学习如何权衡前文与当前内容。
这意味着“Agent必须串行生成”可能是一个范式假设,而不是一个物理事实。当并行生成的质量和稳定性追上串行生成的时候,Agent推理的成本结构、延迟结构、甚至“什么算一个好的Agent架构”的定义,都需要重写。
老张的几点判断
第一,今天三条线指向同一个“元层面”的转向:AI正在从“在给定框架内优化”,走向“改写框架本身”。ETH被证伪,改的是“什么算难”的理论假设。Vera Rubin改的是“算力系统按什么形态分工”的架构假设。Clover改的是“Agent必须串行生成”的范式假设。这三件事的共同点是:它们都不是“在现有规则里做得更好”,而是“指出规则本身可能写错了”。这比任何跑分提升都更值得认真对待,因为框架层面的变化,会重新定义后面所有的优化方向。
第二,ETH这件事的真正风险,不在“证明对不对”,在“验证的锚点在哪里”。两篇论文都交了Lean形式化证明,这是目前最硬的机器可验证证据。但Lean验证的是“证明的逻辑结构是自洽的”,不是“这个证明所依赖的定义和公理,和人类数学家心里想的是同一个东西”。Anthropic的论文里,Claude调用了一些“冷门数学工具”,人类审稿人需要先把60多页的证明压缩成22页才能读懂。当AI产出的证明在逻辑上无懈可击、但在认知上超出人类直觉的时候,“验证通过”和“理解正确”之间的缝隙,就是一个新的风险面。
第三,Vera Rubin的1/10成本,对Agent经济的含义比表面数字更大。当Agent工作流里“GPU等CPU”的浪费被结构性消除,Agent的持续运行成本会下降一个台阶。而这恰恰是Agent从“Demo”变成“7×24小时数字员工”的关键门槛。但老张要提醒一句:这个1/10是“预期性能”,量产爬坡和实际负载下的交付数据,才是检验标准。方向是对的,但“系统级效率”的兑现,从来比“芯片级性能”慢。
第四,也是最让老张在意的。ETH被证伪这件事,给整个AI行业提出了一个比“对齐”更根本的问题:当AI开始改写那些“人类用来判断AI是否正确”的理论基础时,人类用来验证AI的尺子,本身是不是也在被AI改写?ETH是27年来人类用来划定“算法能有多快”的边界。AI推翻了它。下一次,AI推翻的会不会是人类用来验证AI的某个更底层的假设?
Clover用并行生成做对了串行生成能做的事。ETH用亚指数算法做对了指数时间“不可能”做到的事。Vera Rubin用CPU补位让GPU不再空转。三件事,同一个方向:旧框架的边界,正在被从里面推开。
📌今日讨论话题:
OpenAI和Anthropic同日证伪ETH,AI独立推翻了统治27年的理论假设;Vera Rubin用“GPU+专用CPU”的系统级分工把推理成本砍到1/10;Clover用扩散并行生成在Agent任务上压过自回归。当AI开始改写它自己赖以运行的理论地基、效率结构和生成范式时,你认为人类用来验证AI的“尺子”——形式化证明、性能基准、人工审查——哪一个会最先失效?如果你的团队在构建Agent系统,你会押注“在自回归范式里继续优化”,还是开始认真评估并行生成这类“换范式”的路线?欢迎在评论区聊聊。