ARTICLE · 1274113
ai-toolkit 源码走读:一份配置怎样变成 LoRA 训练,哪些地方会静默失效
ai-toolkit 源码走读:一份配置怎样变成 LoRA 训练,哪些地方会静默失效这一篇讲下用来做扩散模型LoRA训练的框架,ai-toolkit。 下面是一份直接手写的 ai-toolkit YAML 片段,用来训练 FLUX.2 [klein] 4B 的低秩适配(Low-Rank Adaptation,LoRA),只保留和本文有关的字段: network: type: lora linear: 32 linear_alpha: 16 train: steps: 2000 seed: 42 按 ai-toolkit 当前代码(commit 73ebae13)读,这份配置有三处和字面意思不同: 没写 lr,学习率落到代码默认值 1e-6,比 Black Forest Labs(BFL)组织在 Hugging Face 上发布的 Klein LoRA 指南所用的 1e-4 小两个数量级。网页 UI 新建任务时会预填 1e-4,只有直接写 YAML 才会落到这个默认值。linear_alpha 被忽略,对 Klein 这类 transformer 模型,代码把 alpha 强制设成 rank,缩放恒为 1,不是 16/32。train.seed 不是训练配置里的字段,写了不生效。 这三处都不会报错,配置照常加载,训练照常开始。这篇沿着一份 YAML 在代码里经过的六个位置,把这类地方标出来,一共十一处。这里的“静默”指不报错、不中断训练:有的会在日志里留一行提示,有的什么都不留。它们大致分两类:一类出在配置层,把配置写全、写对就能避开;另一类出在运行层,只能靠启动前后的检查发现。 代码版本与范围|ostris/ai-toolkit main,commit 73ebae13(2026-10-24)。仓库没有发布 tag,只能按 commit 固定,下文行号都以这个版本为准。本文是静态读代码的结果,没有实际运行;细节以 diffusion_trainer 训练 Klein 4B、network.type 为 lora 的路径为准,其他模型和网络类型请自行核对。 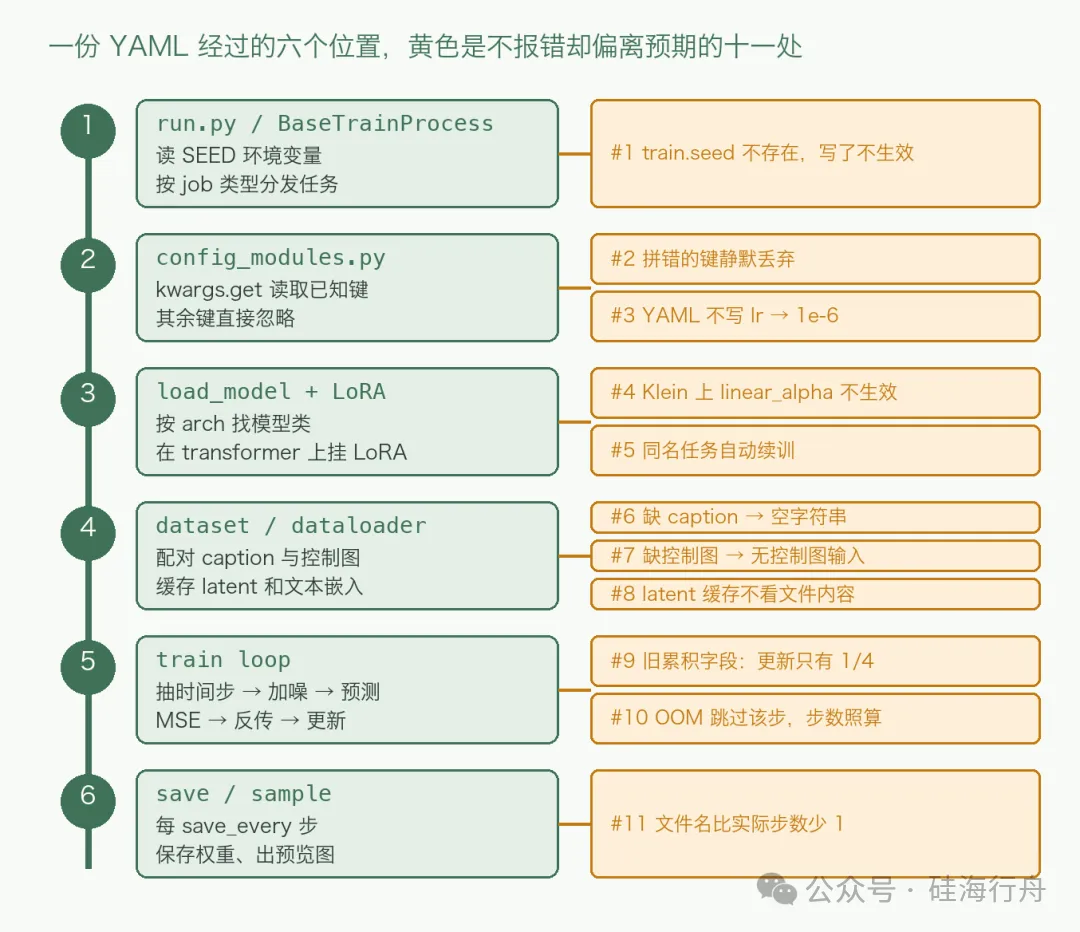
图 1|一份 YAML 在 ai-toolkit 里经过的六个位置,右侧黄框是十一处不报错、但结果会偏离预期的地方 入口在 # run.py 第 10–15 行 seed = None if "SEED" in os.environ: try: seed = int(os.environ["SEED"]) except ValueError: print(f"Invalid SEED value: {os.environ['SEED']}. SEED must be an integer.") 之后按配置里的 #1 train.seed 不生效(影响复现)。训练配置类 分发这一层的检查是严格的:job 类型、process 类型、模型 arch 写错都会直接报错。代码注释还特意提到,arch 写错以前会静默退回 SD1,现在改成了报错。不报错的问题出在下一层。 YAML 被拆成几个配置类: #2 拼错的键被静默丢弃。把 #3 YAML 不写 lr,学习率是 1e-6。 # toolkit/config_modules.py 第 384 行,TrainConfig.__init__ self.lr = kwargs.get('lr', 1e-6) BFL 组织名下的指南用 1e-4 训练 Klein LoRA,这个默认值比它小两个数量级。按指南的设置看,用 1e-6 训练 2000 步,LoRA 很可能几乎学不到东西(笔者的判断,没有做对照实验)。这个值只在直接写 YAML 时生效,网页 UI 新建任务时已经预填了 1e-4,两种入口的其他默认值也不一样,见第 6 站之后的“入口差异”。 #4 对 Klein,linear_alpha 不生效。配置层确实有 alpha: # toolkit/lora_special.py 第 422–431 行 # always do peft for flux only for now if self.is_flux or self.is_v3 or self.is_lumina2 or is_transformer: # don't do peft format for lokr if using old format if self.network_type.lower() != "lokr" or not self.use_old_lokr_format: self.peft_format = True if self.peft_format: # no alpha for peft self.alpha = self.lora_dim alpha = self.alpha FLUX.2 的模型类里写着 #5 同名任务会自动续训。创建网络之后,代码会去 # jobs/process/BaseSDTrainProcess.py 第 2027–2032 行 latest_save_path = self.get_latest_save_path(lora_name) extra_weights = None if latest_save_path is not None and not self.train_config.merge_network_on_save: print_acc(f"#### IMPORTANT RESUMING FROM {latest_save_path} ####") print_acc(f"Loading from {latest_save_path}") extra_weights = self.load_weights(latest_save_path) 加载权重时,代码还会从权重的元数据里读出上次的步数,训练循环从这个步数接着走。按这条代码路径推断:改了学习率或数据、却没改任务名就重新启动,训练会接着上次的权重和步数继续;如果上次已经跑满 数据集按 #6 缺 caption 文件时,caption 是空字符串。 #7 缺控制图时不报错。配对逻辑在 # toolkit/dataloader_mixins.py 第 1189–1207 行(节选) for control_path in control_path_list: for ext in img_ext_list: if os.path.exists(os.path.join(control_path, file_name_no_ext + ext)): found_control_images.append(os.path.join(control_path, file_name_no_ext + ext)) self.has_control_image = True break ... if len(self.control_path) == 0: self.control_path = None 找不到同名控制图,就把控制路径设成 None,读取阶段既不报错也不警告。 #8 latent 缓存不看文件内容。开了 图片文件名(不含路径) 缩放后的尺寸 裁剪参数 隐空间版本,默认由模型 arch 决定 这组信息里没有文件内容的哈希,也没有修改时间。按这个缓存键推断,修图后用同一个文件名覆盖原图,只要尺寸不变,训练读到的仍是旧图的 latent。开了 主循环在 #9 用旧字段 gradient_accumulation_steps,更新次数只有四分之一。 #10 显存不足(OOM)会跳过当步,但步数照算。遇到 OOM(Out of Memory)时,代码清掉梯度、打印一段 “OOM during training step, skipping batch” 的提示,然后进入下一步,连续超过 3 次才终止。按代码推断,偶发的 OOM 不会让训练失败,但实际完成的更新次数会少于 每到 # jobs/process/BaseSDTrainProcess.py,save() 第 521–544 行(节选) step_num = f"_{str(step).zfill(9)}" ... lora_name = self.job.name ... filename = f'{lora_name}{step_num}.safetensors' 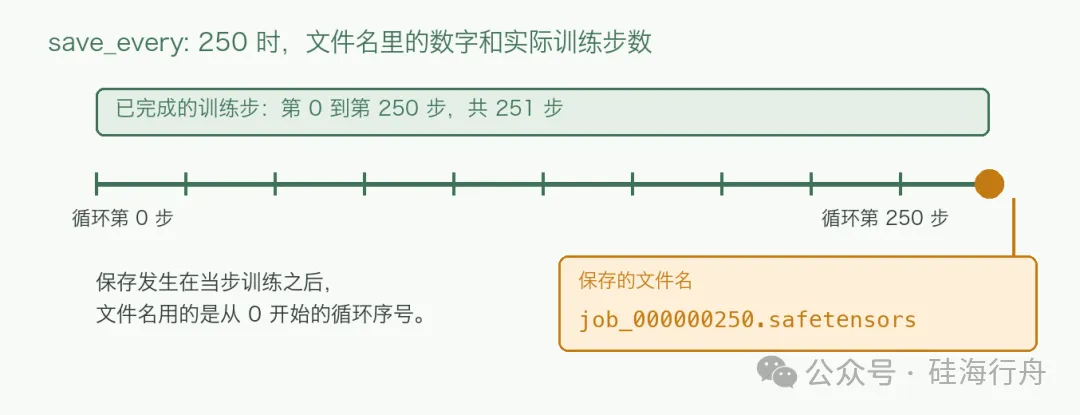
图 2|循环序号从 0 开始,保存发生在当步训练之后,所以 _000000250 这个文件已经完成了 251 步 #11 以上十一处之外,还有一个容易混淆的地方:网页 UI 新建任务时预填了一整套默认值,和直接写 YAML 时代码里的默认值不同。和本文有关的几项如下:
所以 #3 只会坑到直接写 YAML 的人;反过来,从 UI 导出的配置和手写的 YAML 即使训练参数看起来一样,底座精度、优化器也可能不同,不能直接当成同一配置比较。 把这十一处对应到开头的配置上,下面是一份把本文涉及的几项都写成显式值的版本(数值只是示例,应按自己的数据调): # 启动命令:SEED=42 python run.py config.yaml(或在 process 层写 training_seed) name: klein4b_style_v1 # 每次新实验换一个名字 network: type: lora linear: 32 # Klein 上缩放恒为 1,不写 linear_alpha train: steps: 2000 lr: 1.0e-4 # 显式写出,不用 1e-6 的默认值 gradient_accumulation: 1 # 只用这个字段,不用 gradient_accumulation_steps datasets: - folder_path: /data/target control_path: /data/source caption_ext: txt cache_latents_to_disk: true # 开了缓存,改图后要删 _latent_cache #1、#3、#4、#9 已经写进上面的配置。剩下的按时间顺序检查: 启动前 1. 键名:对照 启动前 2. 配对:用脚本核对每张目标图都有同名的 caption 和控制图,数量对不上就不要开训(#6、#7)。 启动前 3. 缓存与目录:训练图改过就删掉 结束后 4. 日志:搜一遍 OOM,确认实际更新次数(#10)。 结束后 5. 记录:按“文件名序号 + 1”记录每个检查点的实际步数(#11)。 回头看这十一处:#1 到 #4 和 #9 出在配置层,是读取宽松加上几个离常用值很远、或者在特定模型上不生效的参数造成的,把配置写全、写对就能避开;#5 到 #8、#10、#11 出在运行层,来自续训、缓存、OOM 处理和命名这些功能各自不显眼的前提,只能靠启动前后的检查发现。它们都能在代码里找到对应的位置,但没有一处会用报错拦住你。 参考资料 [1] ostris/ai-toolkit(commit 73ebae13):run.py、toolkit/job.py、toolkit/config_modules.py、toolkit/lora_special.py、toolkit/dataloader_mixins.py、toolkit/data_transfer_object/data_loader.py、jobs/process/BaseTrainProcess.py、jobs/process/BaseSDTrainProcess.py、extensions_built_in/sd_trainer/SDTrainer.py、extensions_built_in/diffusion_models/ui.tsx、ui/src/app/jobs/new/jobConfig.ts、ui/src/helpers/defaultSamples.ts [2] Fine-tune FLUX.2 [klein] with a LoRA under 60 minutes(Hugging Face Community Article,black-forest-labs,2026-06-04)
STEP 1入口:种子从哪里来
run.py。它先检查环境变量 SEED,有的话用它设置 random、numpy 和 torch 的种子:job 字段分发。训练 LoRA 走 job: extension,ExtensionJob 遍历 config.process 列表,按每一项的 type 实例化训练类并依次运行。diffusion_trainer 对应 DiffusionTrainer,它继承自 SDTrainer,后者又继承自 BaseSDTrainProcess。TrainConfig 里搜不到 seed 字段。真正起作用的有两个入口:启动时的环境变量 SEED,或者写在 process 这一层的 training_seed(与 train 平级),由 BaseTrainProcess 读取。后者只设置 torch 和 random 的种子,不设置 numpy。STEP 2配置解析:认识的键取值,其余跳过
TrainConfig、NetworkConfig、DatasetConfig、ModelConfig、SaveConfig、SampleConfig。每个字段都是 kwargs.get(键, 默认值),整个 config_modules.py 里这种调用有 453 处,没有任何“未知键”检查。lr_scheduler 写成 lr_schedular,配置照常加载,用的是默认值。STEP 3模型与网络:alpha 与续训
run() 按 model.arch 找到模型类(Klein 4B 对应 Flux2Klein4BModel),加载 transformer、文本编码器和 VAE,然后创建 LoRA 网络,挂在 sd.get_model_to_train() 返回的模块上。YAML 里的 linear 就是 rank,代码里叫 lora_dim。NetworkConfig 里 alpha 默认 1.0,linear_alpha 没写时取 alpha。但创建网络时,LoRASpecialNetwork 对 transformer 类模型会改用 PEFT(Parameter-Efficient Fine-Tuning,Hugging Face peft 库的权重格式),并把 alpha 覆盖成 rank:self.is_transformer = True,训练进程又把这个标志传给了网络类。每个 LoRA 模块的缩放是 alpha 除以 rank,alpha 已经等于 rank,所以缩放恒为 1。开头那份配置里的 linear_alpha: 16 不会带来 0.5 的缩放,也不会有任何提示。笔者的判断是,在 Klein 上想调 LoRA 的作用强度,主要靠学习率。对 SD1.5、SDXL 这类不走这个分支的模型,alpha 仍然生效;network.type 写成 locon 或 lycoris 时会改用另一个网络类,本文没有核对。training_folder/任务名 目录里找以任务名开头的权重,按文件创建时间取最新的一个:steps,这次一步都不会训练,只会再存一份权重、出一次预览图。日志里有一行醒目的 IMPORTANT,但在长日志里很容易被滚过去。STEP 4数据:缺文件不报错,缓存不看内容
folder_path 列出图片,每张图再去找同名的 caption 文件和控制图(control image)。编辑类 LoRA 用 control_path 指定控制图目录,按文件主名配对。load_caption 找不到 图片名 + caption_ext 时,caption 取 default_caption,没设就是空字符串,不打印任何提示。另外,设了 trigger_word 时,caption 里没有触发词会被自动加在开头。ControlFileItemDTOMixin:batch_size 为 1(默认值)时,这个样本在训练时没有控制图输入,按代码推断,它实际上是在没有参考图的条件下学习生成目标图。batch_size 大于 1、同一批里有其他样本带控制图时,行为不同:单张控制图的情况会补一张全零的图,多张控制图的情况会直接报错。文件名差一个字母、扩展名不在支持列表里,都会触发这种情况。cache_latents_to_disk 之后,编码好的 latent(图像经 VAE 压缩后的表示)存在图片旁边的 _latent_cache 目录,文件名是“图片主名 + 一段 md5”。这段 md5 主要由下面这些信息算出(get_latent_info_dict,另有翻转、视频等条件字段):filenamescale_to_width / scale_to_heightcrop_x / crop_y / crop_width / crop_heightlatent_space_version / latent_versioncache_text_embeddings 时,文本嵌入缓存(_t_e_cache)的键里包含 caption 原文,所以改 caption 会重新编码,改图不会。STEP 5训练循环:一步是什么
BaseSDTrainProcess,按 train.steps 计数。每一步先取 gradient_accumulation 个 batch,交给 SDTrainer.hook_train_loop,依次完成抽时间步、加噪、预测、计算 loss、反传和更新。时间步怎么抽、loss 怎么加权,见本系列上一篇《扩散模型的 loss 到底在学什么》。gradient_accumulation: 4 表示每一步取 4 个 batch、更新一次,steps: 2000 就是 2000 次更新。gradient_accumulation_steps: 4 是旧写法,代码注释说它“每次累积都算一步”:按代码路径追踪,每一步只取 1 个 batch,每 4 步更新一次,同样的 steps: 2000 只有 500 次更新。两个字段同时设成非默认值会报错,只设其中一个时都不报错。steps,不翻日志就发现不了。STEP 6保存:文件名比实际步数少 1
save_every 的整数倍,循环在当步训练结束后保存一次权重。LoRA 的文件名用的是从 0 开始的循环序号:_000000250 实际训练了 251 步(影响记录)。差 1 步对结果的影响应该很小(笔者的判断),但写实验记录、按“相同步数”比较两组训练时,要按实际步数记。训练结束时还会再存一份不带步数后缀的最终权重。任务如果续训过,文件名序号和实际训练步数的关系还会再偏,需要按日志核对。入口差异:UI 和 YAML 的默认值不是一套
| 字段 | YAML 不写时(代码默认) | 网页 UI 新建任务 |
STEP 7回到开头那份 YAML
config_modules.py 核对每个键名,确认没有拼错(#2)。_latent_cache;新实验换一个 name,启动后确认日志里没有 RESUMING(#5、#8)。