ARTICLE · 1301872
端侧AI工具链原理(10):Profiling、部署CI与可复现交付:怎样把一次跑通变成长期能力
本文是端侧 AI 工具链原理第 10 篇,也是本辑收官。前九篇已经覆盖格式、图优化、分图、融合、内存、量化、Codegen 和 Runtime,最后需要把这些环节纳入持续验证。
开篇:昨天的模型很快,今天重新编译为什么慢了20%
可能是模型改动、编译器升级、Kernel 选择变化、Driver 版本、系统频率策略、设备温度或测试输入不同。没有完整版本与性能证据,团队只能反复争论“环境是否一致”。
可复现部署的目标,是让每一次结果都能回答:
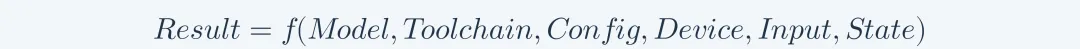
一、 Profiler 需要覆盖四个层次
Graph 层
查看原始节点、融合节点、分区和 Fallback。
Kernel 层
查看每个 Kernel 的时延、Shape、精度、Layout 和调用次数。
Timeline 层
查看 CPU、GPU、NPU、DMA、Fence 和 Queue 的并行关系。
System 层
查看内存带宽、频率、功耗、温度、CPU 占用和系统干扰。
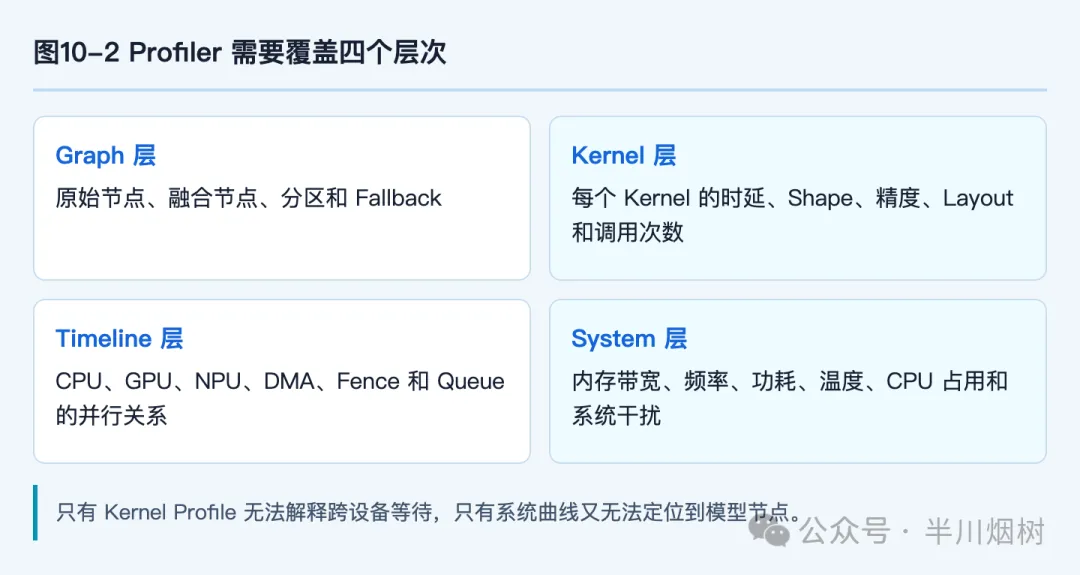
只有 Kernel Profile 无法解释跨设备等待,只有系统曲线又无法定位到模型节点。
二、先建立端到端时间账单
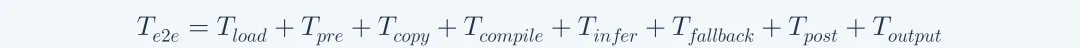
对稳态流式任务还要区分 Latency 、 Throughput 和 Jitter 。建议至少报告P50、P90、P99,并记录样本数量和预热策略。
优化时遵循“先找占比,再找原因”。一个只占1%的 Kernel 即使加速10倍,整体收益也有限。
三、性能回归必须有噪声模型
设备测试存在抖动。一次结果变慢3%,可能只是温度和后台负载。可以对多次样本计算均值、标准差和置信区间,或使用稳健的 Median 与 Percentile 。
回归阈值不应对所有模型固定为同一百分比。短任务受启动抖动影响更大,长任务受热状态影响更大。
四、部署 CI 应包含哪些阶段
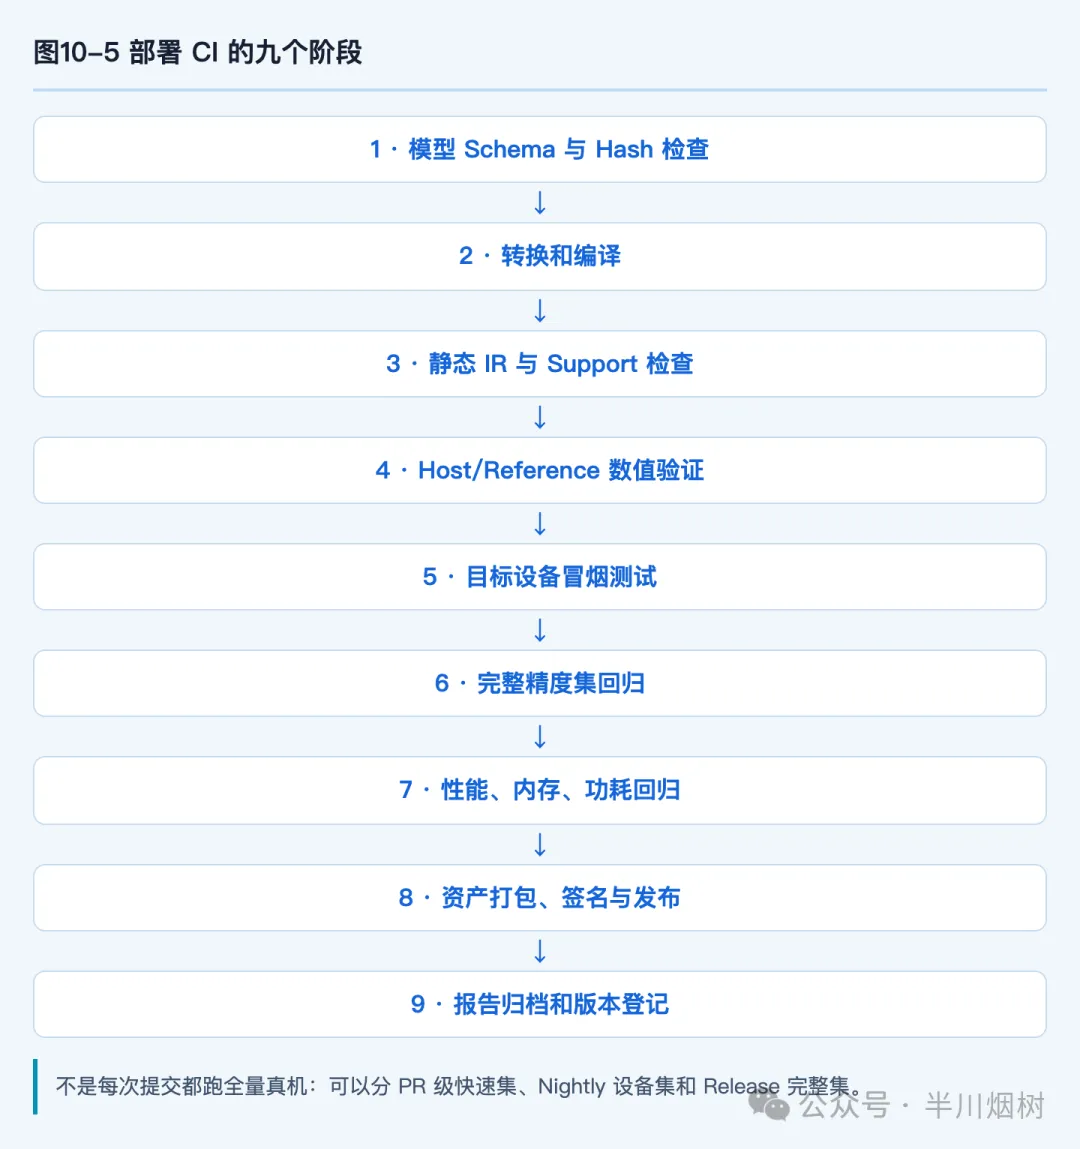
不是每次提交都跑全量真机。可以分 PR 级快速集、Nightly 设备集和 Release 完整集。
五、 Golden 数据怎样管理
Golden Input/Output 必须与模型版本绑定,并包含:
对非确定性模型,应定义统计或任务级标准,而不是强求逐元素完全相等。
六、资产版本必须可追踪
推荐为每份部署资产生成 Manifest:
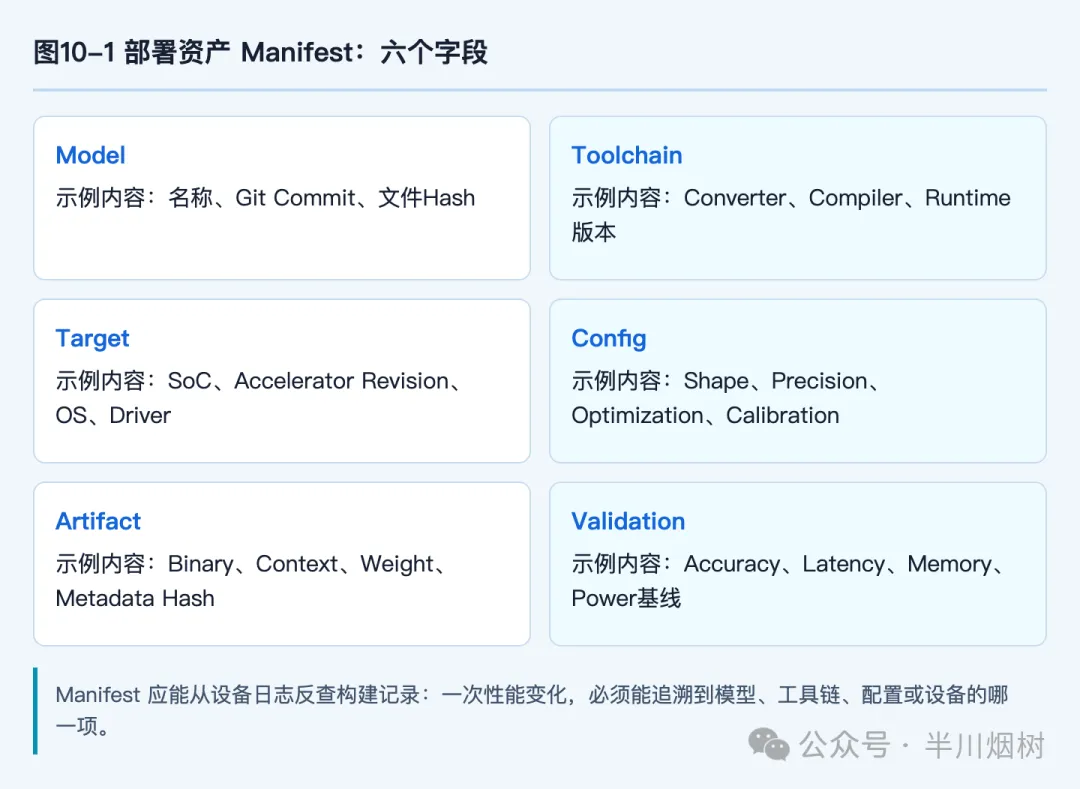
Manifest 应能从设备日志反查构建记录。
七、如何做性能 Bisect
当回归出现时,按层二分:
工具链应支持保存关键 IR、编译报告和 Profile 摘要,自动生成差异。只对比最终.binHash 无法解释变化。
八、精度和性能要同门禁
一个优化若时延降低15%,但任务指标下降超限,不能合入;反之,恢复高精度导致 Deadline 失败也不能交付。
CI 门禁可以定义为:
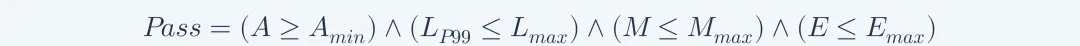
所有指标使用同一资产和同一目标配置生成。
九、真机实验必须记录系统状态
端侧芯片的持续性能受热和系统策略显著影响,冷机单次最佳值只能作为上限。
十、交付报告需要面向不同角色
同一组底层证据可以生成不同摘要,但不能形成互相矛盾的口径。
十一、一个 Compiler 升级回归案例
假设 Compiler 从v1升级到v2,分类模型 P50 从12.0 ms变为11.2 ms,但 P99 从13.5 ms升至18.0 ms。只看平均值会误判为优化成功。
自动差异报告发现:
修复可能不是撤销全部 Fusion,而是限制该 Shape 使用大 Workspace 计划。这个案例说明 CI 要同时比较 IR、内存计划和时延分布。
十二、性能噪声怎样设门禁
先在固定版本上重复运行,估计自然波动。若基线均值为mu、标准差为sigma,简单告警可使用:
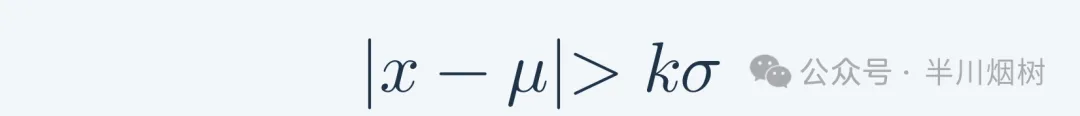
但性能分布可能非高斯,端侧还受温度漂移。更稳健的做法是比较 Median、P90/P99 和 Bootstrap 置信区间,并将 Cold、Warm、Sustained 分成独立基线。
门禁分三级:
十三、部署 CI 的设备池设计
设备池不能只有一台“黄金机”。至少包含:
每台设备定期校准、记录电池健康、系统镜像和性能基线。设备异常应从模型回归中隔离,不能把硬件老化误判为 Compiler 回归。
十四、发布包与回滚
发布包包含资产、Manifest、输入输出 Schema、兼容矩阵、性能/精度报告、已知限制和回滚版本。安装时验证 Hash、签名、Runtime Capability 与空间。
灰度阶段监控:加载失败率、 Fallback 率、P99、Crash、热事件和业务质量。出现问题时,必须能回滚模型资产而不依赖完整 App 重新发版。
十五、整辑方法怎样形成团队流程
从模型导入到 CI ,可以形成统一 Gate:
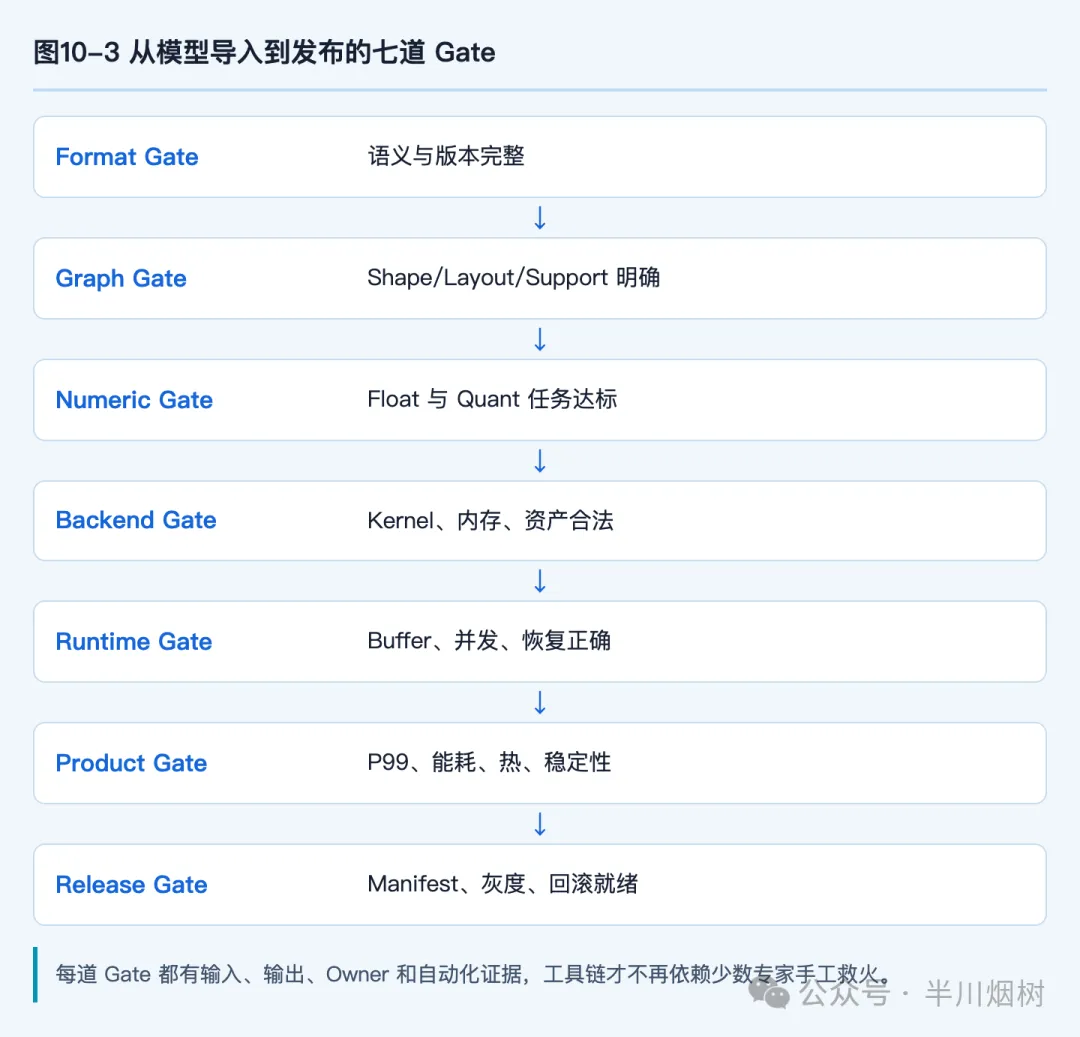
每道 Gate 都有输入、输出、Owner 和自动化证据,工具链才不再依赖少数专家手工救火。
十六、一份最小可复现交付包
建议目录按职责组织:
manifest.json引用所有文件 Hash、目标设备、版本、输入输出 Schema 和 Gate 结果。构建系统从空环境只依赖 Manifest 即可重建或验证资产。
十七、公众号案例背后的工程习惯
一篇性能文章若只给“加速3倍”,读者无法复现。专业写法应固定模型、设备、 SDK、精度、 Shape、Power Mode、预热、统计方法和任务指标,再解释变化来自 Fusion、量化、内存还是 Runtime 。
这不仅是写作规范,也是团队工程规范:所有公开数字都应能追溯到同一份部署 CI 报告。内容生产和技术交付使用同一证据源,才能避免版本演进后文章结论与产品现实脱节。
十八、多层 Profiler 怎样对齐时间
CPU Trace、Vendor Runtime、Firmware 和硬件 Counter 可能使用不同 Clock Domain。若只按“开始时间看起来接近”拼接,频率漂移和 Buffer 延迟会让事件错位。
需要同步点或时间转换关系:
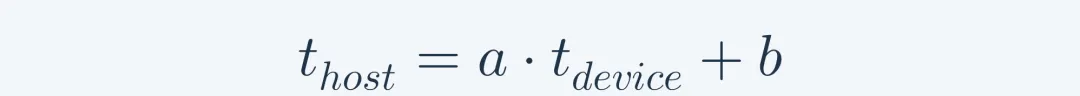
周期性采样同步事件估计a, b,并记录误差。每个请求携带 Correlation ID,从 Framework 节点一路传播到 Command 和 Counter。
Profiler 自身也有开销。详细 Layer Trace 可能改变调度和 Cache,发布数据应说明 Profile Level,并用低开销模式验证整体时延。
十九、基线数据库怎样组织
基线不是一个 CSV 平均值,而是多维记录:
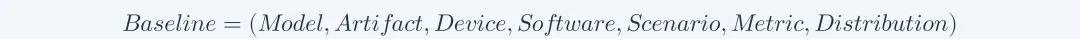
同一模型在不同 Shape、精度、Power Mode 和热状态下建立独立基线。数据库保存样本分布、环境、报告链接和有效期。
查询回归时先寻找完全匹配条件;只有明确规则才允许使用相近设备代理。代理结果必须标注,不直接用于 Release Gate。
二十、 CI 资源有限时怎样分层
PR 级
运行 Parser、Pass 单测、小模型数值、静态 Support 和 Host Simulator,目标是分钟级反馈。
Nightly 级
运行代表模型的真机精度、性能、内存和多设备兼容,目标是发现跨模块回归。
Release 级
运行完整任务集、P99、功耗、热稳态、并发、异常和长时间稳定性,并生成签字报告。
持续监控
灰度发布后收集加载失败、Fallback、Crash、Latency 和热事件,验证实验室基线是否覆盖真实分布。
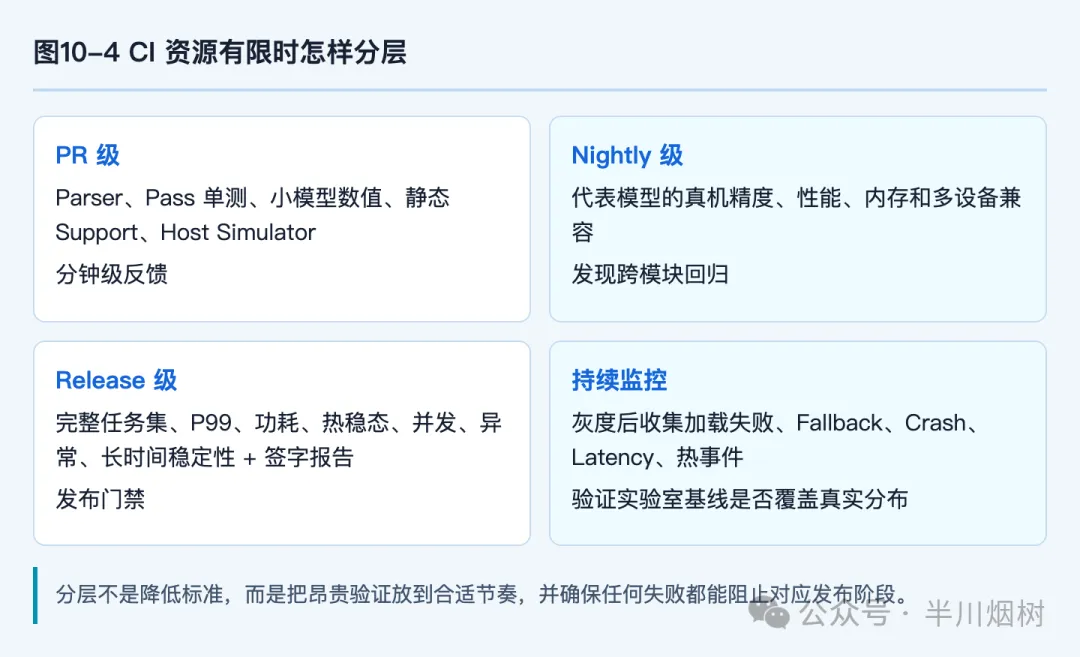
分层不是降低标准,而是把昂贵验证放到合适节奏,并确保任何失败都能阻止对应发布阶段。
二十一、怎样判断回归来自模型还是环境
设置 Control Artifact:固定模型和 Compiler 资产,定期在同一设备运行。如果 Control 也变慢,优先检查系统镜像、温度、设备健康和测试框架;如果 Control 稳定而新资产变慢,再进入 Compiler Bisect 。
同样设置 Control Device 和多设备交叉测试,可区分单机异常。实验设计中的对照组,比事后争论“是不是环境抖动”有效得多。
二十二、精度回归不应只看总指标
总 Top-1 下降0.1%可能在容差内,但某安全关键类别下降8%不可接受。 CI 应按场景、类别、长度、亮度和设备分桶,并保留 Worst-k 样本。
LLM 与生成模型还需固定 Prompt、Seed、Tokenizer 和采样参数;对非确定输出使用任务评分与统计区间,不能要求逐 Token 完全一致,也不能只做肉眼抽查。
二十三、发布后的可观测性与隐私
量产 Telemetry 只收集定位所需最小信息:资产版本、设备 Capability 、错误码、匿名性能桶和 Fallback 原因。原始图像、语音和 Prompt 默认不上传。
任何数据采集都要有隐私、授权、保留期限和访问控制。工程可观测性不能成为绕过用户数据治理的理由。
二十四、一个完整性能回归怎样闭环
假设 Compiler 从版本C_1升级到C_2后,超分模型平均时延由24.1 ms变为24.8 ms,看起来只回归2.9%;但 P99 由27.3 ms升到34.6 ms,已经越过33 ms实时预算。完整闭环不能止于“回滚 Compiler”,而要逐层缩小变化来源。
第一步固定输入、模型资产、设备、系统镜像、Power Mode 和温度区间,重复运行 Control Artifact。 Control 稳定,说明环境不是主因。第二步比较 Manifest ,确认模型、量化 Encoding 和 Runtime 版本未变,变化仅来自 Compiler 。第三步比较图分区和 IR ,发现C_2把原有 Conv-Activation 融合拆开,并新增一次 Layout Convert 。
第四步展开时间账单:新增转换平均只占0.4 ms,不足以解释 P99 ; Timeline 却显示转换产生的临时 Buffer 抬高峰值内存,在并发预览任务下触发 Arena 扩容,尾延迟因此增加。第五步用单模型、双模型和内存压力三组实验验证这一假设,并通过 Buffer Plan 确认扩容事件与慢样本一一对应。
根因修复不是简单恢复旧 Pattern ,而是在 Legality 和 Cost Model 中加入 Layout 转换及并发内存代价,同时为 Planner 增加稳定 Arena 预留。修复版本C_3需要重新通过:
最终交付物应包含 Failure ID、最小复现资产、环境 Manifest、前后 IR、Timeline、根因说明、修复 Commit、风险范围和回滚条件。这样一次回归才会沉淀为长期能力:以后同类错误由自动门禁发现,而不是再次依赖某位工程师凭经验识别。
这个案例也说明,平均值、单层耗时和单模块 Bisect 都不够。端侧性能是 Compiler 决策、内存计划、Runtime 并发和系统状态共同作用的结果。 Profiler 负责建立跨层证据,CI 负责把证据变成稳定规则,可复现交付则保证任何人都能在相同条件下验证结论。
工程检查清单
结尾:工具链成熟度体现在变化可解释
一个模型偶尔跑通不难,难的是模型、Compiler、Runtime 和设备持续迭代时,每一次结果变化都有证据、能定位、可回滚。
至此,端侧 AI 工具链原理完成了从模型图到可执行资产,再到量产验证的完整链路。下一辑将进入 Qualcomm 平台,把这些共性方法映射到 AI Hub、QAIRT/QNN、Hexagon、VTCM和Android部署实践中。
参考资料
参考链接
[1] MLIR Pass Management: https://mlir.llvm.org/docs/PassManagement/
[2] ONNX Runtime Profiling: https://onnxruntime.ai/docs/performance/tune-performance/profiling-tools.html
[3] MLPerf Inference: https://mlcommons.org/benchmarks/inference-datacenter/
--------------------------------
我是半川
一个偏爱在芯片底层与光影算法里死磕细节的工程师