ARTICLE · 1302100
技术调研3天写文档2天,Agent 压到 1 天和 0.5 天
技术调研3天写文档2天,Agent 压到 1 天和 0.5 天
(下面这个对账场景是按多个团队的常见做法还原的典型场景,不是某个项目的真实记录。)
一个 RD 接到需求:「给支付系统加一个对账功能。」他心里的判断是——对账嘛,两边数据拉出来比一下。于是直接开写设计文档。
写到一半,五件事同时冒出来:支付通道有 3 个,账单格式各不相同;通道账单 T+1 才出,业务要求 T+0 对账;差异处理需要一条人工介入流程;历史数据 2000 万条,全量比对性能不够;公司里其实已经有一个对账引擎,但没人说得清能不能复用。
于是停下来重新调研、改设计,改完再发现新问题。三天变一周,一周变两周。
技术调研在整个研发周期里是时间最长、不确定性最高的一段:调研 3 天、写文档 2 天,加起来比编码还久。它也是最容易被跳过的一段——跳过的代价不会当场出现,会在提测和上线后一起爆出来。
1. 这个环节为什么天生适合 Agent 来干
技术调研这件事,每个 RD 都知道重要,但几乎每个 RD 都在赶进度时简化掉。问题不在能力,在于它的四个特性恰好都是人做得最慢、机器做得最稳的部分:
- 搜索维度广
——开源方案、内部已有实现、竞品做法、技术博客、问答社区,五个方向要同时铺。 - 对比维度多
——技术复杂度、社区活跃度、使用广泛度、与现有系统的融合度,每个维度还要打分。 - 代码仓库检索难
——想知道「内部已经有什么」,靠人脑记忆和 grep 都不靠谱。 - 结论要结构化
——调研最后要落成架构图、接口定义、数据模型、风险清单,而不是一段聊天总结。
把这四件事接住,Agent 在这个阶段就是四个模块协同: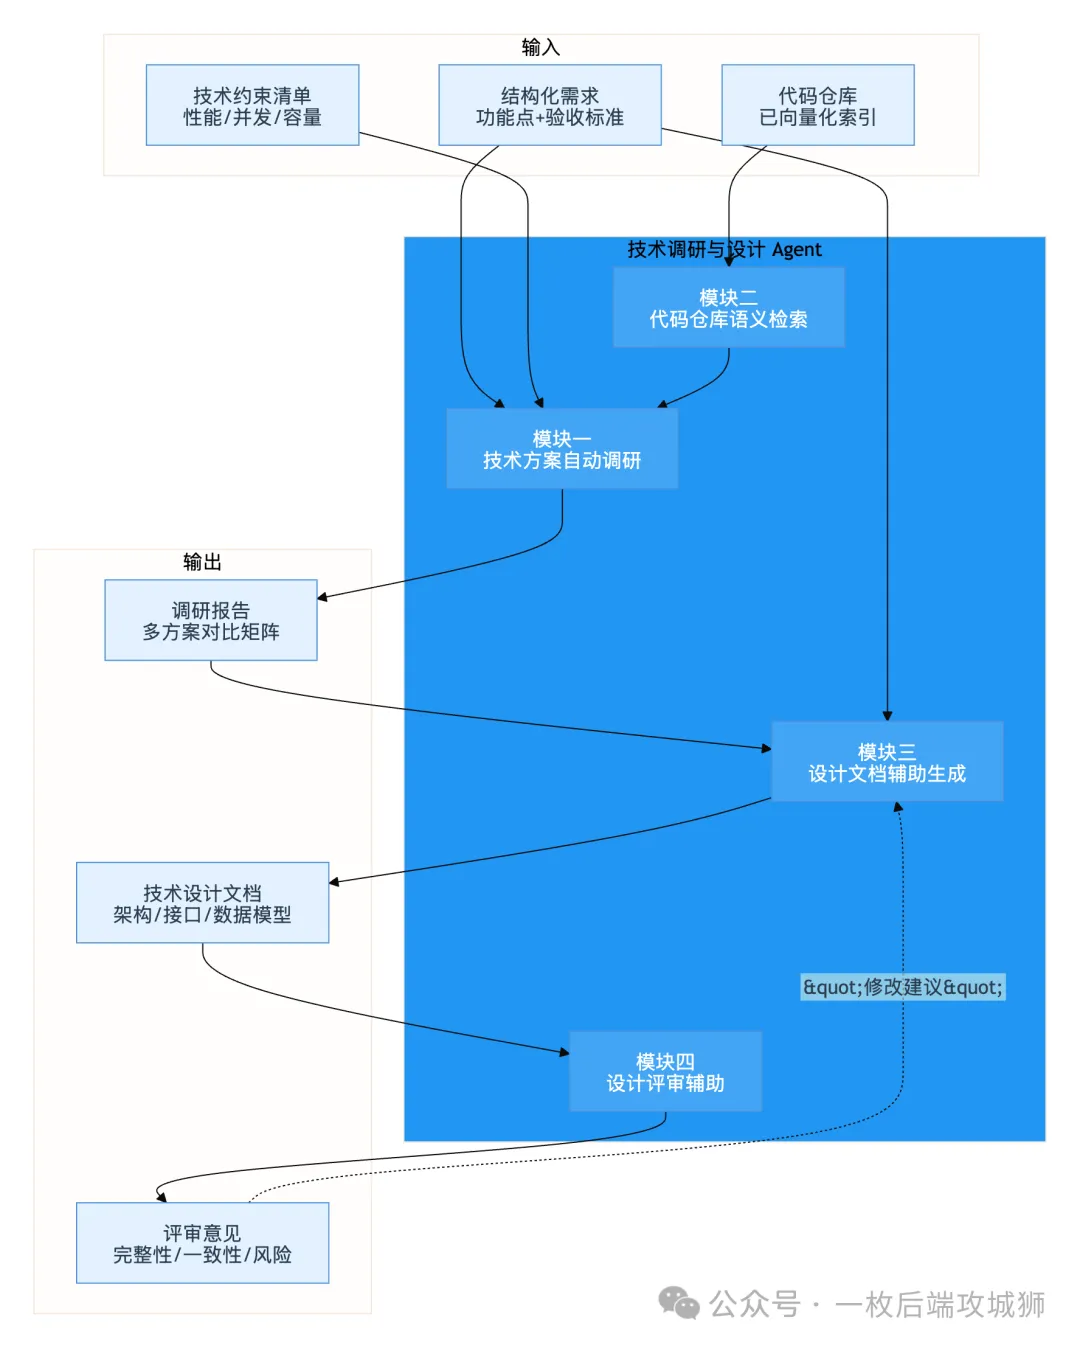
自动调研负责快速收集候选方案,代码检索负责发现内部已有能力,文档生成把调研结论转成结构化设计,评审辅助检查文档完整性和风险。
一条边界要放在最前面说清楚:Agent 不替 RD 做选型决策。 它产出对比矩阵和推荐理由,RD 拍板。技术选型从来不只是技术问题,还掺着团队偏好、历史技术债、运维承接能力——这三样 Agent 拿不到全。
2. 四维对比矩阵:融合度为什么独占 50% 权重
候选方案收上来之后,对比不能靠感觉。四个维度和权重是固定的:
| 0.50 | |||
社区活跃度这一维是纯规则打分,不交给模型——LLM 打分普遍中庸,能给到 6 分绝不给 8 分:
from enum import EnumclassSourceType(Enum): OPEN_SOURCE = "open_source" INTERNAL = "internal" COMPETITOR = "competitor" TECH_BLOG = "tech_blog"classMaturityLevel(Enum): PRODUCTION = "production" BETA = "beta" EXPERIMENTAL = "experimental"defscore_community(stars, last_update_recent_months, source_type):"""社区活跃度:0-10,规则打分不用模型"""if source_type == SourceType.INTERNAL:return5.0# 内部方案这一维中性,不给高也不给低 score = 0.0if stars: # Star 数分档if stars > 10000: score += 4.0elif stars > 1000: score += 3.0elif stars > 100: score += 2.0else: score += 1.0if last_update_recent_months isnotNone: # 距上次更新的月数if last_update_recent_months <= 3: score += 3.0elif last_update_recent_months <= 6: score += 2.0elif last_update_recent_months <= 12: score += 1.0if source_type == SourceType.OPEN_SOURCE: score += 3.0# 开源本身有社区兜底returnmin(score, 10.0)技术复杂度、使用广泛度、项目融合度这三项要读代码仓库和方案描述,才交给模型打分,且要求只返回一个数字,解析失败就退回 5.0——退回中位值比让模型自由发挥安全。
风险不是「列出来给人看」,是硬阈值触发:
# SourceType / MaturityLevel 见上一节代码defidentify_risks(solutions, scores, maturity): risks = []for s in solutions: d = scores[s.name]if d["项目融合度"] < 5.0: risks.append(f"{s.name}:与当前项目融合度低({d['项目融合度']}分),集成成本高")if d["社区活跃度"] < 3.0: risks.append(f"{s.name}:社区活跃度低({d['社区活跃度']}分),存在维护风险")if maturity[s.name] == MaturityLevel.EXPERIMENTAL: risks.append(f"{s.name}:处于实验阶段,不建议生产环境使用")return risks融合度低于 5 分、活跃度低于 3 分、成熟度是 experimental——这三条线画死,比让 Agent 写一段「需要注意 xxx」的散文有用得多。
3. 四个来源,四种收法
调研引擎不是「搜一下再总结」,是四路并行收集,每路的过滤规则完全不同:
import reclassOpenSourceCollector:"""开源方案:GitHub + 从博客里反查项目""" MIN_STARS = 100 ACTIVE_MONTHS = 6defcollect(self, strategy, search): all_solutions = []for keyword in strategy["search_keywords"]: github_results = search.search_github(keyword, sort="stars", min_stars=self.MIN_STARS) all_solutions.extend(github_results) blogs = search.search_web(f"{keyword} best practices comparison")for project inself._mentioned_projects(blogs):if project notin [r["name"] for r in all_solutions]: detail = search.get_github_detail(project)if detail: all_solutions.append(detail)return [s for s in all_solutionsif s.get("stars", 0) > self.MIN_STARSandself._months_since(s["last_update"]) <= self.ACTIVE_MONTHS]def_mentioned_projects(self, blogs): projects = set()for b in blogs: projects.update(re.findall(r"github\.com/[\w-]+/[\w-]+", b.get("content", "")))return projects @staticmethoddef_months_since(iso_date):from datetime import datetimereturn (datetime.now() - datetime.fromisoformat(iso_date)).days / 30四路的差别在于「信任度」和「成本」:
内部方案这一路的缺点不是模型写的,是规则查出来的——deprecated 标记、测试覆盖率低于 50%、没有 owner,三条各挂一句:
defidentify_internal_cons(hit): cons = []if hit.get("deprecated"): cons.append("模块已标记为废弃")if hit.get("test_coverage", 0) < 0.5: cons.append("测试覆盖率不足50%")ifnot hit.get("maintainer"): cons.append("无人维护")return cons还是那个对账需求,跑完四路 + 四维打分,Agent 给出的矩阵长这样:
| 8.15 | |||||
| 7.55 | |||||
| 6.35 | |||||
| 5.65 |
推荐是「内部对账引擎复用 + 扩展」,理由三条:融合度 9.5 分最高、复用现有调度框架和存储层只需扩展通道适配器、已在支付核心跑过生产。
但注意风险提示第一条:需确认现有引擎是否支持 T+0 增量对账,当前可能只支持 T+1 全量。 推荐方案的分最高,不等于它能直接干活——这一句才是这次调研真正的产出。
4. 代码语义检索:补掉「内部已经有什么」这个盲区
RD 做调研最容易漏的一步,就是「内部已经有什么了」。三个现象几乎每个团队都有:新人不知道老代码里有什么能复用、不同团队重复造轮子、老系统里有可用模块但没人知道。
这一步靠 grep 解决不了——你搜「对账」搜不到叫 ReconTaskHandler 的类。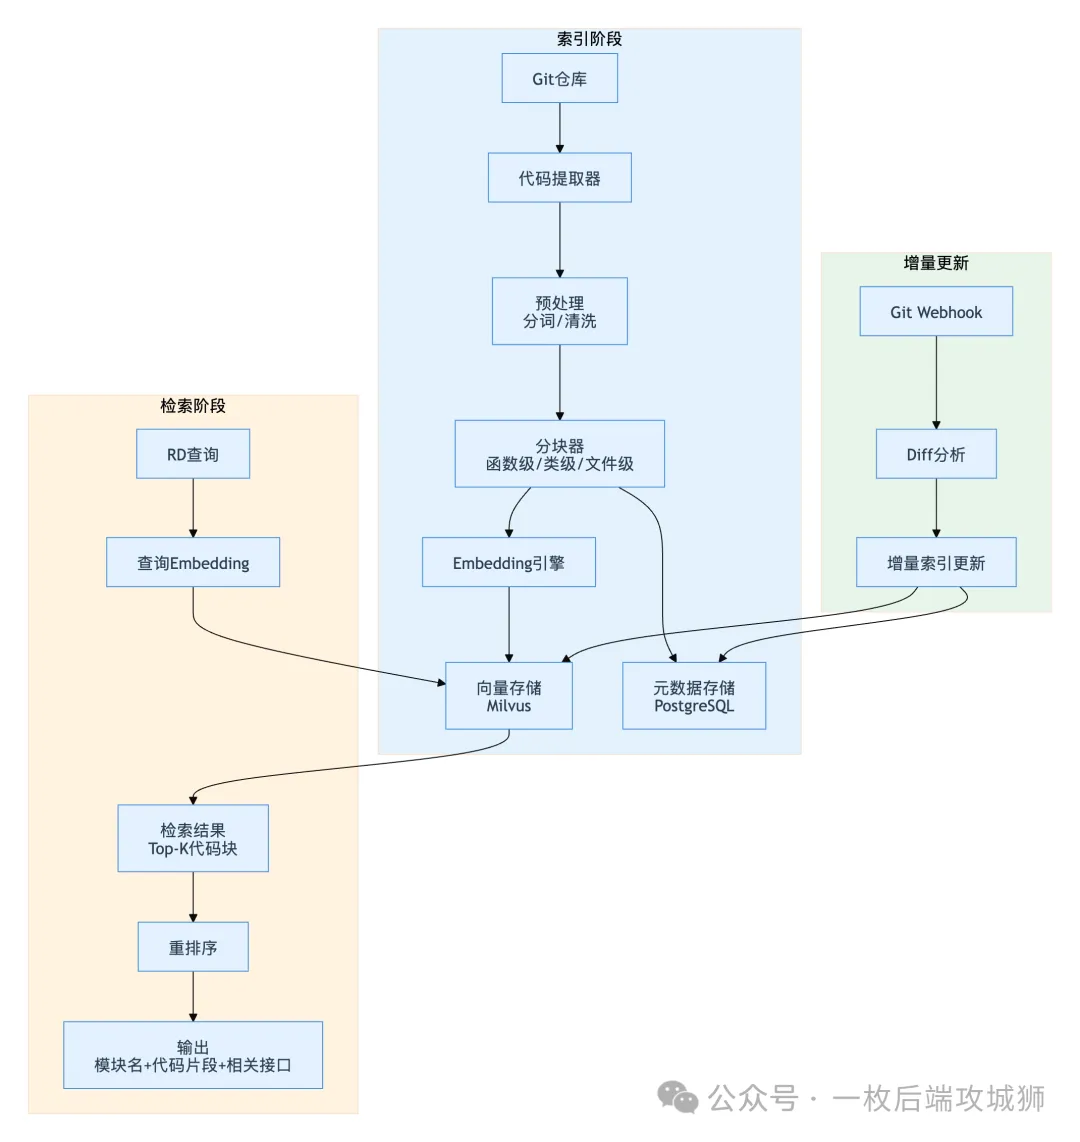
索引质量的分水岭在分块粒度。一个 chunk 不是一个字符串,它要带上足够多的元信息,检索结果才可能被后续判断复用:
from dataclasses import dataclassfrom typing importOptional@dataclassclassCodeChunk: chunk_id: str repo_name: str file_path: str language: str chunk_type: str# function / class / file / block name: str content: str start_line: int end_line: int imports: list[str] # 依赖了哪些包,判断技术栈一致性 docstring: Optional[str] # 有注释的块,检索加权更高 called_by: list[str] # 谁在调它,判断影响面 calls: list[str] # 它调了谁,判断依赖风险Java 用正则提类和方法签名、配大括号配对定边界;Python 直接走 ast,函数和类各成一个 chunk;Go/TS 只匹配 func 和 class 定义,是简化版。切完之后每个 chunk 还要补一条文件级摘要,否则「这个文件整体在干什么」这类问题永远检索不到。
查询侧是五步,不是一步向量搜索:
classCodeSearchEngine:"""查询扩展 → 多路召回 → 去重 → 重排 → 上下文增强"""def__init__(self, vector_store, metadata_store, llm_client):self.vector = vector_storeself.metadata = metadata_storeself.llm = llm_clientdefsearch(self, query, top_k=10, filter_language=None, filter_repo=None): expanded = self._expand_query(query) # 1 hits = []for eq in expanded: # 2 hits.extend(self.vector.search( query_text=eq, top_k=top_k, filters=self._build_filters(filter_language, filter_repo))) merged = self._merge_results(hits) # 3 reranked = self._rerank(merged) # 4return [self._enhance_with_context(r) for r in reranked[:top_k]] # 5def_expand_query(self, query):import json prompt = f"将技术查询扩展为3-5个搜索角度:{query},返回JSON数组。"try:return [query] + json.loads(self.llm.chat(prompt))except json.JSONDecodeError:return [query]def_merge_results(self, hits): seen, merged = set(), []for hit in hits: cid = hit["chunk_id"]if cid notin seen: seen.add(cid) merged.append(hit)else:for m in merged:if m["chunk_id"] == cid: m["score"] = max(m["score"], hit["score"])return mergeddef_rerank(self, results):for r in results: s = r["score"]if r.get("docstring"): s += 0.05if r.get("called_by") or r.get("calls"): s += 0.03ifself._has_test_file(r["file_path"]): s += 0.05 r["final_score"] = sreturnsorted(results, key=lambda x: x["final_score"], reverse=True)def_has_test_file(self, fp):import os base = os.path.splitext(os.path.basename(fp))[0] d = os.path.dirname(fp)returnany(os.path.exists(os.path.join(d, p)) for p in [f"{base}Test.java", f"test_{base}.py", f"{base}_test.go"])def_enhance_with_context(self, result): ctx = self.llm.chat(f"用一句话描述代码{result['name']}的作用:{result['content'][:300]}") result["context"] = ctx.strip()return resultdef_build_filters(self, lang, repo): f = {}if lang: f["language"] = langif repo: f["repo_name"] = reporeturn f重排序那三个加分项是有讲究的:有注释的、有调用关系的、有同名测试文件的块,优先级高于裸代码块。同样语义相似度 0.72,带测试文件的更可能是「能用的现成能力」,而不是一个被遗忘的半成品。
5. 索引不是建完就完:增量和验收指标
代码在变。索引不跟着变,三个月后检索出来的模块一半已经不存在了,Agent 会一脸认真地把它们推荐给你。
classIncrementalIndexer:"""Git Webhook 触发,按 commit 差异增量更新"""def__init__(self, git_client, chunker, embedder, vector_store, metadata_store):self.git = git_clientself.chunker = chunkerself.embedder = embedderself.vector = vector_storeself.metadata = metadata_storedefupdate_index(self, repo_name, from_commit, to_commit): changed = self.git.get_changed_files(repo_name, from_commit, to_commit) stats = {"added": 0, "modified": 0, "deleted": 0}for f in changed:if f["status"] == "added": stats["added"] += self._index_new(repo_name, f)elif f["status"] == "modified":self._delete_idx(repo_name, f) # 改过的先删再建,避免脏块残留 stats["modified"] += self._index_new(repo_name, f)elif f["status"] == "deleted": stats["deleted"] += self._delete_idx(repo_name, f)self.metadata.execute("UPDATE repo_index_state SET last_indexed_commit=%s WHERE repo_name=%s", [to_commit, repo_name])return statsdef_embed_text(self, chunk):"""送进 Embedding 的不是裸代码,是带结构的四段""" parts = []if chunk.docstring: parts.append(f"Doc: {chunk.docstring}") parts.append(f"Name: {chunk.name} ({chunk.chunk_type})") parts.append(f"File: {chunk.file_path}") parts.append("Code:") parts.append(chunk.content)return"\n".join(parts)# _index_new:分块 -> _embed_text -> 写 vector + metadata,返回块数# _delete_idx:按 file_path 删掉该文件的全部旧块,返回删除数两个细节别省:modified 一定要先删旧块再建新块,否则向量库里会攒下一堆同名不同版本的脏数据;_embed_text 里把 docstring、类名、文件路径拼在代码前面一起向量化,比只 embed 裸代码的召回明显更好。
索引这件事有没有做完,不看感觉,看六个指标:
P99 ≤ 500ms 这条不是性能洁癖。检索一旦比人肉 grep 慢, RD 就会退回到老习惯,前面所有投入归零。
6. 设计文档:Agent 出草案,RD 定稿
调研结论要落到设计文档。这一步 Agent 的作用是把「有格式要求、没信息含量」的部分先填掉: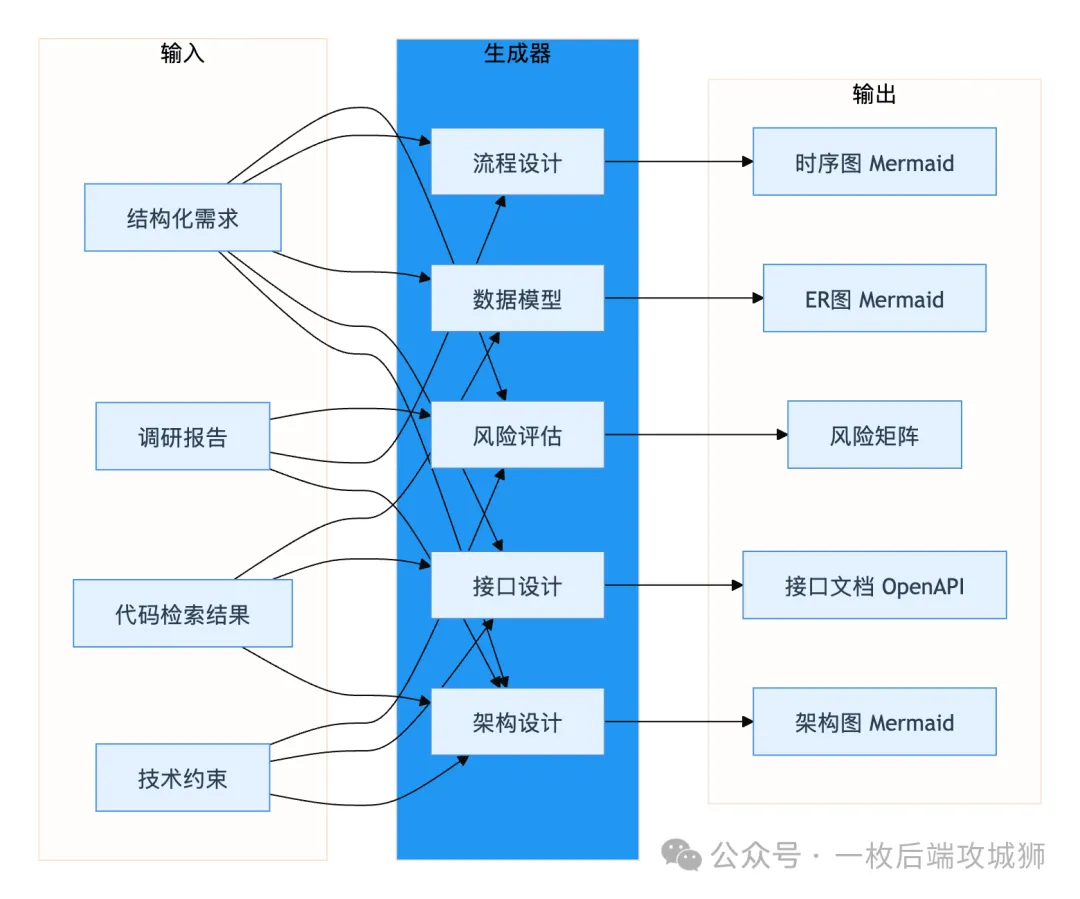
关键不在提示词,在生成前那一步——先把代码检索结果灌进上下文,否则生成的架构图会凭空发明一个「订单中心」,而你们根本没有这个服务:
classDesignDocGenerator:def__init__(self, llm_client, code_search):self.llm = llm_clientself.code_search = code_searchdefgenerate(self, requirement, research_report, constraints, selected_solution): code_ctx = self._gather_code_context(requirement) # 先检索,再生成 doc = {"architecture": self._gen_arch(requirement, research_report, selected_solution, code_ctx),"api_design": self._gen_api(requirement, constraints, code_ctx),"data_model": self._gen_model(requirement, code_ctx),"flow_design": self._gen_flow(requirement, selected_solution),"risk_assessment": self._gen_risk(requirement, constraints, research_report), }return docdef_gather_code_context(self, req): kws = []for f in req.get("functional_points", []): kws.extend(f.split()) results, seen, parts = [], set(), []for kw in kws[:5]: # 只取前 5 个功能点 results.extend(self.code_search.search(kw, top_k=3))for r in results:if r["chunk_id"] notin seen: seen.add(r["chunk_id"]) parts.append(f"### {r['name']}\n文件:{r['file_path']}\n描述:{r['context']}\n")return"\n".join(parts)def_gen_arch(self, req, report, sol, ctx):returnself.llm.chat(f"生成架构设计(含Mermaid图)。需求:{req.get('description','')}"f" 方案:{sol} 调研:{report[:1500]} 现有代码:{ctx[:1500]}")# _gen_api / _gen_model / _gen_flow / _gen_risk 与 _gen_arch 同构:# 只是换 prompt 模板和裁剪的上下文,不再重复贴对账需求跑出来的架构章节,最有价值的是这张「复用还是新增」的判定表:
排期、工作量、影响面这些结论,全靠这张表撑起来。Agent 生成草案的时间是分钟级,RD 判断这五个模块到底能不能复用,才是真正花时间的地方。
7. 让 Agent 当第一个评审者
文档写完直接拉评审会,会上一半时间在讨论「接口怎么少了两个」「这里没画异常流程」。这些不该消耗人的注意力,Agent 可以先扫一遍:
import jsonfrom dataclasses import dataclassMERMAID = "mermaid"# 三类图都以 mermaid 代码块写在对应章节里@dataclassclassReviewIssue: severity: str# critical / major / minor / suggestion category: str location: str description: str suggestion: strclassDesignReviewEngine: REQUIRED = ["background", "architecture", "api_design", "data_model","flow_design", "risk_assessment", "non_functional", "deployment"]def__init__(self, llm_client):self.llm = llm_clientdefcheck_completeness(self, doc): issues = []for attr inself.REQUIRED: c = (doc.get(attr) or"").strip()iflen(c) < 50: # 空章节或只写了一句话 issues.append(ReviewIssue("major", "完整性", attr,"内容缺失或过短", f"补充 {attr}"))if MERMAID notin doc.get("architecture", ""): issues.append(ReviewIssue("major", "完整性", "架构设计","缺少架构图", "添加 Mermaid 架构图"))if MERMAID notin doc.get("data_model", ""): issues.append(ReviewIssue("major", "完整性", "数据模型","缺少ER图", "添加 ER 图"))if MERMAID notin doc.get("flow_design", ""): issues.append(ReviewIssue("minor", "完整性", "核心流程","缺少时序图", "添加时序图"))return issuesdefcheck_consistency(self, doc): prompt = ("检查设计文档一致性,只输出 JSON 数组,无问题输出 []。\n"f"架构:{doc.get('architecture', '')[:800]}\n"f"接口:{doc.get('api_design', '')[:800]}\n"f"数据模型:{doc.get('data_model', '')[:800]}\n"f"流程:{doc.get('flow_design', '')[:800]}\n""检查:接口是否覆盖架构里的模块、数据模型是否支撑接口、""流程是否用到所有模块。每项含 severity/location/description/suggestion。")try: items = json.loads(self.llm.chat(prompt))except (json.JSONDecodeError, KeyError, TypeError):return [] # 解析失败不阻塞评审,交人工return [ReviewIssue(i["severity"], "一致性", i["location"], i["description"], i["suggestion"]) for i in items]defreview(self, doc): issues = self.check_completeness(doc) + self.check_consistency(doc) crit = sum(1for i in issues if i.severity == "critical") major = sum(1for i in issues if i.severity == "major")if crit > 0: rec = "需重写——存在关键缺陷"elif major > 2: rec = "需修改——多个主要问题"elif major > 0: rec = "需修改——存在主要问题"else: rec = "通过——可进入评审会"return issues, rec结论判定用的是计数阈值,不是模型评分:有 critical 直接打回重写,major 超过 2 个必须改完再来。这样 RD 不会跟 Agent 争论「你觉得 7 分我觉得 8 分」。
一份真实跑出来的评审报告大概是这样:
8. 三个会在落地时咬人的坑
坑一:调研结果不准。 四类原因,四类解法:
坑二:纯语义检索会漏掉精确匹配。 你搜 UserAuthServiceImpl,向量检索给你一堆「用户认证相关」的类,就是不给那一个。加一路精确匹配:
classHybridSearcher:"""语义检索 + 精确匹配,两路融合"""def__init__(self, semantic_engine, grep_engine):self.semantic = semantic_engineself.grep = grep_enginedefsearch(self, query, top_k=10): sem = self.semantic.search(query, top_k=top_k * 2) grep_res = self.grep.search(self._extract_keywords(query), top_k=top_k)returnself._fusion(sem, grep_res)[:top_k]def_extract_keywords(self, query):import re kws = [] kws.extend(re.findall(r'"([^"]+)"', query)) # 引号内容 kws.extend(re.findall(r'[A-Z][a-z]+(?:[A-Z][a-z]+)+', query)) # 驼峰 kws.extend(re.findall(r'\b(?:Service|Controller|Repository|Mapper|Config|Handler)\w*', query))return kwsdef_fusion(self, sem_results, grep_results): grep_ids = {r["chunk_id"] for r in grep_results}for r in sem_results:if r["chunk_id"] in grep_ids: r["score"] *= 1.5# 两路都命中,加权 sem_ids = {r["chunk_id"] for r in sem_results}for r in grep_results:if r["chunk_id"] notin sem_ids: sem_results.append(r) # 只有一路命中的也要兜住returnsorted(sem_results, key=lambda x: x["score"], reverse=True)坑三:文档和代码会漂移。 设计文档写着 POST /recon/submit,代码里根本没有;写了 CREATE TABLE recon_diff,实体类不存在。定稿时不检查,三个月后没人记得哪个是真的:
classDriftDetector:def__init__(self, code_search):self.code_search = code_searchdefdetect(self, doc): drifts = []import refor method, path in re.findall(r'(GET|POST|PUT|DELETE)\s+(/\S+)', doc.get("api_design", "")): results = self.code_search.search(f"{method}{path} endpoint", top_k=3)ifnot results or results[0]["score"] < 0.5: drifts.append({"type": "api_missing","detail": f"接口 {method}{path} 在代码中未找到对应实现","severity": "major"})for table in re.findall(r'CREATE TABLE\s+(\w+)', doc.get("data_model", "")): results = self.code_search.search(f"{table} entity model", top_k=3)ifnot results or results[0]["score"] < 0.4: drifts.append({"type": "model_missing","detail": f"表 {table} 在代码中未找到对应 Entity","severity": "minor"})return drifts接口阈值 0.5、表阈值 0.4,两个数不一样不是笔误:接口名带 HTTP 方法,语义信号更强;表名散落在实体、Mapper、SQL 里,命中分数天然偏低。
9. 边界、效率,以及只有一个季度时先做哪件事
先把不省时间的部分划出去。六个决策点,Agent 和 RD 的分工是固定的:
效率的部分,按环节拆开看:
| 总计 | ~6天 | ~2天 | 3x |
40 倍的那一行才是重点。 省时间最多的不是「让模型写文档」,是「把内部有什么查清楚」——这一格原本要翻 50 个文件、问 3 个老同事、耗掉大半天。文档生成看起来最炫,实际只省了 1.5 天。
如果只有一个季度,按这个顺序做三件事:
- 把代码仓库向量化 + 增量索引跑通
(第 4、5 节)。这是所有后续能力的地基,没做完就别谈调研 Agent。验收看两个数:索引覆盖率 ≥ 95%、增量延迟 ≤ 5 分钟。 - 接上四路收集和四维打分
(第 2、3 节)。先只要求它产出对比矩阵和三条硬阈值风险,别急着生成文档。 - 最后才加文档生成和评审引擎
(第 6、7 节)。顺序反了的团队,会得到一份「格式漂亮、模块凭空发明」的设计文档,评审会上被当场戳穿,然后没人再信这个工具。
上线前自己过一遍这八条:
每个候选方案都带来源链接,抽查过至少 2 条不是幻觉 内部方案这一路真的检索了代码仓库,不是只搜了文档 索引覆盖率 ≥ 95%,增量索引由 Webhook 触发且延迟 ≤ 5 分钟 融合度低于 5 分、活跃度低于 3 分的方案,风险清单里能看到 推荐方案的风险第一条,是「需要确认的能力缺口」而不是套话 生成文档前灌了代码检索上下文,架构图里没有凭空发明的服务 评审引擎用 critical/major 计数判定,不是模型打的一个总分 定稿前跑过一次文档-代码漂移检测
这三件事做完,你手上是一个能覆盖「调研 3 天写文档 2 天」的 L1 系统:Agent 把检索、打分、起草、自查全包了,选型、分库分表、风险等级这三样仍然由 RD 签字。
那么问题留给你:融合度权重给到 50%,意味着一个社区已经半死不活、但和现有系统完美契合的内部方案,会稳定排在一个很优秀但要重新学的新框架前面。你觉得这个权重该是 50%,还是应该让团队技术演进的方向感进来分一杯羹——你团队实际用的是多少?技术调研3天写文档2天,Agent 压到 1 天和 0.5 天
讨论:你们团队的技术选型是谁拍板?融合度这一维占多少权重,是写进设评模板了,还是每次靠嗓门。
关注:一枚后端攻城狮,每周两篇 Agent 工程落地拆解,结论都带能跑的代码和边界条件。
自助:第 2 节四维权重表、第 5 节六个索引验收指标、第 9 节八条上线前自查清单,可以直接抄进你们的设计评审流程。