ARTICLE · 1302822
给 AI 助手装上“第二大脑”:基于 Mem0 与 MCP 的本地轻量级记忆方案
用各类 AI 编码助手或 Agent 工具时,很多人都会遇到类似的问题:新开一个对话窗口,它就把之前的背景忘得一干二净。
你的包管理器习惯用 uv 还是 poetry、常用终端是 Fish 还是 Zsh、某个本地服务的端口/apikey是多少、或者踩坑排错后得出的特定规范……每次换个会话,往往都要重新交待一遍。
为了解决跨会话的长效记忆问题,市面上主流的选择是开源记忆引擎 Mem0。但官方推荐的路线通常有两种:要么直接买商业云服务,要么本地跑一整套庞大的 Docker Compose 集群。
前者有隐私外泄和按量计费的顾虑,后者对于日常在笔记本上做开发的个人来说又太重。
本文记录了一套更轻巧、完全运行在本地的自托管方案:纯 Python 单文件 + 嵌入式 Qdrant 向量库 + 原生 MCP 协议。不需要常驻 Docker 守护进程,本地磁盘独占存储,零成本给 AI 助手插上持久记忆能力。
1. 为什么不用容器,也不买云服务?
在搭建之前,我们对比过三种形态:
- 官方云端(Mem0 Cloud)
开箱即用,但数据上云,存在个人隐私和密钥泄露风险,且按调用量收费。 - 官方 Docker 方案
虽然数据本地化,但需要起多套容器(API 服务、Postgres、独立向量库等),系统常驻内存开销大,配置网络映射也相对繁琐。 - 本地轻量级自托管(本文方案) *
* 资源消耗低:基于单文件 Python 脚本,采用嵌入式 Qdrant(以本地 SQLite/文件形式读写),随用随拉起,不跑多余后台服务。
* 接入自然:基于 Anthropic 发起的 MCP(Model Context Protocol)标准协议,直接挂载为 AI 助手的原子工具。
2. 系统拓扑与核心选型
整套系统围绕四个关键节点组织:
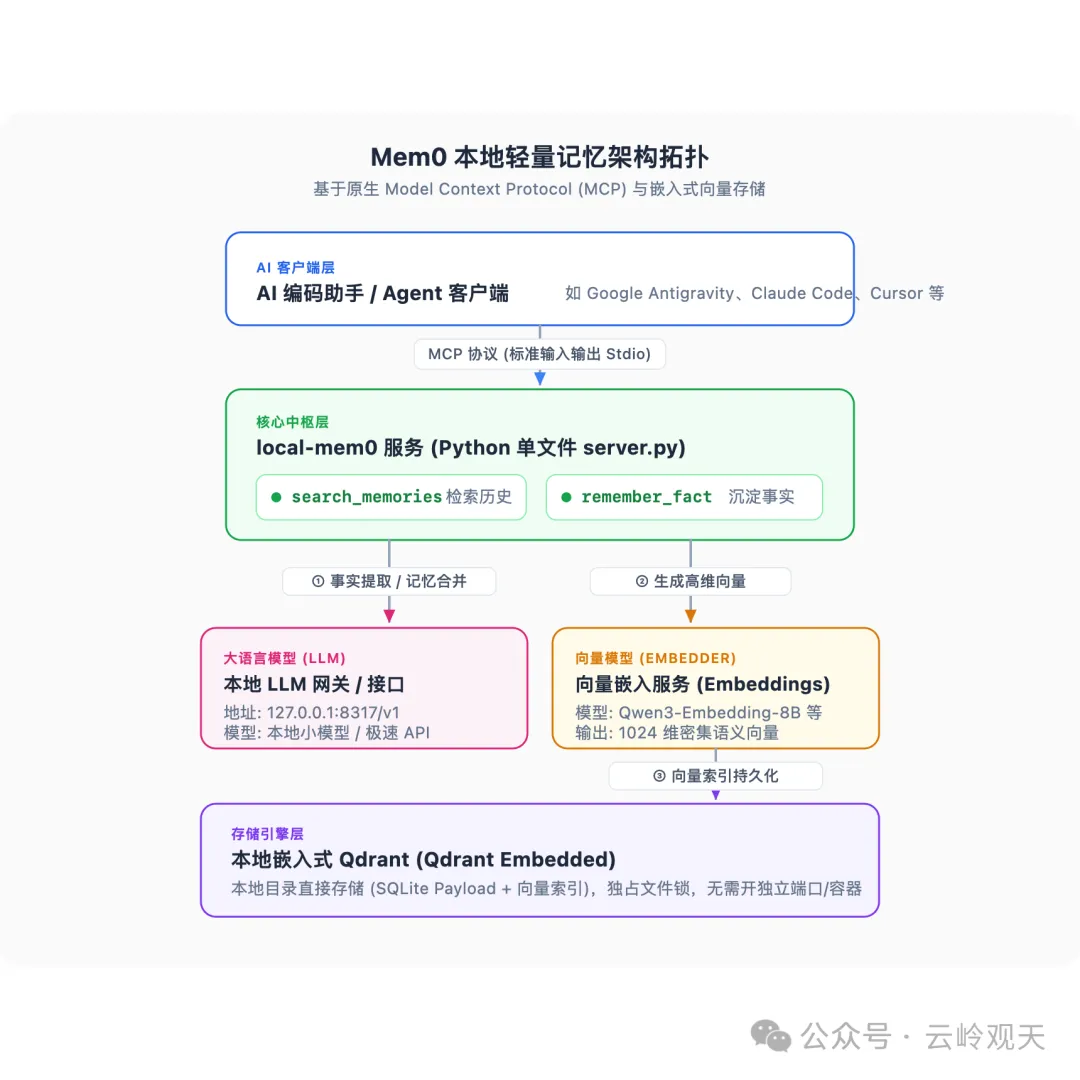
- 核心计算引擎
开源版 mem0ai。负责处理记忆流:收集语境、检索已有记忆、抽取并合并事实、计算向量与去重。 - 抽取模型(LLM)
负责从口语对话中提炼出纯粹的事实。可以对接本地部署的小参数模型或低成本 API。 - 向量嵌入(Embedder)
负责将事实文本转化为稠密语义向量,便于后续通过自然语言快速召回。 - 存储引擎
Qdrant Embedded。直接指定本地路径,以单机文件形式持久化,完全不需要额外监听 6333 端口。
3. 环境准备与完整安装流程
这套方案不需要安装 Docker,整个环境基于轻量 Python 虚拟环境即可搞定。
3.1 创建独立工作区与虚拟环境
推荐使用 uv(也可以使用 Python 自带的 venv):
# 创建并进入专属工作目录
mkdir -p ~/Documents/Memory0/qdrant
cd ~/Documents/Memory0

# 创建虚拟环境(建议 Python >= 3.10)
uv venv .venv
source .venv/bin/activate
3.2 安装核心依赖包
只需安装 mem0ai、qdrant-client 以及支持 MCP 通信的 mcp 库:
uv pip install mem0ai qdrant-client mcp
3.3 准备两组模型接口
在启动服务前,需要确认好两项服务地址(可通过本地环境变量或脚本配置):
- 实体与事实抽取 LLM
支持 OpenAI 格式的 ChatCompletion 接口(可以是本地反代网关、Ollama,或是各大平台的中小模型)。 - 文本向量化 Embedder
支持 OpenAI 格式的 Embeddings 接口(例如国内平台的 Qwen3-Embedding-8B,或者本地运行的 bge 等模型)。
4. 极简落地:几十行代码搭好 MCP 记忆服务
借助 mcp 官方库与 mem0,核心代码只需要一个 server.py:
#!/usr/bin/env python3
import os
from dataclasses import dataclass
from pathlib import Path
from mcp.server.mcpserver import MCPServer
from mem0 import Memory

# 确保本地回环地址直连,不受全局代理干扰
os.environ["NO_PROXY"] = "127.0.0.1,localhost"
os.environ["no_proxy"] = "127.0.0.1,localhost"


@dataclass
classConfig:
    storage_dir: str = str(Path.home() / "Documents/Memory0/qdrant")

# 向量嵌入配置
    embed_base_url: str = os.getenv("EMBED_BASE_URL", "https://api.example.com/v1")
    embed_api_key: str = os.getenv("EMBED_API_KEY", "your-embed-key")
    embed_model: str = "Qwen3-Embedding-8B"
    embed_dims: int = 1024

# 实体与事实抽取 LLM 配置
    llm_base_url: str = os.getenv("LLM_BASE_URL", "http://127.0.0.1:8317/v1")
    llm_api_key: str = os.getenv("LLM_API_KEY", "your-llm-key")
    llm_model: str = "your-llm-model"


cfg = Config()

memory = Memory.from_config({
"vector_store": {
"provider": "qdrant",
"config": {
"collection_name": "developer_memories",
"path": cfg.storage_dir,
"embedding_model_dims": cfg.embed_dims,
        },
    },
"llm": {
"provider": "openai",
"config": {
"model": cfg.llm_model,
"api_key": cfg.llm_api_key,
"openai_base_url": cfg.llm_base_url,
        },
    },
"embedder": {
"provider": "openai",
"config": {
"model": cfg.embed_model,
"api_key": cfg.embed_api_key,
"openai_base_url": cfg.embed_base_url,
"embedding_dims": cfg.embed_dims,
        },
    },
})

mcp = MCPServer("local-mem0")


@mcp.tool()
defsearch_memories(query: str, top_k: int = 5) -> str:
"""按问题检索历史记忆、偏好及环境配置"""
    results = memory.search(query, limit=top_k)
    items = [r["memory"] for r in results.get("results", [])]
return"\n".join(items) if items else"未找到相关记忆。"


@mcp.tool()
defremember_fact(text: str) -> str:
"""将一条明确的事实、配置或偏好存入本地记忆库"""
    memory.add(text)
return"已保存至本地向量库。"


if __name__ == "__main__":
    mcp.run()
客户端接入
以支持 MCP 的客户端为例,只需在配置文件的 mcpServers 节点登记该脚本:
{
"mcpServers":{
    "local-mem0":{
        "command":"/Users/xxxx/Documents/Memory0/.venv/bin/python",
        "args":["/Users/xxxx/Documents/Memory0/server.py"],
        "env":{
            "NO_PROXY":"127.0.0.1,localhost",
            "PYTHONUNBUFFERED":"1"
        }
    }
}
}
5. 踩坑与工程权衡
实际落地过程中,有三个细节直接决定了系统能否稳定工作:
1. 本地代理拦截问题
许多开发者的机器上会常驻系统级或客户端网络代理。如果模型或向量接口配置的是本地回环地址(如 127.0.0.1:8317),网络请求很容易被误路由至外部代理,报 502 Bad Gateway。
在脚本头部强制注入 NO_PROXY=127.0.0.1,localhost,确保本地网关请求始终走直连。
2. 独占锁冲突与单一职责
嵌入式 Qdrant 不需要起后台数据库进程,但会在目标存储目录创建独占文件锁。
如果 MCP 服务已经在运行,此时若在终端手动执行其他测试脚本试图直接读写该目录,会立即报错崩溃。
设计原则:所有记忆读取与存储必须收敛为 MCP 协议调用,不通过外围脚本直接抢占本地文件库。
3. 工具(Tools)与提示词(Prompts)的边界
在定义 MCP 服务时,如果试图将记忆存取做成带参数的 Prompts(斜杠命令),某些客户端前端的自动补全模块在遇到必填形参时可能出现解析异常,甚至影响已有命令的列表展示。
最稳健的做法是将记忆服务完全实现为原子 Tool,把触发判断交给 Agent 自身的思考链,前端体验更平滑。
6. 效果与日常维护
系统接入后,日常使用非常自然:
聊到新项目、配置规范时,一句话“记一下,以后遇到类似项目默认用方案 B”,Agent 就会自动调取 remember_fact工具入库。下次开新会话问及环境搭建,Agent 在规划初期便会主动执行 search_memories,自动按你的习惯展开回答。
备份也非常简单:由于没有分散的数据库集群,所有数据都在指定的 qdrant 文件夹里,定期做个打包压缩就能完成整库冷备:
tar -czf ~/Documents/Memory0_backup_$(date +%Y%m%d).tar.gz -C ~/Documents/Memory0 qdrant
如果后续需要多台设备或多进程并发共享,也只需要将 Qdrant 配置切换为独立服务地址,无缝平滑迁移。