ARTICLE · 1306198
无显卡8G内存也能跑,AI台账助手本地大模型提速,AMD 7840HS迷你主机性能实测,附软件下载地址
昨天我写的公众号文章《AI 替你填网页表单》,文末留了两个预告:一是让村民查到之后还能补充修改,二是接入 MCP 扩展,以后加新功能不用改代码重新编译。
今天我把这两个功能都完成了,考虑到不少人的电脑内存不太大,性能不太行,所以我顺带还把本机大模型做了一次瘦身——从 12B 换成 4B,在质量没有下降的前提下,尽量让8G内存电脑也能跑。
今天我们用amd7840hs迷你主机,把修改过程和实测数据记录下来,分享给大家参考,如有问题后面留言。文后有新版网盘链接。
01 · 表单工具:查询页从「只能看」到「能补能改」
查询页原来只能看。现在管理员可以按列开放「可改」权限——比如三类人员的外出务工补贴,开放补贴金额和证明材料这两列,村民查到自家记录后点「修改」,直接补充上传,不用再跑村委会。
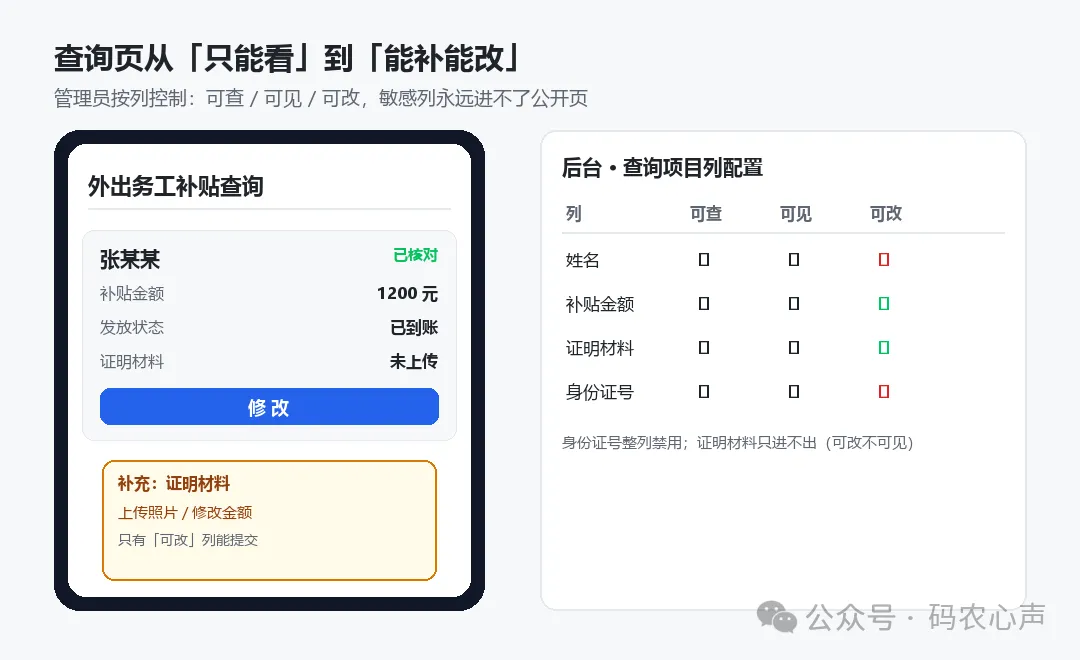
村民端修改弹窗与后台列配置(示例数据)
⚡ 权限粒度是「列」
每一列独立配「可查 / 可见 / 可改」三个开关。可以做到「证明材料能上传但平时不显示」这种组合;身份证号这类敏感列整列禁用,想改都改不了。
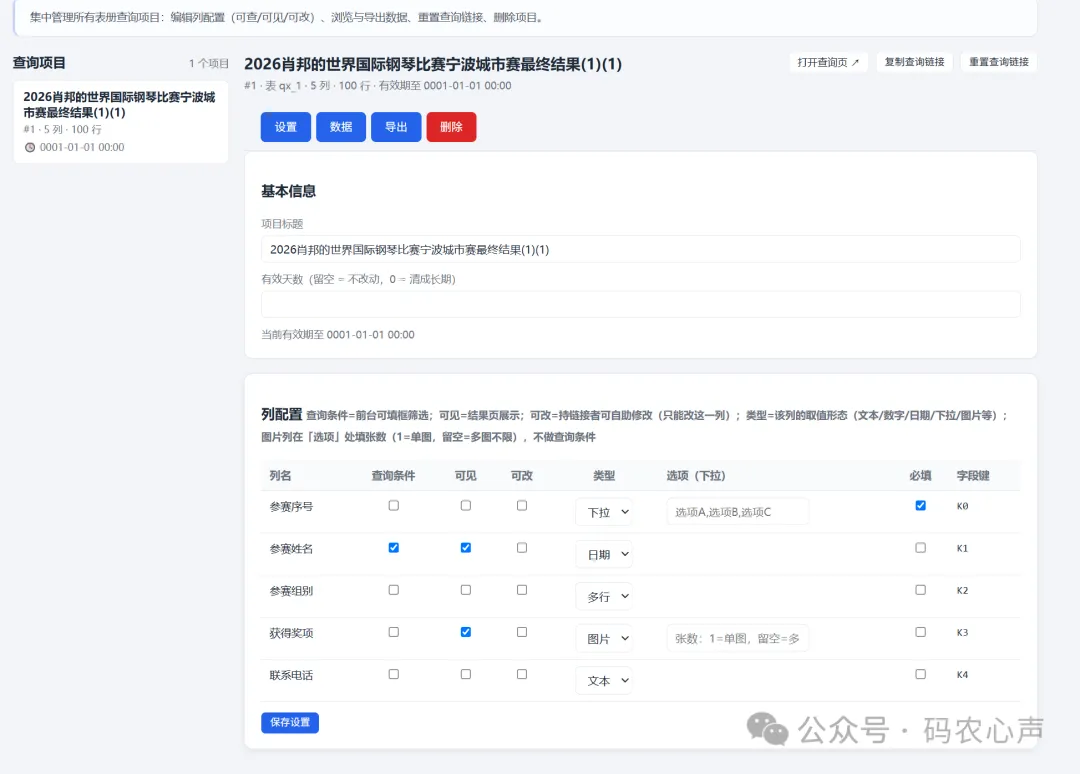
所有查询项目集中在后台「查询项目」页管理:改列配置、浏览导出数据、重置链接、下线项目,都是即时生效。
02 · MCP 工具:加新功能,改个 JSON 就行
这是上篇预告的重头。MCP(Model Context Protocol)是一套标准协议,让 AI 助手按统一方式调用外部工具服务。接上之后,想给 AI 助手加新能力,不再需要改代码、重新编译——写一段 mcp.json 配置、保存,立即生效:
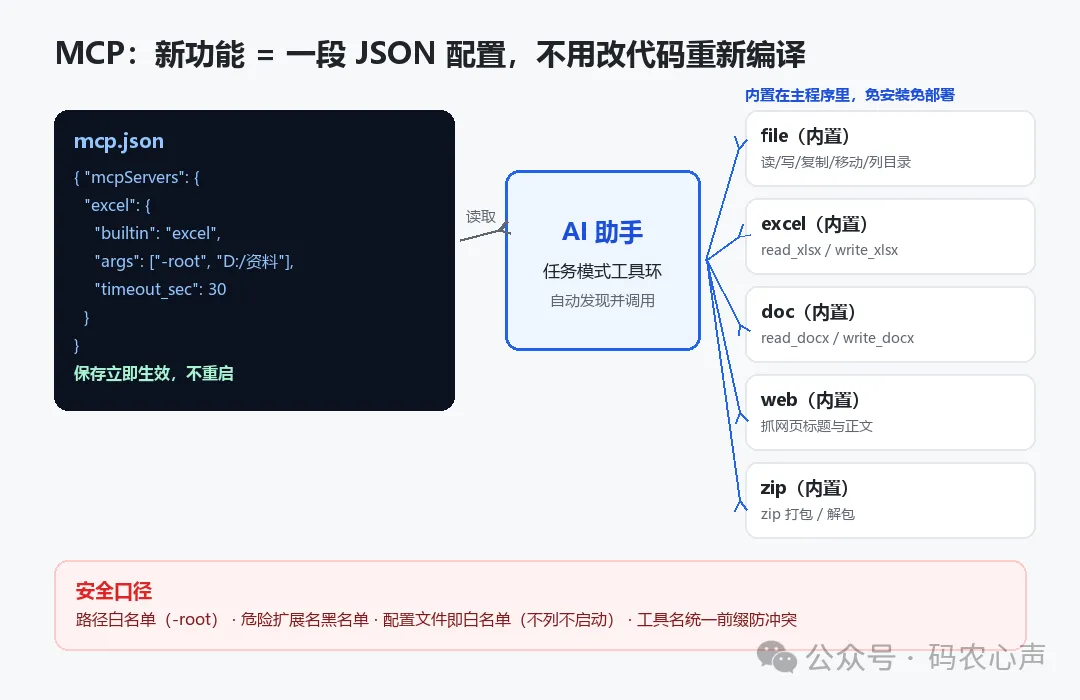
AI 助手通过 mcp.json 按需拉起工具服务(stdio JSON-RPC)
这 5 个常用工具服务直接内置在主程序里(一个 exe 就是全部,部署时不用额外带一堆文件),配置里写 builtin 就能用:
除了这五个,任何标准的 MCP 服务端也都能接(配置里写 command 指向外部程序即可)——以后要做「对比两个表格差异」「写日历短信」「OCR」之类的新功能,写个独立小服务、在 mcp.json 里登记一行就上线了。
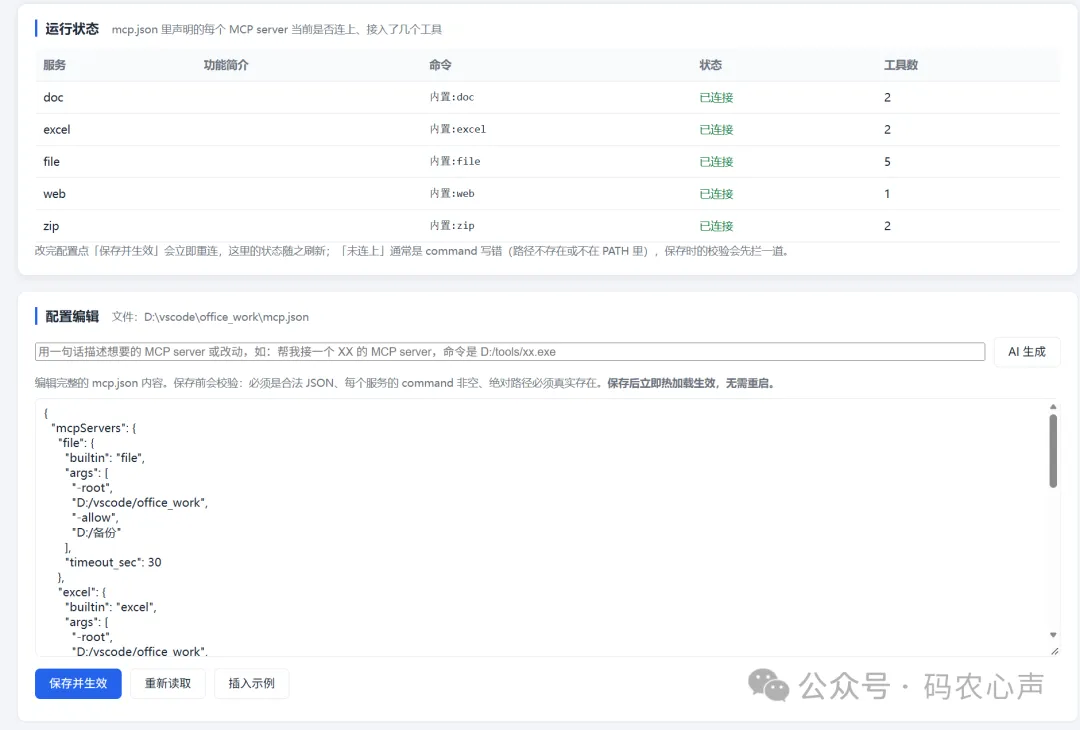
安全是默认收紧的:工具只能访问白名单目录(-root 指定);危险扩展名有黑名单;配置文件本身就是白名单——不登记的服务一个进程都不会启动;接入的工具统一加前缀改名,跟 AI 助手的内置工具永不冲突。
管理入口在后台「MCP 工具」页:增删改服务配置、保存立即生效不用重启;不会写配置也没关系,页面里可以让 AI 帮你生成。
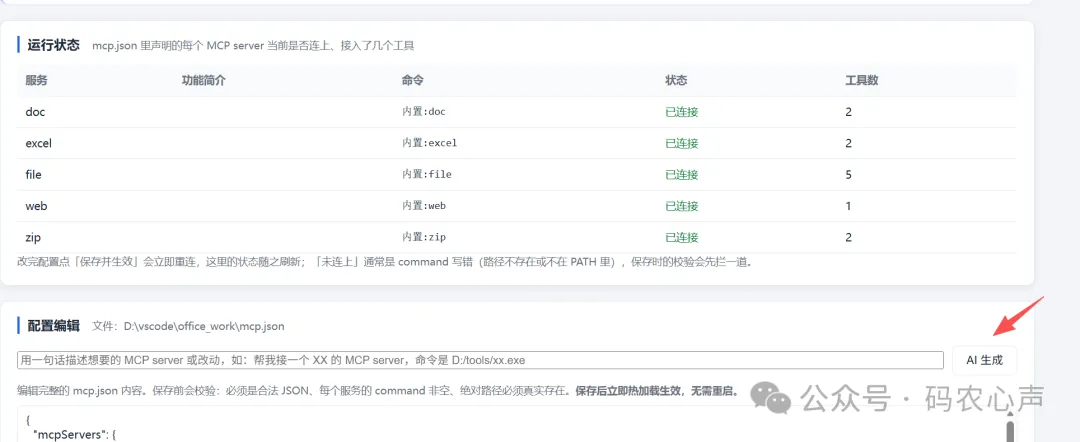
demo的json代码如下:
{"mcpServers": {"file": {"builtin": "file","args": ["-root","D:/vscode/office_work","-allow","D:/备份"],"timeout_sec": 30},"excel": {"builtin": "excel","args": ["-root","D:/vscode/office_work"],"timeout_sec": 30}}}
03 · 本地大模型「瘦身」:12B → 4B,16 项基准逐用例看
系统一直跑在本机 ollama 上(AMD 780M 核显 + 32GB 内存),主模型原来是 gemma4:12b。我们自建了一套基准(accbench):16 个真实业务用例覆盖资料抽取、知识库问答、任务决策三大类,每例跑 3 轮取多数投票,评分全程确定性规则、不引入裁判模型,财务数字专项校验小数与千分位。拿它把 12b 和更小的 gemma4:e4b(有效 4B 参数)做了一次全面对比。
整体结论:
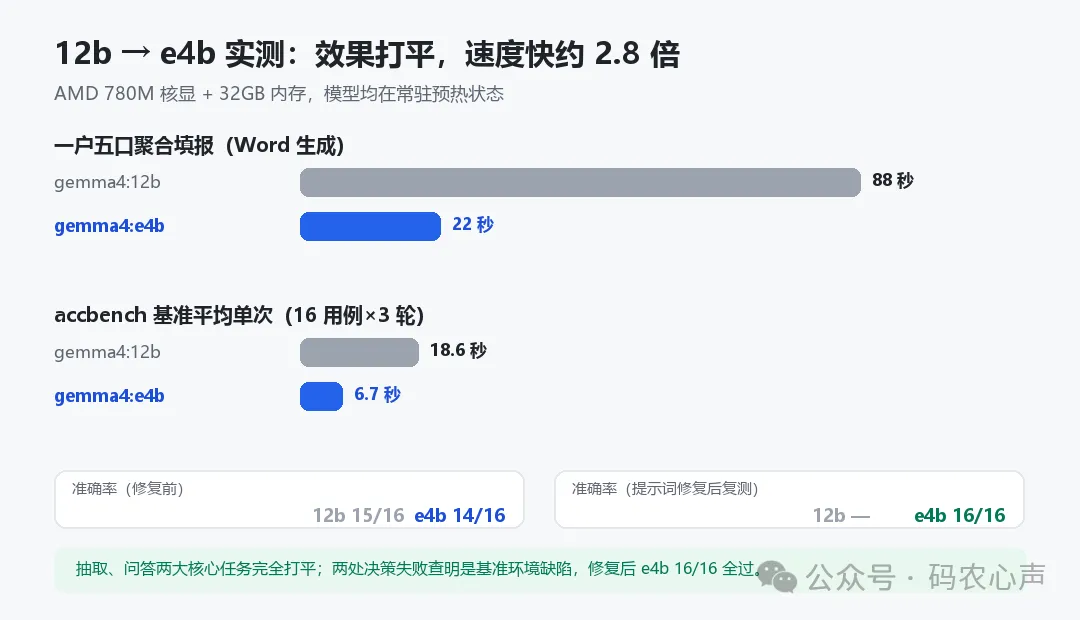
同一台机器、同一批用例的实测对比
逐用例明细(✓ = 3 轮多数通过):
注:D5 / D6 两处失败,事后查明是基准环境缺陷而非模型差距——基准的提示词漏了生产环境必有的「Word 生成配置清单」和「意图→工具速查」,D5 的问法还有指代歧义(模型反问澄清本属合理)。修正后 e4b 复测 16/16 全过。
于是这轮更新把全系统的主模型统一成了 e4b——从界面选项到默认配置,一台 16GB 内存的普通电脑就能跑起来(模型约 6.5GB,显存压力小、更不容易被挤掉),数据照样一台电脑不出。
04 · 实测:e4b 到底多快,108 token/s 是误会
统一 e4b 后重跑了全部基准:16 项用例、3 轮多数投票,16/16 全部通过,平均单次 5.8 秒、620 token。拿 620 ÷ 5.7 秒一算,「生成速度 108 token/s」——比常规大模型服务的 20~30 token/s 快好几倍,乍看不太科学。
拆开 ollama 的底层数据一看,真相是:620 是「输入 + 输出」的合计,而输入部分(prefill)是一次性并行读入的,几乎不占时间,把它摊进耗时里就把速度高估了。两种真实场景实测:
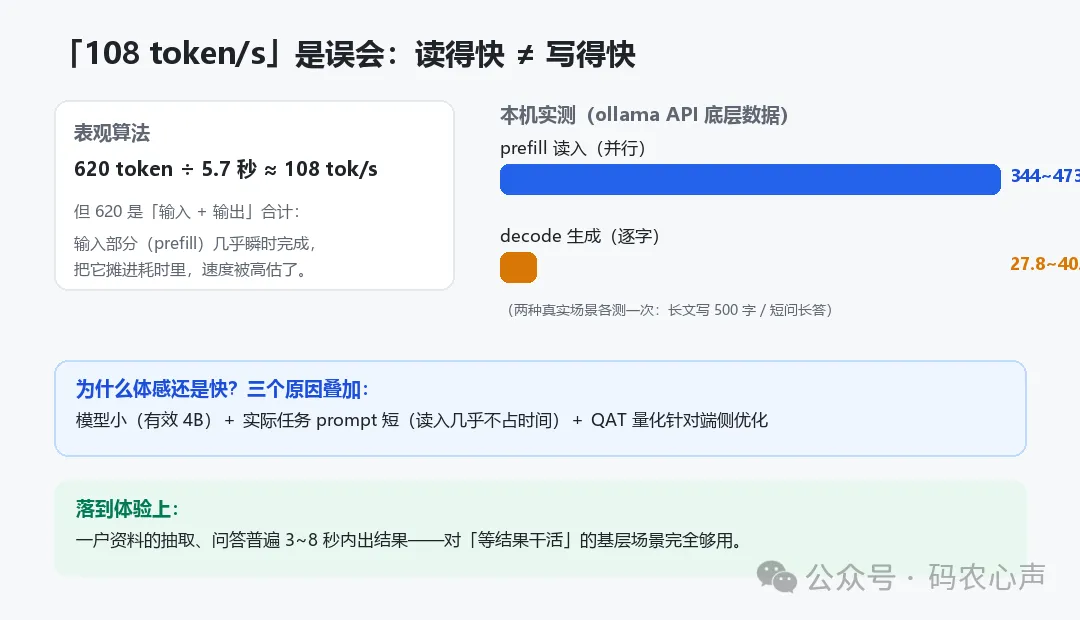
prefill 与 decode 分开测:读得快,不等于写得快
344~473 prefill 读入(token/s) | 27.8~40.7 decode 真实生成(token/s) | 3~8 秒 一户资料实际出结果 |
所以体感快的真正原因是三个因素叠加:模型小(有效 4B)、实际任务的 prompt 短(读入几乎不占时间)、QAT 量化针对端侧优化。27.8~40.7 token/s 的真实生成速度,跟大模型服务的常规水平是同一个量级——但对「等结果干活」的基层场景,一户资料 3~8 秒出结果,已经完全够用了。
⚡ 比换模型更值钱的:提示词工程
基准里有两道「工具决策」题最初只拿三分之一分数。排查发现不是模型不行,而是系统提示词没把「什么意图用什么工具」讲透。给 Runner 加了一段「意图→工具速查」、把生成配置清单注入上下文后,同一台机器同一模型,16 项全过。小模型要在生产里站稳,提示词比参数量更关键。
双模型在启动时,也会自动检测是否预热了,并自动重试:
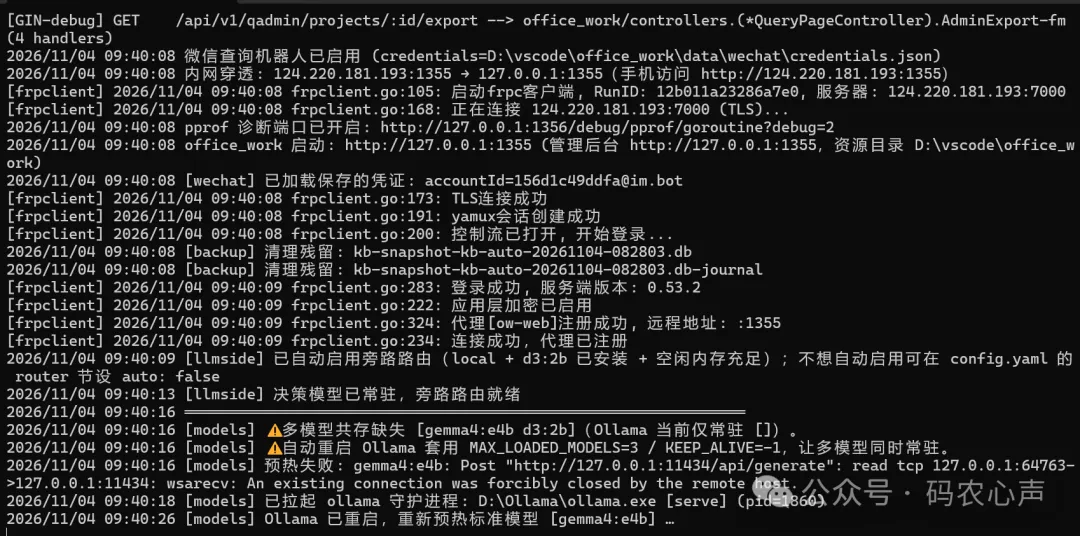
经过这个AI瘦身提速后,一台没显卡内存8G的普通电脑,也能跑本地AI大模型来作为AI台账助手的大脑了。如有问题请在留言区回复。
附最新打包的台账助手软件网盘下载链接:
链接: https://yun.139.com/shareweb/#/w/i/2yA8B51h3EX4f提取码: le2z/*u91R8tkhPwTD:/复制内容打开移动云盘PC客户端,操作更方便哦