ARTICLE · 1307472
那句被当成「源码」贴出来的话,其实只有一句
栏目:观察与政策解读 | 2026-11-04 | 事实核对截止 2026 年 11 月 4 日
十一月初,卡帕西(Andrej Karpathy)用一个周末做了个叫 HackerTube 的网站:只放 Hacker News 上被反复推荐过的技术视频。帖子发出来,评论区有人问「开源吗」。
我原本以为这是个关于 AI 编程的故事。把原博客、讨论串和网站说明页翻完,我觉得更值得写的,其实是那句提问本身。
实现可以被现场重做之后,那句把痛点说清楚的话,本身就成了源码。 这不是修辞,讨论串里有网友用近乎抬杠的方式把它演了一遍,后面会说。
对律师,这件事有两面:等别人给工具这件事,确实可以松一松了;但你能试的范围比程序员窄得多,越线的代价也高得多。这篇把两面都写清楚。
以下前两节是可核对的事实,之后是我的判断与推演。数字和引文都标了出处,核对日期 2026 年 11 月 4 日。
事实一、那天到底做了什么
11 月 1 日的原博客写得很短。周五晚 11 点,他打开 YouTube 想随便看点东西,迎面是夸张封面和翻来覆去的老话题。周六上午,他给 Claude 的任务是一句话:照着 Hacker News 上被推荐过的视频,做一个我们自己的 YouTube 式站点。
数据链路在说明页里写得更细:扫过 2007 至 2026 年 Hacker News 的全部评论,挑出带 YouTube 链接的;一个视频要留下,得至少三个不同的人在至少三个不同月份、带实质评论地贴过;再让模型判断每条评论究竟是在推荐、引用、开玩笑还是批评。
结果是 39,834 条推荐评论、6,454 个视频、150 个主题。封面不用上传的缩略图,取视频正中间一帧;不设账号,点赞和观看记录只存在本机浏览器;排序按「被推荐的独立月份数」,长年反复被提的压过一次性爆红。
他自述「这现在大约要两小时」。同一条讨论里,他补了账单:约 5.04 亿输入 token(九成命中缓存)、760 万输出 token,九成以上花在给评论打标签,写网站和部署只用了约 100 万。
还有两个容易被漏掉的限定。原博客的补充里写明,他本人仍手动做了三件事:申请 Google Cloud 的 API key、开一台 VPS、买域名。而多家媒体报道,他已于 2026 年 5 月 19 日加入 Anthropic 的预训练团队——这次用的是自家模型。
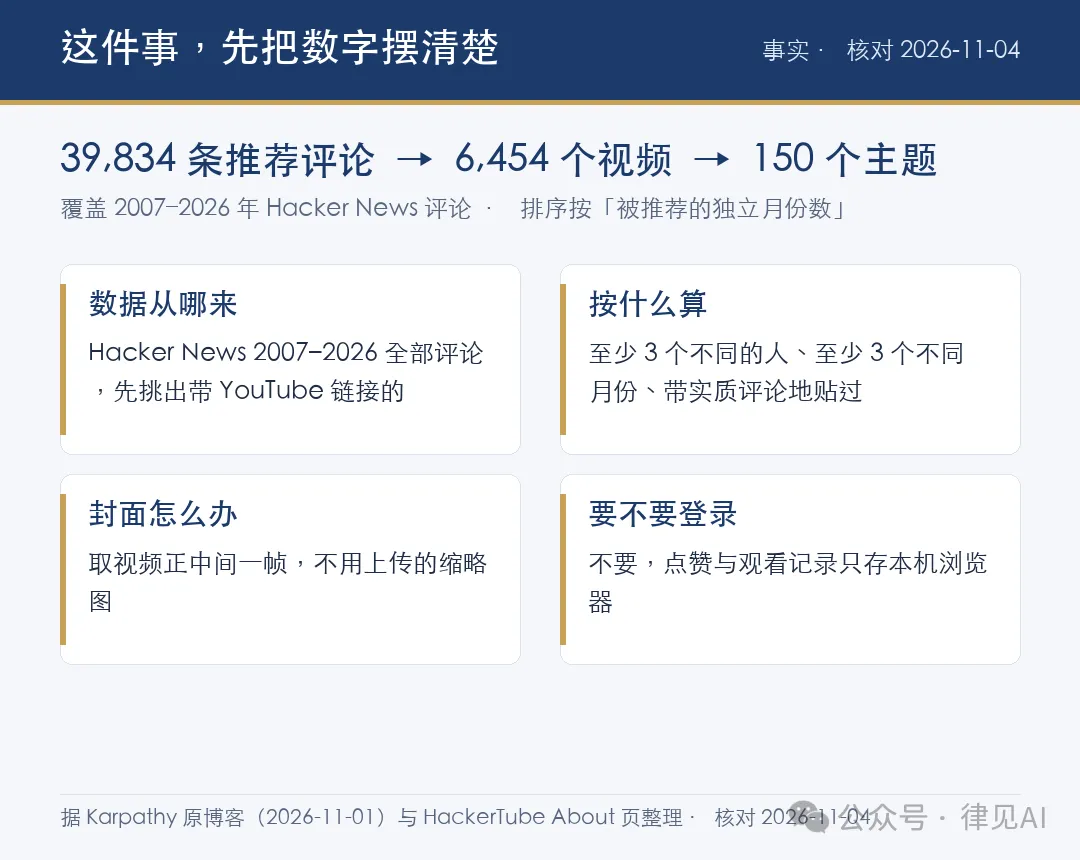
图 1|四个取舍与可核对的数字(据原博客与 About 页整理)
事实二、「开源吗」这句提问,原文比转述更有意思
讨论串里有两条不同的提问。一条是「我在 GitHub 上找不到,开源吗」,另有人把心态说得更直白:「不开源我就不用了」;这条卡帕西没有回。另一条是「源码在哪?我想照着做一个自己专用版本的视频站」,他回了。
原话是:服务端没有发布,因为那是一团 vibe coded 的烂摊子;但把那个 zip 指给你的 Opus 5.5、要一个 YouTube 式的站,基本上就是瞬间的事,这部分大概三分钟。他补了一句:YouTube 的数据没法一起分发,你得自己去申请一个免费的 API key,好在这只麻烦一分钟。
他确实把数据放出来了。说明页的「Fork it」写着:这站背后的一切都可以拿去用,最简单的方式是把 zip 交给你的 AI agent,告诉它你要什么——换个界面、每周一封你关心主题的邮件、一个终端浏览器,或者一份分析。
zip 是 17.8 MB,含 6,454 个视频的记录、39,834 条已标注评论、主题表和搜索向量,还有一份专门写给 AI 看的 DATA.md,按 ODC-By 1.0 开放,条件是署名。YouTube 自己的描述、播放量、时长一个字节都没放进去,理由写得很直白:YouTube 的条款不允许再分发。
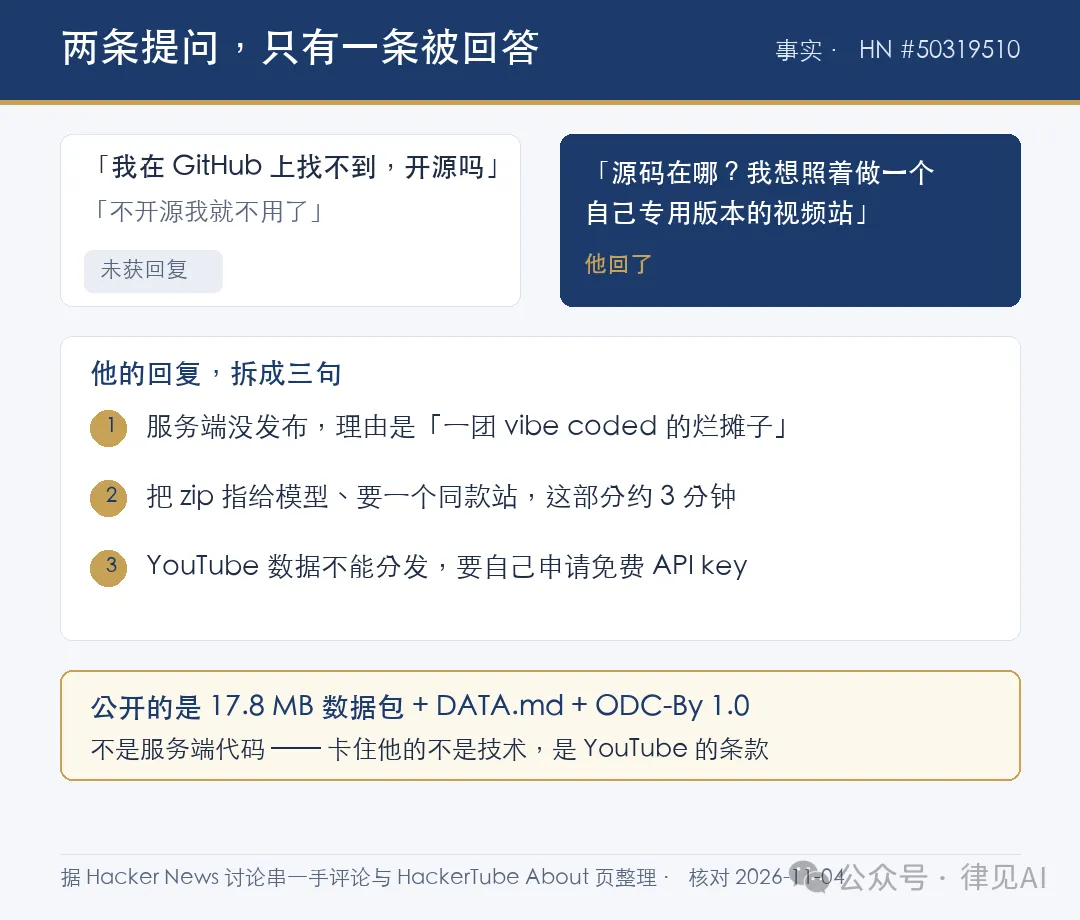
图 2|两条不同的提问,只有一条被回答
观点三、那句被当成源码贴出来的话
回到「开源吗」那条。有人回帖说:源码短得惊人,我直接贴这儿吧——然后贴出来的是卡帕西那句任务描述,「照着 Hacker News 上被推荐过的视频,做一个我们自己的 YouTube 克隆」。
底下立刻有人接:那不是源码,那是留给读者的练习题。
这两句比卡帕西本人的回复更准确地说明了变化。旁边还有人说,就算这站哪天关了,你用两小时的订阅也能自己做一个;另一个人干脆换算成「自己建 2.1 小时,或者拿到源码后 2 分钟」。
争论的重心已经从「能不能拿到」挪到了「值不值得拿」。过去问开源,隐含前提是:我想用这个东西,得先拿到它的实现;实现有门槛,所以我得等作者给。当实现可以被现场重做,这个前提就不成立了。
也有人把这层说得更准:真理来源变了,从公司变成了你自己的来源。HackerTube 把排序权从 YouTube 的观看时长,换成了 Hacker News 上的人反复推荐谁。变的不是界面,是「什么算好」由谁定。
观点四、但别把话说满:开源没有变不重要,是「源码」换了指向
我不同意「开源没用了」这个推论。开源解决的是另外几件事:能不能审、能不能一起改、能不能在原作者撒手之后继续活下去。这些恰恰是现场重做给不了的。
HackerTube 自己就是反证。服务端代码没发布,理由是「一团烂摊子」——能跑,但不好读、不好维护、不敢让人接手。公开的是数据包、写给 AI 的说明、以及一份许可协议。
开源的不是代码,是判断标准和可用数据。 更值得注意的是那条边界:连他也不能把 YouTube 的元数据一起给你。卡住他的不是技术,是第三方平台的条款。你得自己申请 key、自己取数、自己承担那部分合规。
对律师读者,这里的落点其实很具体:拿到一个工具,先问的不该是「它开不开源」,而是「它的数据从哪来、我有没有权利用、出问题时谁负责」。这三个问题,源码给不了答案。
观点五、贵的不是界面,是把标准跑在材料上
把 5.04 亿 token 那个数字再看一眼:九成以上花在给评论打标签。真正写网站、部署、加固,约 100 万。
说明页把这套标准列得很清楚:至少三人、至少三个不同月份、要有实质评论、要区分推荐与引用玩笑批评、排序看独立月份数而不是热度。每一条都是一句判断,合起来才是「什么算值得看」。
贵的是把标准跑在一堆材料上,不是把界面做出来。 界面可以重做,判断不能。这也是最不容易外包的那一段:模型能替你把四十万条评论读完,但「三个不同月份」这个门槛该不该设、设成三还是五,得有人拍板。
律师手上对应的东西其实很熟悉。把一摞材料按「哪几份真正要紧」分开,比最后出一份文书贵得多,也更依赖专业判断。AI 压低的是后一段的成本,前一段几乎没动。
观点六、我在法律 AI 学习圈反复遇到的同一个句式
做线下工作坊时,我最常听到的不是「我这件事该怎么拆」,而是「能不能把你那套发我」「有没有现成的模板能直接用」。热情很高,落到自己手上那一步,常常空着。
这不是懒。律师时间稀缺、专业判断力强,要一个能直接上手的东西,是很自然的反应。但这个句式和「开源吗」是同一个:都在等别人把答案交出来。
差别在于,等来的是别人的标准。别人的模板按别人的案源、别人的卷宗习惯、别人的风险偏好调过;你真正烦的那件事,可能压根不在里面。
有意思的是,讨论串里真正动手的人反而没问开源。有人说想在电视上看、还想让内容自己保持更新,于是做了个 Apple TV 应用和一小段后台,顺手开了源;另一位加进了艺术、电影制作类来源,做了自己的版本。他们都是先说清「我还想要什么」,再去找实现方式。
观点七、律师的「自己试」,得先划一条线
所以我不劝你也去做个网站,更不劝你拿在办案件练手。AI 把试错成本压低了,但没把出错代价压低。
判断能不能试,我用一个很笨的标准:这件事做错了,会不会进卷宗、会不会外泄。会,就先别试;不会,再谈工具。
AI 没有把责任一起外包出去。 客户信息和未公开案情不进公开 AI 工具,这是底线;AI 给出的法条、案号、结论要逐条人工核验;对外署名的律师担全责。这几条不因为实现变便宜了就松动半分。
能试的余地其实不小:公开裁判文书、已脱敏的样本、不进卷宗的材料整理与归类、内部知识条目的初筛。先在这些环节把「我到底烦什么」说清楚,比找一套万能模板有用。
本文为个人经验分享,不构成具体案件的法律意见。
观点八、别把这件事讲顺了:三条相反的证据
把「自己去试」写成鸡汤很容易,但一手讨论里有几条反证,我更愿意留着。
第一,有人几个月前就试过类似的事:用字符串匹配从评论里挑纪录片,放进表格,每天随机看一部。「结果不太理想,就停了」,他写道,打算换成更省事的做法再来一次。自己试,不等于试得成。
第二,筛选标准有保质期。有人按上传时间一筛,发现最近的是五个月前,直接问「是不是过去五个月没有好视频了」;也有人不客气地说,这本质上就是一个按预设清单做出来的精选播放列表。数据源的偏好、年代、圈层,会原样长进结果里。
第三,一位评论者提醒:这类系统一旦成了入口,源头就会有人来刷。你的筛选标准越像「真理来源」,越会有人专门来钻它。这在律师场景里并不陌生——检索结果的出处可不可信,从来不能只看它排第几。
他在讨论串里还补了一句:这站短期内不会消失,理由很朴素,他自己还要用。一句话把这类小工具的真实寿命说透了。
推演九、现在、半年、更远
现在:等厂商排期这件事可以松一松。一个只服务你一个团队的小需求,未必非得等到产品路线图上有它。但先过那道「会不会进卷宗、会不会外泄」的筛子,再拿公开材料试一次。
半年:所里大概会多出一批只对准一个场景的小清单、小工具,评估口径从「通不通用」变成「有没有对准那个具体的烦」。跟着来的是不那么好玩的部分:谁维护、版本怎么算、出了错谁签字。上面那位「结果不理想就停了」的网友,已经预演过一次。
更远:稀缺的能力会从「会不会用工具」移到「能不能把专业判断写清楚」。这一条对律师反而是主场——把事实摆清楚、把标准定明白、把边界划出来,本来就是执业训练。变的只是:写清楚之后,能被执行的东西变多了。
结尾
那条讨论里最打动我的不是卡帕西的回复,是有人把「源码」贴出来时,贴的是一句话:做一个只放 Hacker News 上被反复推荐的视频的站点。
那句话之所以够用,是因为背后已经有人想清楚了:从哪来、按什么算、不要什么。剩下的,AI 能补。
你手边大概也有一件忍了挺久的事——可能是每周都要从一堆材料里挑出那几份真正要紧的,可能是同一类问题被问了十几遍。先别找现成工具,也别问谁开源。把那件事写成一句别人能照着做的话,拿一份公开材料试一次。
试不成也没关系。至少那句话是你的。
图 3|本文的结构:事实 / 观点 / 推演
参考资料
1. Andrej Karpathy, HackerTubehttps://karpathy.bearblog.dev/hacker-tube/, 2026-11-01(原博客,含 2 小时自述与三件手工活)
2. Hacker News 讨论串 #50319510https://news.ycombinator.com/item?id=50319510(含两条「开源吗」提问、zip 与 API key 的回复、token 用量、网友自建版本与反证;经 HN Algolia API 读取原文)
3. HackerTube About 页https://hackertube.org/about(筛选标准、Fork it、DATA.md、ODC-By 1.0 与 YouTube 条款说明);数据下载页https://hackertube.org/data
4. 凤凰网科技:嫌 YouTube 推荐太烂,卡帕西用 2 小时做出替代网站https://original.ifeng.com/c/8xiuoB9Kjjc,2026-11-02(含「2 小时属个人项目实践」的限定)
5. 中新经纬:卡帕西加入 Anthropichttps://www.jwview.com/jingwei/html/05-21/671590.shtml,2026-05-21(任职与履历)
6. 凤凰网科技:「重做 YouTube」夸张了https://tech.ifeng.com/c/8xj6TIfbaiO,2026-11-02(策展层定位与人工挑选的局限)
以上链接与数据核对截止:2026 年 11 月 4 日。文中「法律 AI 学习圈工作坊」相关段落为本人观察,未做统计。