ARTICLE · 1309317
微软发现:AI工具越多越笨?
如果你让现在的AI去操作电脑,比如修改一个Excel表格、整理一份文档,或者去网页上查个数据填进表里,它一般怎么干活?绝大多数方案是让AI“看屏幕截图,然后用鼠标点、用键盘敲”。这种方法也就是常说的GUI(图形用户界面)交互。
这种方式确实很直观,但实际操作起来却常常让人头疼。想象一下,你让AI把一份表格里所有低于60分的成绩标红。如果只用鼠标点,它得来回滚动页面,找到每一行,选中,再设置颜色。更麻烦的是,AI每动一下,都得截一张图确认结果。截图特别消耗Token(模型处理信息的单位),而且这种纯靠肉眼看截图确认的方式,很容易出错,甚至无法发现底层数据其实没保存成功。
微软最近发布的技术报告《Mage-VL-Cowork》里,提到了一个很有意思的思路:为什么不教AI像程序员一样干活呢?
这篇报告介绍了一个叫 Mage-VL-Cowork 的模型,它只有4B(40亿)参数,是个典型的“轻量级”选手。但它不仅能看屏幕、点鼠标,还能打开终端、写代码执行命令。它在权威的桌面任务评测基准OSWorld-Verified上,50步预算下拿到了66.0%的得分,这个成绩直接把同场竞技的Muse Glimmer-30B(65.9%)、Qwen3.6-27B(63.9%)和EvoCUA-32B(56.7%)甩在了身后。
一个小巧的模型,是怎么做到一边看画面、一边敲命令,还能比那些大它好几倍的模型考得更好的?这篇报告里有大量的工程细节和训练心得。接下来,我们就按“遇到问题 → 理解原理 → 拆解步骤 → 避开坑”的顺序,把这套“混合操作系统”的底层逻辑和实操方法给大伙儿掰扯清楚。
第一部分:为什么纯“点鼠标”是个笨办法?
我们先从痛点说起。计算机使用智能体(Computer-Use Agents,简称CUA)现在成了热门方向。但如果你真去训练一个纯靠鼠标键盘干活的AI,会发现几个绕不过去的坎。
第一个坎是“昂贵”。 报告里明确提到,典型的屏幕截图包含大量像素信息,一张图解析下来可能需要消耗数千个Token。处理高分辨率图像不仅慢,而且贵。这就像你让一个人干活,每动一下都得用高清相机拍张照,再琢磨半天照片,效率太低了。
第二个坎是“看不见真相”。 很多时候,我们在对话框里点了“保存”按钮,界面上会弹出一个“保存成功”的提示。AI看到截图上的这几个字,就以为大功告成了。但实际上呢?底层的文件可能根本没被写入,或者只保存了一部分。只靠看截图,AI永远不知道后台到底发生了什么。
第三个坎是“效率瓶颈”。 像整理结构化文件(比如将数据填入Excel、修改PPT的每一页格式)这类任务,如果用鼠标操作,AI需要经历“定位元素 → 点击 → 滚动 → 继续定位”的漫长过程。而一个熟悉电脑的人,通常直接开个终端,几行代码就搞定了。
报告里用了一个很贴切的比喻:一个人即使再习惯用鼠标,也不会把自己限制在鼠标上。 当终端更快时,他会开终端;当需要看对话框里的保存结果时,他会直接去读文件确认。
所以,Mage-VL-Cowork 提出了“混合计算机使用”(Hybrid CUA)的概念。它有两个动作通道: 1. GUI通道:看屏幕截图,输出鼠标坐标和键盘按键。 2. 终端/代码通道:提供一个持久的Shell环境,AI可以在这里运行代码、调用命令行工具、直接操作各种应用库。
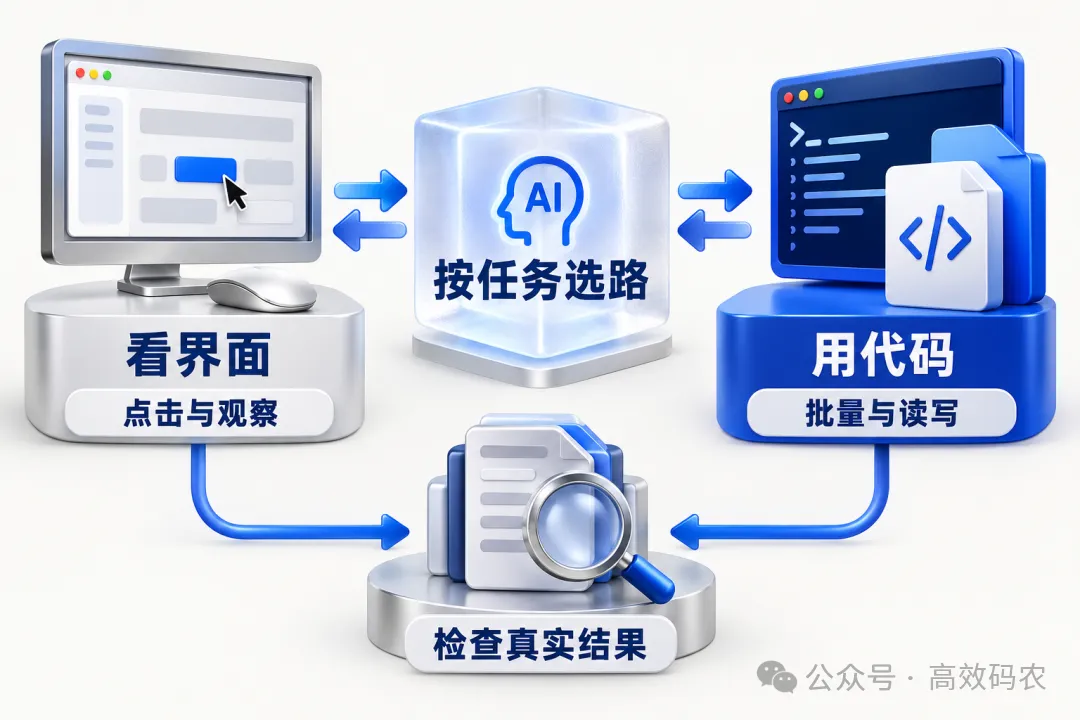
但这里有个非常棘手的问题:有了混合通道,不代表模型就会用。 报告指出,即使是最顶尖的前沿模型(比如文中提到的GPT-5.4),在默认状态下,它对通道的“路由选择”也是不完美的。它经常会出现“路径依赖”——比如用鼠标在一个循环重复的文件修改任务里疯狂点击,或者在内存应用缓存了状态时,非要去修改底层磁盘文件,导致界面和底层状态冲突。
这就是训练中最大的拦路虎。如果直接拿这些“大模型老师”的默认操作记录去教4B的小模型,小模型不仅学不到好习惯,反而会把老师的坏习惯全盘接收。
所以,训练的第一步不是教学生,而是先改造老师。
第二部分:先给“老师”换上一套称手的兵器
在强化学习中,大模型充当“老师”,通过执行任务生成示范数据。Mage-VL-Cowork 的研发团队发现,要得到高质量的混合执行数据,不能直接让老师按照默认方式干活,而是得给老师精心设计并“进化”它的外部环境,也就是所谓的 Harness(脚手架)。
报告中把老师智能体定义为 Aₜ=(Mₜ,H),其中 Mₜ 是老师模型(比如固定权重的GPT-5.4),而 H 就是我们需要进化的 Harness。这套脚手架包含四个关键部分:
在进化这套Harness的过程中,团队发现了一个非常反直觉的现象:进化不仅是不断加工具,更重要的是“做减法”。
xdotool 这种基于坐标的鼠标键盘自动化工具。但既然模型已经能通过原生截图去操作鼠标了,保留这个工具只会让监督信号分散到不同的路径上,还容易因为窗口焦点问题导致操作失败。所以,他们果断把它移除了。python-pptx 这样的专用库。AI可以直接调用库来操作幻灯片、形状和文本,效率天壤之别。他们还对比了两种不同的Harness配置。一个是 β₁ 版本(只包含GUI和代码通道),另一个是 β₂ 版本(除了GUI和代码,还加了一个“无障碍”AX通道)。在同样使用GPT-5.4作为老师的情况下,结果如何呢? * 老师对比:β₁ 的成功率是92.0%,而加上了AX通道的 β₂ 是89.6%,稍微低了一点。执行步数上,β₁ 是25步,β₂ 却需要35步。 * 学生对比(这才是关键):当把他们分别生成的示范数据拿去教4B的学生模型时,差距被放大了。β₁ 教出的学生成功率为37.6%,而 β₂ 教出的学生只有25.1%,步数更是从30.91步暴增到39.4步。
避坑要点:为什么工具多反而害了学生?报告分析得很清楚——对于前沿大模型,它可以耗费大量步数去试错和弥补多通道带来的模糊性;但对于一个4B的小模型来说,它非常敏感,多一个模棱两可的通道,就会让它的行为变得摇摆不定。把老师的Harness改精简、改精炼,收益远大于给它堆砌工具。 在动手实践时,要记住,工具的选择不在于多,而在于路径的确定性。
进化后的Harness一旦选定,就会固定下来,用于后续的大规模数据生成。而负责评审任务完成情况的,是GPT-5.6-terra(作为裁判)。同时,还有一个轨迹质量过滤器,专门剔除那些通道路由混乱、工具使用不规范的记录。
第三部分:如何大规模“造题”?工业化的流水线作业
有了好老师,下一步就是准备大量的任务和环境。如果给的数据太少,模型学不会;如果数据太单一,模型就会过拟合。现实中,要手工制作成千上万个带有明确标准答案的桌面应用任务,成本是极其高昂的。
Mage-VL-Cowork 采用了一条叫 Mage-CUA-Forge 的环境合成流水线,核心理念只有四个字:工作流优先。
传统的智能体造题方式,往往是由一个Agent去自由探索,每次遇到一个新任务,就从头写一遍环境搭建脚本。这种做法就像每次做饭都要去砍柴生火一样,重复劳动太多。
Mage-CUA-Forge 的做法是: 1. 一次构建,无限复用:针对每一个原子技能(比如“在Excel中设置单元格背景色”),让一个“作者Agent”去编写一套可复用的生成工作流(Workflow)。 2. 组件化拆分:这套工作流由多个节点组成,包括LLM节点(用来写题目和评分标准)、文件预处理器(比如生成一个带数据的CSV文件)以及环境设置操作(比如打开某个应用、调整桌面状态)。 3. 一致性验证:当这些分支组装在一起后,会有一个“门卫”(Gate)节点,检查生成的指令、环境脚本和评分标准三者是否一致。只有一致的任务才会被采用。
这样做带来了什么好处? 报告中给出了非常明确的数据——采用工作流优先的生成方式,每次生成任务的可变支出降低了 82.6%(从每次0.906降到0.158),Token消耗量降低了 93.3%(从127.6万降到8.5万)。
动手实践的复现逻辑: 如果你在自己的项目中要复现这套造题机制,可以遵循这三个步骤: 1. 定义技能树:先把你需要模型掌握的能力拆解成“原子技能”,比如“打开浏览器”、“输入URL”、“查找页面上的按钮”、“下载文件”等。 2. 搭建预处理器:准备好各种格式的文件生成代码。比如,要测试文档编辑,得先有一个能自动生成带随机内容的Word或PDF文件的脚本;要测试浏览器操作,得搭建一个本地可重置的网页环境(这份报告就结合了InfiniteWeb和WebHarbor,构建了高度还原且能重置数据库的本地网站)。 3. 组装工作流:将LLM指令生成节点、文件准备节点、评分检查节点串起来,形成标准流水线。
在网页任务合成方面,报告还详细说明了如何解决“信息泄露”和“评分难题”。为了防止大模型在生成题目时,不小心把答案也写在题目里,他们用了“信息不对称”的策略:指令渲染的LLM只能看到公开的查询约束条件,而真正的答案记录和数据库状态则被隐藏起来。
只有真正的验证器(Verifier)才能拿到私密的目标记录,通过检查任务轨迹(是否访问了目标页面)和最终状态(数据库SQLite中的记录是否改变)来打分。这极大地减少了模型“瞎蒙”得分的情况。
第四部分:五步走,把“偏科生”练成“全能高手”
一切准备就绪,接下来就是训练了。Mage-VL-Cowork 没有直接拿着混合数据就开始猛训,而是设计了一个循序渐进的五阶段课程,先建立独立能力,再教融合。这套流程,对很多做垂直领域微调的团队来说,非常具有参考价值。
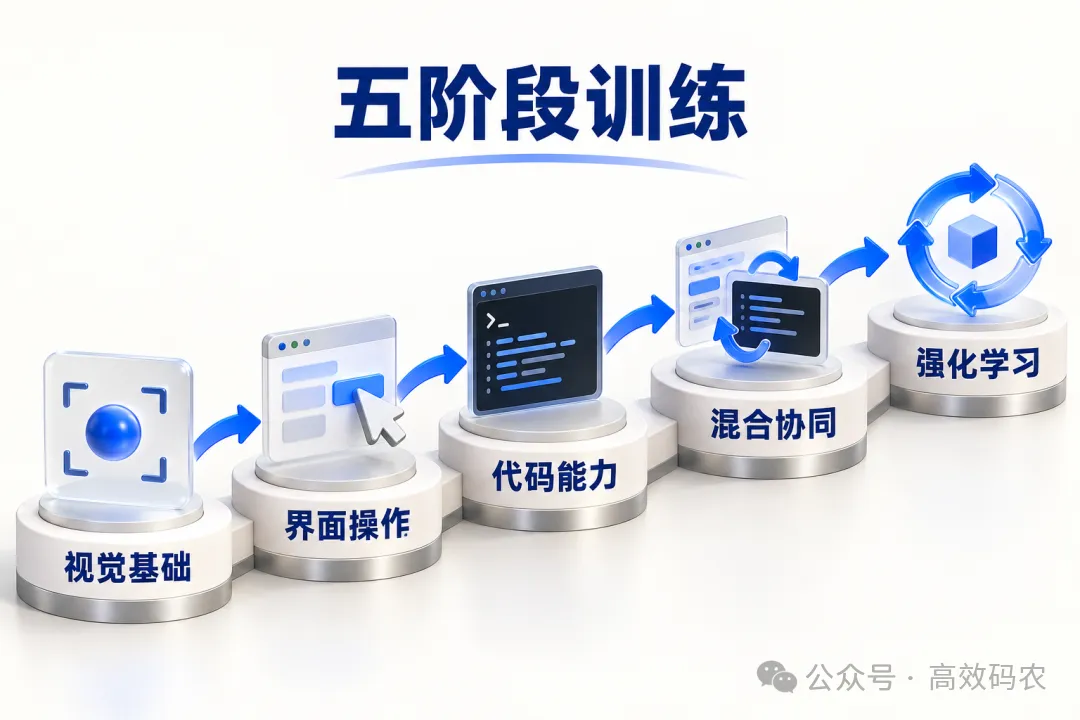
第一阶段:GUI导向的中间训练(Midtraining) 这一步是打地基。团队使用的是一个未完全对齐的4B Mage-VL检查点。评估发现,这个初始模型连最基础的视觉定位、思维链推理和结构化工具调用都没做好。它有一种“答题机倾向”,看到问题就想用最短的废话直接回答,而不是先思考、再输出格式化的动作。
所以,第一阶段要专门对这三项“原子能力”进行训练。他们构建了一个包含720p到1080p桌面和浏览器截图的语料库,把所有的空间标注都格式化为 computer_use click 这样的工具调用格式。
操作细节与坑点: * 动作空间坍缩:如果直接拿“只点鼠标”的数据去用完整的10种动作的提示词训练,模型会学傻掉,它以后只会点鼠标,不会输入文字、不会滚动页面。解决办法是“系统提示词解耦”,将点击动作和完整Agent动作分别用不同的提示词环境训练,最后再合并。 * 抄答案陷阱:训练数据中,同一个截图可能配了多个不同的指令,但它们都指向同一个按钮。如果把这些问题打包放在同一个上下文里,模型很快就会学会偷懒——后面的问题它直接复制前面输出的坐标,不再去看图了。解决办法是,同一张截图下的同一个目标,只保留一条指令,强制模型每次都去看图。 * 思考与动作的平衡:为了防止模型变成只会长篇大论的“理论家”,或者只会点鼠标的“莽夫”,他们在训练时采用了“选择性掩码”策略。对推理的 <think> 内部进行掩码屏蔽(不计算梯度),但保留首尾的标签结构,确保模型保留“先思考再行动”的格式,同时把训练重点放在学习工具调用的语法和坐标定位上。
第二阶段:GUI Agent SFT(监督微调) 在第一阶段的基础上,这一阶段直接使用纯GUI环境下的老师轨迹来微调。目的是把第一步学到的单一视觉定位能力,串联成完整的多步交互流程。模型要学会:看当前截图、结合历史交互、预测下一步的点击、输入、滚动等动作。只有先在这个纯视觉通道里把能力练扎实,后面引入代码通道时,它才不会因为视觉基础薄弱而全盘依赖代码。
第三阶段:代码与终端 SFT 这一阶段专攻编程和终端操作。数据来源包括了通用的软件工程数据和桌面终端的实际任务数据(比如操作各种电子表格、文档和幻灯片)。值得注意的是,他们让纯终端老师去执行第二阶段那批桌面任务,保留成功的代码轨迹。这就给了模型示范:同一个目标,如果用代码去实现,到底是什么样的。
第四阶段:混合 CUA SFT 到了这里,开始“大融合”。使用进化后的混合Harness收集来的318,837条高质量轨迹,让模型在同一个共享的上下文中,学习通道路由——什么时候该点界面,什么时候该用终端;什么时候用代码改文件,什么时候切回界面看效果。
这个阶段的核心在于“数据清洗”。报告特别强调,4B模型对噪声非常敏感。如果老师的数据里包含了模糊的示范,或者冗长且无用的操作步数,学生就会学偏。所以,保留的轨迹都是经过质量过滤的,这些轨迹不仅成功率高,而且Token效率也高。最终,这道工序产出了1,377,805个打包好的训练单元。
第五阶段:在线混合强化学习(RL) 最后一个阶段,用强化学习(具体是GRPO算法)在混合环境里进一步打磨。这一步用的是ScaleCUA发布的1,988个带有可验证奖励的任务。
这里关注的重点是效率与效果的平衡。强化学习的奖励不仅看任务是否完成,还在一定程度上惩罚那些废话太多的行为。最终的结果是,相比第四阶段的SFT模型,RL后的模型在任务得分上又提高了10.16个百分点,同时模型调用次数减少了13.0%,输出Token减少了25.4%。
实操层面的启示:如果你的团队准备微调自己的Agent模型,这五步法提供了一个高确定性的路径。不要一上来就用最复杂的混合数据去冲,要先分别建立“视觉操作”和“代码操作”的单点能力,再去教它们怎么协同。
第五部分:隐形的工程管道,撑起长周期任务
模型训练得好不好,除了算法,基础设施也是关键。这也是报告中很有干货的一部分。
桌面任务有个特点:它不像在纯文本环境里回答一个问题只需要几秒钟。一个真实的桌面任务,从打开应用、加载数据、点击操作到最终确认,可能会持续几十分钟甚至更长(报告中提到,单个观察到的Episode甚至超过了40分钟)。
这就带来了一个严重的工程矛盾:如果GPU在训练时要同步等待CPU上的桌面环境跑完整个操作,那GPU大部分时间都在空转,这太奢侈了。
Mage-VL-Cowork 的解决办法是搭建了 Rollout-as-a-Service(RaaS)架构。把训练、推理和环境执行彻底解耦: 1. CPU集群负责跑环境:用大量虚拟机(Azure VMSS)来承载桌面应用和智能体的操作循环。每个虚拟机有独立的资源(如16个vCPU、256G内存,分配到8个vCPU和4G内存的Guest机里)。 2. GPU集群负责推理和训练:SGLang负责提供模型请求服务,Slime和适配器负责训练。 3. 异步执行:允许各个桌面任务在自己的时间线上跑,完成一个任务就推送一个轨迹回训练中心,不需要整个集群卡在同一个步调上。
这还不够,这里还有一个非常硬核的强化学习细节:策略滞后(Policy Lag)。 因为训练是在异步进行的,当你用模型版本A去生成数据时,训练端可能已经更新到版本B了。如果版本差太大,数据就不准了。报告里设定了一个规则:采用“四个批次大小的准入窗口”,把策略滞后限制在最多3个更新步以内。并且,通过截断重要性采样(TIS)来修正这种分布偏移。
此外,对于视觉输入,由于每张截图很大,传输成本高,他们做了两件事:一是“轨迹紧凑化”,传输时去重截图;二是“预取与本地扩展”,利用本地CPU算力提前把图像解码、缩放好,避免全部堆在GPU上处理。
避坑要点:如果你的场景也需要做复杂的Agent训练,请务必提前规划好环境容量。CPU(跑虚拟机)和GPU(跑模型)的配比不是静态的,通常环境执行和编排产生的延迟,在遇到长尾任务时,会成为整个系统的瓶颈。通过生命周期分离的准入限制(初始化、运行中、运行后处理分别设置并发上限),可以有效防止因个别慢任务拖垮整个集群。
第六部分:这种“混合”模式,究竟带来了什么改变?
回顾整个流程,Mage-VL-Cowork 的成功其实并不是靠堆参数,而是做对了几件事:
1. 从“完全依赖像素”到“双通道并行” 数据最有说服力。在最终保留的混合数据集中,GUI操作占了老师工具调用的68.19%,而终端操作占了31.81%。这31.81%的终端交互,解决了很多原先仅靠截图根本无法完成的问题——比如精确的数据读写、批量文件处理。
更直观的结果是,在OSWorld-Verified的“OS系统类”任务上,这个4B模型拿到了87.5%的高分,是整个评测表中最高的分数;在多应用工作流任务上,也达到了62.7%,比9B的ScaleCUA-Qwen3.5-9B高出了14.6个百分点。
2. 评测基准的“挤水分” 在浏览器任务评测(WebVoyager-Static)中,团队揭示了一个现象:过去业界很多在Live(真实网页)上跑出的高分是有水分的。因为很多评测只检查最后一张截图。大模型太聪明了,它看看搜索结果的摘要卡片,或者依靠自己的“先验知识”,就能猜出答案,甚至截图显示它“提交”了表单,但其实后台数据库根本没有任何变化。 他们做了一个更严格的“静态本地复刻版”评测,不仅检查最终答案,还要检查访问轨迹和后台数据库状态。结果,之前那些Live榜上得分高达74%、78%的模型,在这个严格版评测下直接掉到了47%、46%(下降了27到33个百分点)。
而Mage-VL-Cowork-SFT在这套严格标准下,拿下了58.6%的真实成功率,排名第二,仅次于专用的浏览器Agent Fara1.5-4B。
3. 效率的极致提升 训练过程中,从纯GUI SFT到混合SFT,再到最后的RL,性能在不断攀升(45.56% → 55.84% → 66.0%)。更关键的是,模型调用次数(也就是行动的步数)从25.36步降到了18.77步,输出Token从6401降到了5499(其中推理Token降低了约25.4%)。
这意味着模型不仅变强了,而且变得更“干脆利落”了。 这对于部署在端侧、算力有限的场景来说,意义重大。
小结与开工前的叮嘱
把Mage-VL-Cowork的这套方案看完,你可能会发现,它其实并不是一个多么“炫技”的创新。它解决的是实际工程中非常具体的问题:用繁琐的截图去干结构化的活太慢了,所以引入代码;模型在混合通道里容易犯迷糊,所以给老师精简工具;数据不够多样化,所以搭建自动化的环境生成流水线。
如果你正准备在自己的业务里训练一个智能体,这里有几点从报告里总结出的前置建议:
总的来说,Mage-VL-Cowork 证明了一件事:在计算机使用这个领域,让AI学会像程序员一样“偷懒”(用代码解决重复劳动),同时像普通人一样“感知”(用眼睛观察界面),它才能在复杂的桌面世界里真正做到游刃有余。 相比于一味地将模型做大,这种工程层面的精细化设计与训练策略,才是让技术真正走向普及的关键所在。