ARTICLE · 1309622
AI 视频实战①:三层工具指导下,我手搓出一部有模有样的四合院营造小片
01 一个朴素的起因
上个月我做了一件事:用 AI 工具链,从头做了一部北京四合院的科普片。
成片 8 分 55 秒,1920×1080,13377 帧。讲的是一座房子怎么从平地站起来——以及它为什么必须长成这样。
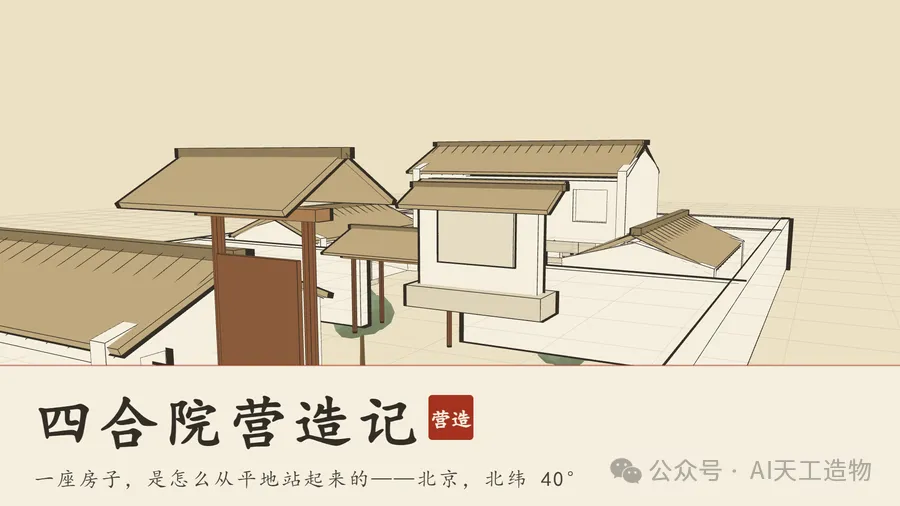
先说清楚它不是什么:不是「四合院介绍」,不是景点讲解。全片的核心只有一句话:
北京四合院不是设计出来的,是被三根绳子同时拴住的。
气候、地理、制度。北纬 40° 决定了出檐多长,冲积平原决定了砖从哪来,《明史》里「庶民庐舍不过三间五架,不许用斗栱饰彩色」决定了它只能有三间。
做之前我先做了考据:8 组以上检索多源交叉,把梁思成《清式营造则例》1934 年版的公版 PDF(143 页、纯扫描无文字层)整本拉下来,36 张老照片全量抽取、8 张关键图版 2.2 倍抽取。这一步没有 AI 的捷径——考据错了,后面画得再漂亮都是错的。
正片结尾还留了一面老照片墙:
片子在分镜阶段就定了一条:正片不配音,纯字幕 + 古琴。理由是这类内容靠画面节奏撑,加了旁白反而夺画面。只有剪给短视频平台的小片,才考虑加 AI 配音。
这一条视频真正要做的,其实不是「拍四合院」。是摸清一件事:哪一段活能交给 AI,哪一段不能。后面七节,全是这个问题的答案。
02 用三层模型做选型
《AI 视频制作-实测:WorkBuddy VS. Remotion》 里我写过一个分层的结论,这里先复述一遍,因为后面全靠它说话:
- L1 生成模型层
——Seedance、可灵、Veo 这类,造「现实里拍不到的画面」,产出的是素材,不是成片 - L2 渲染层
——Remotion、Blender 这类,把每一帧算出来,可复现、可局部重算 - L3 编排层
——OpenMontage、即梦这类,把一句话拆成工序并跑完
那篇实测的结论是:L2 近零成本但费人,L3 省人但要把判断权交给 Agent。你要省什么,决定你站哪层。
这一条视频做下来,我要给那句话补一条:
不只是「你要省什么」,还有「你要对什么负责」。
这一条视频的账是这样分布的——
L1 只用了 1 张图。全片 13377 帧里,AI 生成的画面只有 1 张样张(ImageGen / 混元,5–10 积分),最后还没进成片。影片里所有「真实」的画面,反而是老照片和《清式营造则例》的扫描图版——因为它们有出处、可考、能署名。
L2 是全部主力。每一帧都是算出来的:柱子是 Three.js 线稿,2D 剖面示意是 rough.js 手绘笔触,标注是 SVG,老照片是公版图版。没有一帧是「生成」的。
L3 我没接现成的编排系统。分镜阶段认真评估过 OpenMontage(就是我在 《OpenMontage 实测:视频跑通,卡在声音上》 和 《OpenMontage 视频制作-实测②:声音和画面都救回来了(VSCode VS. WorkBuddy)》 里实测过的那个),最后没走它——它自带的是通用自检(有没有声音、字幕对不对),而我要的质检是「这一帧的燕尾榫画反了没有」「出处条压没压到窗棂框」,通用清单覆盖不了。我换了个那篇实测没提的新工具:自己搭了一个检察官 Agent 来干这个活。
03 从一句话到一条视频:完整过程
很多人问我「你是怎么用 AI 做出来的」。这一节把链路摊开——它和那篇实测最大的不同是:我不用一句提示词直接生成视频,而是把「做一部片」拆成工序,每个工序用提示词指挥 WorkBuddy 写代码、出图、渲染。
- 想法
:先定题眼——「三根绳子拴住四合院」。不是拍建筑,是拍「约束如何长出形式」。 - 提示词(指挥,而非生成)
:每一阶段写提示词,让 WorkBuddy 产出 Three.js / Remotion 代码,而不是让模型直接吐视频。这一步决定了后面所有画面都是「算」出来的,不是「猜」出来的。 - 讨论风格
:不靠模型定审美,靠参照物定基准——梁思成图版、《营造法式》图样、芥子园界画里提炼出墨色(偏暖墨褐、取具体色值)、线宽三档、留白比例、字体楷/宋、动效节奏。宣纸底统一黏合。 - 扩大搜索,丰富题材
:考据阶段 8 组 WebSearch 多处交叉(营造工序 / 榫卯 / 瓦作 / 影壁 / 脊兽 / 风水排水 / 尺度通则 / 院落形制),多源比对产出「10 条常见错传清单」——比如「四合院坐北朝南是因为皇帝规定」这种,查完就知道是讹传。 - 定样片
:v3 阶段先出 0 号定标样张(苫背剖面、相框、rough 笔触),拿它对齐全片视觉,再往下铺。 - 配音讨论
:正片决定不配音,只上字幕 + 古琴(Wikimedia Commons 自由授权,《醉渔唱晚》《阳关三叠》,片尾署名);只有抖音小片版才加 AI 配音(语速 +30%、9:16 重新构图,不是裁切)。 - Agent 自动检查
:样片出来后,交给检察官 Agent 逐轮验收——这一环是那篇实测完全没涉及的,下一节专讲。
04 一条红线:生成模型不许画结构
这是这一条视频最重要的一条经验,也是它和那篇实测最直接的冲突点。
那篇实测里我说过 L1 的价值是「惊艳」。但这一条视频从头到尾立了一条红线,写在方案文档第一页:
生成模型绝不画结构、榫卯、瓦作过程。第三帧就会把燕尾榫画成燕尾槽。教学类内容,错比糙严重。
这不是保守。你可以试一下:让任何一个视频生成模型画「燕尾榫的装配过程」,它大概率给你一个看着很像榫卯的东西——但榫头大头朝哪边、从上往下还是从前往后插,全是随机的。
科普内容的成本结构是反的:广告片错一帧无所谓,观众看的是氛围;教学片错一帧,整个论断就废了,而且错的那一帧往往是观众唯一记住的。
所以这一条视频所有「结构演示」,全部改成程序演算:
榫卯用 3D 建模,卯口里大外小是代码写死的,不是模型猜的 苫背三层(护板灰 / 灰泥背 / 青灰背)用 rough.js 手绘笔触画剖面,每层材质填充是指定色 出檐长度按公式算: 檐出 L = 墙高 H ÷ tan(73.5°),屏幕上那根红线从太阳圆心发出,角度是数值,不是笔刷
有意思的是反过来那部分:老照片和图版,反而是全片最「真实」的素材——因为它们有出处、可考、能署名。越是要「正确」的地方,越要用能追到源头的东西。
05 检察官:让 Agent 出片,让 Agent 检查,我只拍板
做到第三幕我撞上一个问题。
每一幕 2000–3600 帧,我要逐帧看它有没有画错、字有没有被压住、插图有没有配错。这是纯重复劳动,而且人眼看到第 800 帧,可靠度已经掉得厉害了。
我的解法是:再开一个 Agent 当质检员,我叫它「检察官」。它是这一条视频引入的、那篇实测没讲的新工具——那篇实测只讲了三层,没讲「怎么保证 L2 画出来的东西是对的」。
它的工作方式写在一份清单里,三条关键设计:
一、检查项清单化。不让它凭感觉说「我觉得有点怪」,而是列成可判定的条目——音轨 A1–A3、构图 B1–B6、内容 C1–C3、插图 D1–D5、考据红线 E1–E3,加上一张 R1–R22 历史反馈回归表(每一条都来自我之前踩过的坑,比如「柱子必须垂直」「插图不许配错主题」「瓦不许画成长方形」)。通用项 20 条 + 回归项 22 条 = 42 个检查点。
二、只许它看,不许它改。这是我最满意的一条设计——权限是只读视频 + 写报告,不得碰工程代码。它要是能自己改,就会出现「它改完自己验收通过」的死循环。运动员和裁判必须分开。
三、分歧不许自己拍板。它和我的判断不一致时,不自行取舍,整理成「分歧点 + 双方理由 + 可选项」交给我裁决。
判定规则只有一句:有任一 ❌ 即「需修改」,没有「差不多就行」。
它的检查过程很笨也很有效:ffmpeg 每 2 秒抽一张帧,转场和节拍边界加密到每 0.5 秒一张,逐张目检,音轨用 volumedetect 分段查响度。后来优化成一版「拼图抽查」:全片每 4 秒一帧拼成网格、改动段每 1 秒、字幕带每 2 秒一条——读图量直接降到原来的 1/25。
举一个真实例子。早期一版(v5)它打回两条必改:第 16310 帧 A→B 转场是硬切、帧间亮度阶跃 205;第 287 秒音轨有 1.4 秒死寂(-97.4 dB)接着新曲硬起。修复后复核,它给的结论是量化的:溶解段 37 帧、最大帧间阶跃 3.62(阈值 25);死寂段最低 -59.3 dB。v13 终轮验收,这套流程跑完,0 阻塞,直接通过。
但它会错,这一点必须说清楚。
有一轮它报了个问题:片子里写「大头榫」,它怀疑是「大头样」误写,建议核对或改通俗。我去查了代码——是「大头榫」,燕尾榫的匠作俗称,它把楷体字认错了。这条裁决结果是维持不改。这条记录现在还在清单的「分歧裁决记录」里。它提醒我一件事:Agent 的误判不是故障,是常态。所以「人拍板」这一层不是形式主义,是这套东西唯一真正的保险丝。
06 代价账
说完方法,说代价。这是做完之后从台账里抄出来的数:
- 全片渲染 31 次
,累计约 125,000 帧,实测单帧渲染 0.122 秒 定标静帧:2.0 阶段 13 次,v3 阶段 70 次 AI 出图:仅 1 张样张,约 5–10 积分——这是全片唯一一次为「画面」付的 AI 钱 音乐:0 分。没用 AI 生成,用 Wikimedia Commons 上的古琴录音(CC BY-SA 3.0,片尾已署名) 图片素材:Pexels 两轮检索,21 张候选选 11 张、第二批 9 选 3——网络现成图,0 出图分
中途有一次大返工:我列了一份 22 条问题清单,把前面几版的问题逐条写下来,按它重做了全部六幕。清单里既有「柱子在 3D 场景里要看起来垂直」,也有「树不许是纸片」「红叉改朱笔勾销笔触」这种。
重做比修修补补便宜——这是我这次学到的操作次序:先攒够问题,再一次性重做,不要修一次渲一次。
还有一笔账必须单独提:检察官 Agent 自己也要花钱花时间。它的旧版流程是逐张读 150+ 张帧图,一次验收几十轮工具调用,token 消耗大、耗时长,长到我自己中途打断过一次,要求「优化,太慢了,token 太多」。后来那版拼图抽查把它压了下来(读图 1/25、轮次约 1/5、用时从十分钟级降到分钟级)。这一版的提速细节和完整 token 账,下一篇(复盘篇)专门复盘。这里先埋个伏笔:Agent 不是免费劳动力,它的成本得算进总账。
07 收个口:整条流水线,哪些交给 AI,哪些留给自己
把前面六节串起来,这条线的骨架其实很清晰:
考据 → 分镜 → 出片(L2 用代码逐帧算)→ 验收(检察官 Agent 逐帧查)→ 修复 → 重渲 → 再验收
上一步的产出喂给下一步,这是一条流水线(pipeline)。流水线上有个固定的「人」节点:只在验收报告出来后做判定——这条改、那条不改、这条下版再说——不做执行。我把它设计成 人工在环(Human-in-the-loop,HITL):Agent 出片,Agent 检查,人拍板。
它没走「工作流(workflow)」那条路。工作流是步骤预先定死、节点自动流转、跑起来不需要人逐个拍板;而我每一步要修什么,取决于上一步验收报告打了几个 ❌,是个循环,循环里必须有人拍板。区别不在工具,在决策权留没留给人。
那什么该自动化、什么必须留人?这一条视频跑下来,分法很明确:
- 能写成客观标准的,全交给 Agent
:抽帧、目检、响度、压字、穿帮。这些有硬阈值,它比人稳,也省人。 - 写不成规则的,永远留人
:讲什么、删什么、这一版够不够好。这是判断,不是检测。 - 两边不一致,往上交,不往下压
:Agent 和我判断冲突时,整理成「分歧点 + 双方理由 + 可选项」交我裁决,绝不自己拍板。
(检察官 Agent「只读 + 写报告、不准改代码」的权限,就是为了守住这条线:一旦它能自己改,最后那点判断权就悄悄滑走了。)
「大头榫」那条正好是个注脚:Agent 会把楷体字认错,也提过我没采纳的建议。它能判定的,是有客观标准的东西(字号够不够、有没有静音、帧间有没有硬切);它判不了的,是取舍(这个典故值不值得占 4 秒)。所以最后那一层不该自动化——不是技术做不到,是做完了没人担。
完整正片《一座四合院,是怎么从平地站起来的?【四合院营造记】》(约 9 分钟)已上传 B 站,搜索「四合院营造记」即可找到,链接:https://b23.tv/Mbteij1 。文章里这 6 段小片,只是正片里挑出来的几截——想看「一根绳子怎么把房子拴起来」的全过程,去看正片。
## 附录 参考资料
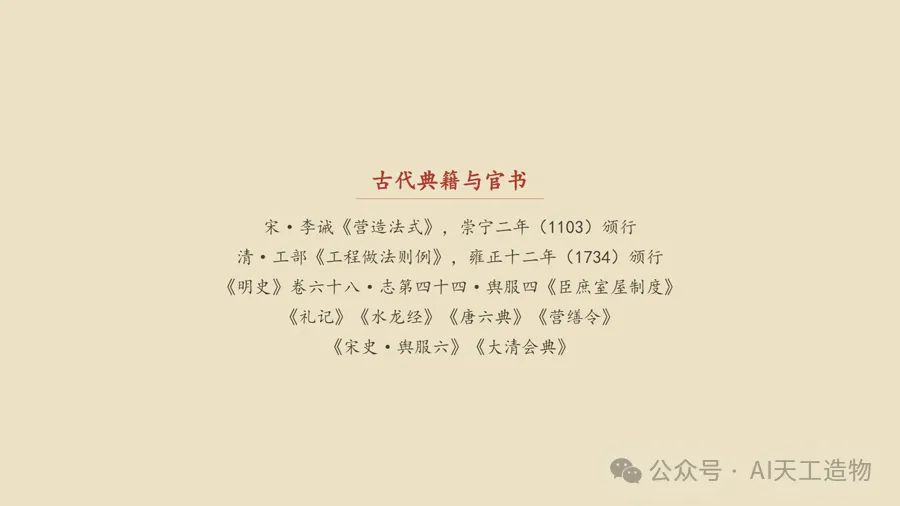
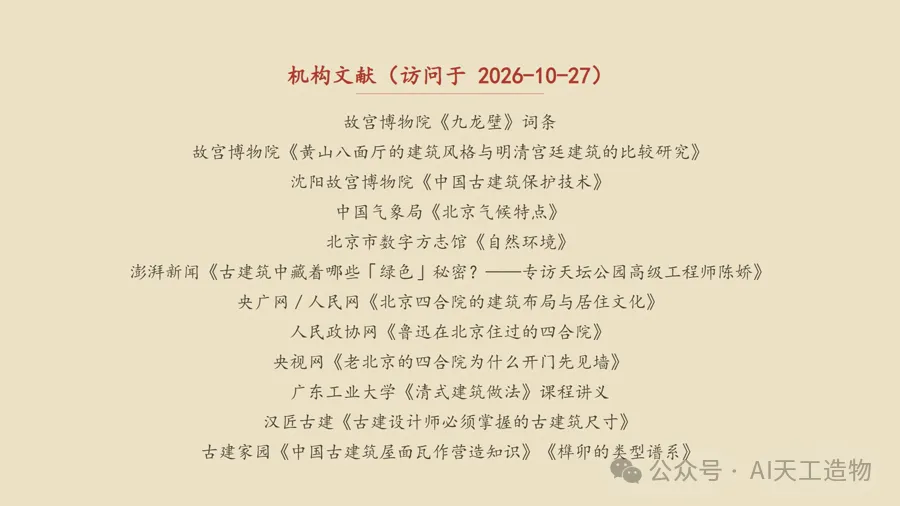
视频片尾把制作时翻过的史料一屏屏列了出来——每一处形制都指得回出处。这里把这两屏原文贴在文末,方便对照:
这次学到的一件事:把「检查」交给 Agent,「决断」留给自己,中间那道墙是权限——它不许改代码。能写成规则的让它全干(抽帧、目检、响度、穿帮),写不成规则的永远别交(讲什么、删什么、够不够好)。这不叫工作流,叫人工在环。
- 往期:Workbuddy开发日历记事:我说了一句话,它排出了三件事,全进了手机日历 —— 反过来的一次:不接大模型,规则引擎也能听懂一句话
- 往期:AI 视频制作-实测:WorkBuddy VS. Remotion,同一句提示词两条片 —— 本篇的理论前提:视频制作的三层,你要省什么决定你站哪层
*天工造物 · 用 AI 把一个个小麻烦做成能用的工具*
*名字取自《天工开物》。如果这篇帮你省了点时间,点个关注。*