ARTICLE · 1316325
4 张 Excel 合完,三分之二都是空的:问题出在表头
上一篇写的是:结构一样的 Excel,怎么合到一起。这一篇,轮到那个更让人挠头的问题——表头对不上,怎么办?
场站报上来的表,一个把场站写成“场站”,一个写成“场站名称”;第三个把日期叫“统计日期”,两列数值干脆没带单位。
打开第一张,改两个字;打开第二张,再改两个字。改完保存,关掉,接着开下一张。
我以前就是这么干的。
四个文件还行。二十个文件的时候,改到第七个,我已经记不清前面几个改成什么样了。
而且改表这件事有个问题:下次新表来了,还得再改一遍。
所以现在我不改原表了。差别不在“改不改列名”,在在哪改:原来的写法留在文件里,统一列名这件事,交给代码。
01|不处理表头,直接合,会怎么样?
我拿四个样例文件试了一下,直接用 concat 拼起来,结果是 12 列、26 行。
concat 可以理解成把几张表上下接起来。但它认的是列名:名字一样,才往同一列里放。
这四张表都有场站、日期、计划值、实际值四项核心数据,其中一张还多了一列备注。合完却变成了 12 列。
因为“场站”和“场站名称”被当成了两列,“计划值(MW)”“计划出力(MW)”“计划值”也各占一列。
每个文件只填自己那几列,剩下的位置就空着。
312 个格子里,211 个是 NaN,也就是缺失值。
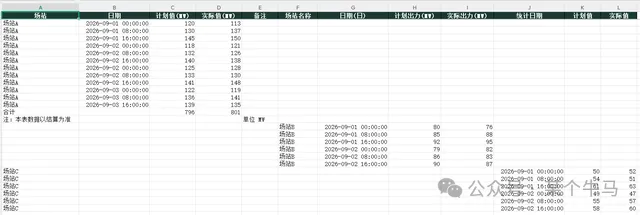
直接合并的结果
这种结果最麻烦的地方是:它不报错。
程序告诉你“合并完成”。你打开一看,表也在,数也在,只是三分之二的地方是空的。想找一个完整的计划值,还得在几列之间来回看。
看着合完了,核对的活儿一点没少。
这篇用的场站、日期和数值都是虚构的,表头差异按工作里常见的情况设计。上面这组数字,是样例实际跑出来的结果。
02|先体检,看看表头差在哪
后来我把这件事拆成了两步:
第一步不合并,只看表头;第二步用核对好的映射表,统一列名再合。
先把下面的代码保存成 check_columns.py。在脚本旁边建一个“待合并”文件夹,把要检查的 .xlsx 文件放进去。
如果还没装依赖,先在终端运行一次:
pip install pandas openpyxl下面的代码需要保存为 .py 文件运行,里面的 __file__ 才能找到脚本所在的位置。
# 第一步:合并之前,先看看这些表的表头差在哪# 输出:每个文件的列名、列数不一致提醒、一份建议映射表、会被丢掉的列# 需要:pip install pandas openpyxlimport pandas as pdfrom pathlib import PathBASE = Path(__file__).resolve().parentsrc = BASE / "待合并"# 要检查的 Excel 放这里files = sorted(src.glob("*.xlsx"))ifnot files:raise SystemExit(f"没读到 .xlsx:检查一下 {src} 里是不是空的")# ① 只读表头,不读数据 —— 文件多的时候这一步几乎是瞬间cols = {f.name: list(pd.read_excel(f, nrows=0).columns) for f in files}print(f"读到 {len(files)} 个文件\n")for name, c in cols.items(): print(f"{name}({len(c)} 列):{' / '.join(map(str, c))}")# ② 列数不一样要提醒:后面按位置对齐,列数不一致就可能错位sizes = {len(c) for c in cols.values()}if len(sizes) > 1: print("\n--- 列数不一致,按位置对齐可能错位 ---")for name, c in cols.items(): print(f" {name}:{len(c)} 列")# ③ 按列位置对齐,拼一份建议映射表(这是猜的,用之前请核对)base_name = files[0].namebase = cols[base_name]suggest = {}for i, std in enumerate(base): aliases = []for name, c in cols.items():if i < len(c) and c[i] notin aliases: aliases.append(c[i]) suggest[std] = aliasesprint(f"\n--- 建议的映射表(以 {base_name} 为基准,按位置对齐)---")print("COLUMN_MAP = {")for std, aliases in suggest.items(): inner = ", ".join(f'"{a}"'for a in aliases) print(f' "{std}": [{inner}],')print("}")# ④ 没进映射表的列,合并时会被丢掉 —— 这件事必须由脚本说出来mapped = {a for aliases in suggest.values() for a in aliases}dropped = []for name, c in cols.items():for x in c:if x notin mapped: dropped.append((x, name))if dropped: print("\n--- 下面这些列不在映射表里,合并时会被丢掉 ---")for x, name in dropped: print(f" {x}(在 {name})") print(" 要保留的话,往映射表里加一行")# ⑤ 导出一张对照表,留底rows = [{"文件": name, "列数": len(c), "列名": " / ".join(map(str, c))} for name, c in cols.items()]dst = BASE / "列名对照表.xlsx"pd.DataFrame(rows).to_excel(dst, index=False)print(f"\n已生成:{dst}")它跑完,除了生成一份 列名对照表.xlsx 留底,还会在屏幕上告诉我三件事。
第一,每个文件有几列,分别叫什么。
列数对不上的,会单独提醒。比如样例里那张多了“备注”的表,就有 5 列。
这件事要先看,因为下一步的建议映射表是按列位置对齐的。多出来的列如果插在中间,后面就可能对错位置。
第二,一份建议映射表。
COLUMN_MAP = {"场站": ["场站", "场站名称"],"日期": ["日期", "日期(日)", "统计日期"],"计划值(MW)": ["计划值(MW)", "计划出力(MW)", "计划值"],"实际值(MW)": ["实际值(MW)", "实际出力(MW)", "实际值"],}别被“映射”两个字吓住。它就是一张对照清单:左边写最后想用的列名,右边列出原表里可能出现的叫法。
比如这一行:
"场站": ["场站", "场站名称"]
意思是:原表里不管叫“场站”,还是“场站名称”,合并时都统一叫“场站”。
不过,这份建议是按位置猜的,用之前我都会自己核对一遍。
脚本能告诉我“第 2 列在这四个文件里有三种写法”,但“日期(日)”和“统计日期”是不是一回事,它不知道,我知道。
同样,没写单位的“计划值”,也要先确认本来就是 MW。这段代码只统一名字,不负责换算单位。
第三,哪些列没进建议映射表。
我的样例里是“备注”这一列。按当前映射表合并,它就不会被保留;如果你后面调整了映射表,还要按最终版本再核对一次。
这一步我很在意。脚本替你做的决定,必须说出来,不能悄悄丢。
03|用映射表统一列名,再合并
把下面的代码保存成 merge_with_map.py,和体检脚本放在同一个文件夹。
先把上一段打印出来的建议映射表核对好,再替换这里的 COLUMN_MAP。
# 第二步:用映射表把列名统一,再合并# 需要:pip install pandas openpyxl# 和上一篇那个合并脚本是同一件事,多了中间这一张映射表import pandas as pdfrom pathlib import PathBASE = Path(__file__).resolve().parentsrc = BASE / "待合并"# 要合并的 Excel 放这里out_file = BASE / "合并结果.xlsx"# 结果输出到脚本旁边# ① 映射表:左边是要统一成的标准列名,右边是这个位置上出现过的各种写法# 这一段可以直接用 check_columns.py 打印出来的建议,核对后粘过来COLUMN_MAP = {"场站": ["场站", "场站名称"],"日期": ["日期", "日期(日)", "统计日期"],"计划值(MW)": ["计划值(MW)", "计划出力(MW)", "计划值"],"实际值(MW)": ["实际值(MW)", "实际出力(MW)", "实际值"],}files = sorted(src.glob("*.xlsx"))ifnot files:raise SystemExit(f"没读到 .xlsx:检查一下 {src} 里是不是空的")frames = []skipped = []for f in files: df = pd.read_excel(f)# ② 按映射表改名:一个文件里可能同时有几种写法,取第一个命中的 rename = {}for std, aliases in COLUMN_MAP.items():for a in aliases:if a in df.columns: rename[a] = stdbreak df = df.rename(columns=rename)# ③ 缺列的文件不硬凑,单独报出来 —— 静默补空值是最难发现的一种错 missing = [c for c in COLUMN_MAP if c notin df.columns]if missing: skipped.append((f.name, missing))continue df = df[list(COLUMN_MAP)] # 只留标准列,多的(比如备注)先丢掉 df["来源文件"] = f.name # 出错时能回到原表核对 frames.append(df)if skipped: print("以下文件缺列,已跳过:")for name, miss in skipped: print(f" {name} 缺 {miss}") print()df = pd.concat(frames, ignore_index=True)# ④ 清洗:日期转 datetime,数值转数字,转不出来的行(表尾的合计、备注)丢掉df["日期"] = pd.to_datetime(df["日期"], errors="coerce")for c in ["计划值(MW)", "实际值(MW)"]: df[c] = pd.to_numeric(df[c], errors="coerce")before = len(df)df = df.dropna(subset=["日期"])print(f"清洗:丢掉 {before - len(df)} 行(日期列不是日期的行,通常是表尾备注)")df["偏差(MW)"] = df["实际值(MW)"] - df["计划值(MW)"]df.to_excel(out_file, index=False)print(f"合并 {len(frames)} 个文件,共 {len(df)} 行")print(f"已生成:{out_file}")这次跑完,屏幕上是这样的:
清洗:丢掉2行(日期列不是日期的行,通常是表尾备注)合并4个文件,共24行已生成:C:\...\合并结果.xlsx打开结果:6 列、24 行,一个空格子都没有。
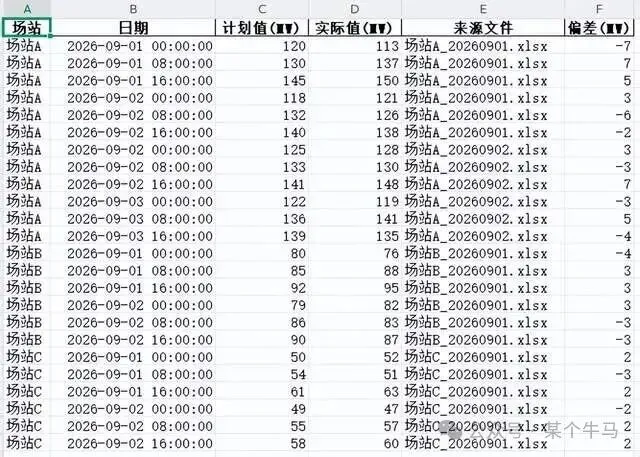
四项核心数据之外,多出来的两列,一列是“来源文件”——哪个数不对,能回到原表核对;一列是“偏差(MW)”——实际值减去计划值。
注意,“0 空值”是这组样例的结果。如果原表的数值本来就有缺失,或者写了转不成数字的内容,这段代码不会凭空把它补好。
照着样例用,主要改两处:文件夹不叫“待合并”,就改两个脚本里的 src;列名跟我的不同,就换成自己的映射表。
04|这几行,为什么放在这里?
如果你刚学 Python,先看懂下面三处,就能知道这段脚本在替你做什么。
为什么把各种叫法放进一张映射表?
直接写 df.rename(columns={"场站名称": "场站"}),当然也能改名。
但表一多,各种写法散在代码里,回头改起来容易漏。集中写成“标准列名:[多种写法]”,新叫法来了,就往对应列表里加一个字符串,处理流程不用跟着改。
还有个细节:同一张表里如果同时有几种叫法,这段代码按列表顺序取第一个命中的,不会把它们自动合成一列。这种表要先核对清楚。
缺列了,为什么直接跳过?
因为补空值很省事,也容易让问题混进结果。
现在 if missing: 这段会把缺少必要列的文件记下来,跳过,并告诉你“哪个文件缺哪几列”。看到提示,就回原表核对,别只盯着最后生成的结果。
如果所有文件都缺列,没有一张进入合并列表,后面的 concat 也会报错。这时先检查映射表和原表表头。
为什么按“日期”删行?
样例里有一张表,数据下面多了两行:一行写“合计”,一行写“注:本表数据以结算为准”。
pd.to_datetime(..., errors="coerce")会尝试把日期列转成日期,转不出来的记为 NaT。
后面的
dropna(subset=["日期"])再把这些行删掉。
所以这次少了 2 行,26 行变成 24 行。
这段代码删的是“日期转不出来的行”,并不只认“合计”和“备注”。 正式数据里的日期如果写错了,也可能被删。屏幕上打印了删除行数,记得回头核对是不是删对了。
数值列则不同:转不成数字会变成缺失值,但不会仅仅因为数值缺失就删掉整行。读代码时,要把这两件事分开看。
05|需求变了,改哪里?
要改什么 | 改哪里、留意什么 |
文件夹不叫“待合并” | 改两个脚本里的 src = BASE / "待合并" |
来了一种新的列名写法 | 在 COLUMN_MAP 对应的列表里加一个字符串,先确认含义和单位一致 |
想把“场站”改成“站名” | 把 COLUMN_MAP 左边的“场站”改成“站名”,右边保留原表写法 |
想改日期、计划值、实际值的标准列名 | 除了映射表左边的名字,后面清洗、计算中引用的列名也要同步改 |
想保留备注列 | 可以加 "备注": ["备注"],但当前脚本会把它也当成必要列,没有备注的文件会被跳过,不能只加一行就算改完 |
想查看缺列文件的问题 | 根据打印出的文件名和缺列清单,回原表核对;删掉 continue 不会自动补空列,后面选列时仍可能报错 |
不需要偏差列 | 删掉 df["偏差(MW)"] = ... 那一行 |
顺序我也建议照着来:先跑体检,看完清单,再决定映射表怎么写。
跳过第一步,凭印象写列名,很容易漏掉一个空格、一种叫法。先把差异摆在眼前,心里才有底。
原表不用挨个改了,但最后那遍核对,还得自己来——只有你知道,“日期(日)”和“统计日期”到底是不是一回事。
你手上最常见的是哪种情况:同一个意思换了名字,还是名字一样,里面装的却不是同一回事?欢迎在评论区留一组不涉及工作敏感信息的表头,说说你是怎么处理的。
下一篇想接着聊:表合完以后,怎么核对有没有漏数据、算错数。毕竟看到“合并完成”四个字,我现在还不敢直接交差。