ARTICLE · 1316803
vLLM-Omni 全双工源码再探:会话地位提升
全双工源码系列 · 第二篇。
客户端收到第一个音频包就开播,0.93 秒之后,声音会断一下。这次在 3 张 A800 上实测,从客户端 commit 到首音频,量出来的数字是 1.39 秒。两个数字,同一套系统。它们指向同一件事:全双工的时延,已经不能再用「请求进来、响应出去」那套口径去量了。
上一篇《vLLM-Omni 全双工源码初探》里,我把这套实现压成一句话:它不是「同时推理输入和输出」,而是用一个持续存在的请求,反复停车、续写 KV。
文章发出后,vLLM-Omni 先后发布了 v0.28.0 和 v0.32.0。两个多月过去,我把两个 tag 重新拉下来,对照源码,并在 3 张 A800 上跑了一组真实会话。这篇续集想回答一个问题:从「能跑」到「能运营」,中间到底补了哪些工程债?
五条结论
- 0.28 仍然是一套「实验目录里的全双工」:能证明持久 KV、epoch/fence、三阶段流水线可以工作,但 Stage 0 没有窗口、输出队列无界、默认只敢开 4 个 session。
- 0.30 是真正的分水岭:duplex 被移出 experimental/,统一成引擎内的会话框架。v0.32.0 的发布说明正文写的是 since v0.30.0,完整 changelog 是 v0.30.0...v0.32.0,不是从 0.28 算起。讲「0.28→0.32」必须把 0.30 的架构重构算进去。
- 0.32 最大的变化不是模型,是「会话所有权」:DuplexOmniEngine / DuplexOrchestrator / DuplexSessionManager /DuplexSessionRunner / DuplexEngineSession 拥有唯一会话状态,MiniCPM 退化成 DuplexModelPlugin。会话生命周期、并发、KV 窗口、取消、播放账本终于有了一个 owner。
- 长会话从「永不释放」变成「分层有界」,但只是分层有界:Stage 0 默认 basic 滑窗 8000/6000 token(源码默认,checkpoint 本身是 off),保留 system/ref 前缀;Stage 1 的 4096 上下文、audio encoder 的约 30 s 重建、Code2Wav 的 65 536 调度上限仍然是硬边界。「0.32 解决了长会话」不准确。
- 打断的语义没变,变的是取消之后的正确性:仍然是 epoch+1、abort 旧 request、换新 request id,旧 KV 不保留。0.32 补的是输出 invalidate、playback ledger、有界队列,让旧输出不再泄漏。
其余几条,放到正文里说。它们更适合有上下文的时候读:
首音频时延第一次有了同机、可解释的数字:A800 3 卡、V1、 max_sessions=4,C1 从真实语音结束到首音频 606–608 ms,C4 807 ms。前 0.4 s 是「用户说完到服务端开始处理」(口径见第七节,只能给区间),201/400 ms 才是服务端自己上报的生成耗时。并发的增量落在生成,不在前那一段。native duplex 经常在客户端 commit 之前就开始回答。本次 commit→首音频出现过 −1.39 s,拿它当响应时延会得到完全错误的结论。音频不是 20 ms 连续帧流:首包只有 120 ms,第二个 1 s chunk 在约 1.05 s 后才到。 0.32 没有重写 GPU 调度层。1 s unit、10 个 audio embedding、Stage0 每段最多 20 token、Talker 25+1、Code2Wav 25+3、native lane 只收 audio/vision append,这些核心约束都没变。 旧文章里「两个模型都 supports_barge_in=false」的结论已经过时:0.32 的 MiniCPM-o 4.5 明确声明supports_barge_in=True,但默认会话预设仍是overlap_policy=listen_only。能力存在,不等于默认会自动打断。
一、先把上一篇的骨架接上
没读过上一篇的话,三句话够用:
Stage 0 决定「这一秒听还是说」,Stage 1 把文本变成 codec,Stage 2 合成波形。三者以 1 s 为一个 model unit 调度。request 走完一段不释放 KV,停在那里等下个 chunk 来了接着写。被抢话时换 epoch、换 request id,旧 KV 直接丢。
上一篇的核心机制,今天仍然成立:
MiniCPM-o 4.5 以约 1 s 为一个 model unit,一个 unit 产生 10 个 audio embedding(100 ms 一个)。 用户说话和助手说话在模型层面是时分复用的;「边听边说」的并行主要发生在传输层:浏览器在助手播放时继续上传 PCM,这些 chunk 在服务端排队,到下一个 unit 边界才被消费。 scheduler 里有一个「停车态」:segment 停止时不释放 KV,request 进入 WAITING_FOR_STREAMING_REQ;下一个 audio chunk 到来后恢复RUNNING,在原 KV 后面续写。同一 epoch 内所有 append 共享 request_id,所以 KV 可以连续复用;模型自己生成的文本 token 也通过 decode 自然写进 KV,不需要额外搬运。 barge-in 时 epoch+1,request_id 变化,旧 request 被 abort;新 epoch 从空 KV 开始,不会回滚到打断前的位置。
这几条是地基。0.28 到 0.32 的变化,基本都发生在地基之上。
1 秒里到底发生了什么
把 1 s 音频拆开看,后面的所有时延都变好理解了。
输入是 16 kHz 单声道 PCM,1 s 正好 16,000 个采样点。但首窗不是整 1 s,而是 1.035 s:前面补 35 ms 零,保证 fbank 的边界;之后每个 unit 才是 1 s。
特征提取是 10 ms hop 的 fbank,1 s 约 100 帧;Whisper-style streaming encoder 的 CNN stride 2 把 100 帧压到 50 个位置,stride 5 pooling 再压到 10 个 embedding,每个对应 100 ms。也就是说,模型不是按 20 ms 帧在「听」,而是每 100 ms 得到一个音频 token,每 1 s 得到 10 个。
这 10 个 embedding 不是裸奔进 LLM:每个 unit 有 <unit> 开始标记,第一个之后的 unit 还有 </unit> 闭合;Stage0 每段最多生成 20 个 token、28 个字符,并在段内采样 <listen> / <speak> 决策。上一段采样出的 terminator 还要在下一个 unit 闭合前重新注入,否则模型会忘记自己上一段是决定听还是说。
Stage0 输出的不是音频,而是文本/控制 token。它们通过 decode 自然写进 block table;Stage1 Talker 再把文本/hidden 变成 25 个 codec frame + 终止符(26),Stage2 Code2Wav 用 25 帧 + 3 帧左上下文合成 24 kHz PCM。
所以 Stage0 的 KV 里只有两类东西:输入音频 embedding + 输出文本/决策 token。音频 codec 不在 Stage0 的自回归主链上,也就不占 Stage0 的 KV。
这也解释了首包为什么只有 120 ms:一个 unit 的 10 个 embedding 先过 encoder,Stage0 生成一小段文本,Talker 先吐一小段 codec,Code2Wav 先合成一个短 chunk;后面的 1 s chunk 要等下一个 unit。1 s 不是随手选的参数,它是 Stage0 的调度粒度,也是首音频和打断延迟的结构性地板。
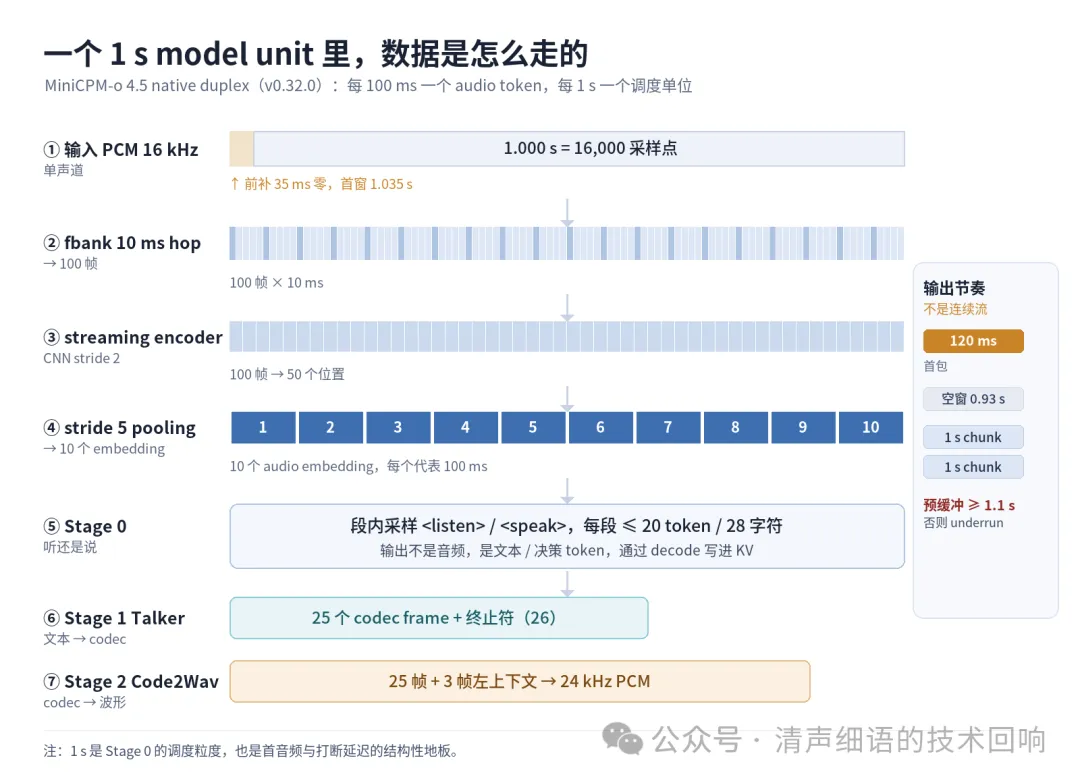
图 1:一个 unit 内部的数据走向,以及为什么首包之后必然出现约 1 s 的间隔。
二、0.28:证明「停车态」能跑,但它仍然是个实验品
0.28 的代码在 vllm_omni/experimental/fullduplex/ 下。结构是典型的「双平面」:
serving 侧的 DuplexSession管会话生命周期、turn 状态机、播放水位;DuplexControlPlane管 fence、租约、stage 绑定; 模型包通过 DuplexRuntimeExtension等契约接进来。
这套东西能工作,但边界很明确:
- Stage 0 没有对话窗口。resumable request 在 session 生命周期内不释放 KV,长对话线性增长,只能靠 max_model_len 兜底。
- 默认只开 4 个 session(shipping YAML;stage_config 默认 1)。Stage 1 的 gpu_memory_utilization是 0.15。
- 输出队列无界。慢客户端会把内存越堆越高,没有「当前 response 失败、其他 session 不受影响」的隔离。
- audio encoder 每个 session 一份
EncoderDecoderCache,大约 30 s 后需要重建;没有跨 session 批处理。 - 打断会 abort 旧 request,旧 KV 释放。语义上正确,代价是整段上下文一起丢。
所以 0.28 更像一张可行性证明:持久 KV、epoch/fence、三阶段流水线都能跑通,但离「可运营」还差几层。
三、0.30 的分水岭:会话成了引擎的一等公民
0.30 做了三件关键的事:
0.32 接着在这套框架上补齐生产化能力。最直观的变化是对象模型:
DuplexOmniEngine └─ DuplexOrchestrator └─ DuplexSessionManager └─ DuplexSessionRunner └─ DuplexEngineSession
MiniCPM 不再自己拥有一套 session,而是实现 DuplexModelPlugin:窗口策略、token 预算、listen/speak 决策、reference audio、stage0 数据面都收进模型插件;通用的 admission、lease、resume、playback、输出投递、指标留在引擎层。
这带来两个直接结果:
- 模型和运行时解耦:PersonaPlex 能无改动接入同一套 runtime,MiniCPM 的模型特有逻辑也不再散落在 serving 代码里。
- 会话终于有唯一 owner:0.28 时代「serving 和 engine 各有一份状态」的问题,在 0.32 被收敛到 DuplexEngineSession。
但要注意:这不是重写 vLLM 的 GPU 调度层。它仍然是在 vLLM request 之上叠一层会话控制面;1 s unit 和持久 KV 的核心约束没有变。
把两版放在一张表里:
experimental/fullduplex/ | engine/duplex/ | |
DuplexEngineSession | ||
basic | ||
gpu_memory_utilization 0.15 | ||
EncoderDecoderCache | ||
asyncio.Queue() | ||
commit_to_first_audio 386.80–1033.25 ms |
这张表最重要的不是「0.32 更多」,而是每一项都在回答一个可运营问题:会话谁负责、长上下文怎么办、慢客户端怎么办、打断后旧输出怎么办、SLO 怎么量。
0.30 的三件事也不是「搬目录」这么简单。移出 experimental/ 意味着这些接口要开始对外负责:模型插件怎么声明 token 预算、session manager 怎么分配 admission、stage port 怎么清理、输出怎么投递、resume 怎么校验。0.30 先把窗口做成 opt-in,0.32 再把 basic 改成默认。这是一条很典型的「先有机制、再改默认值」的演进路径。
四、长会话:从「永不释放」到「分层有界」
0.28 的 Stage 0 KV 是「session 活着就不释放」。0.32 默认启用 basic 滑窗:
高水位 8000 token,低水位 6000 token; 保留 system/ref 前缀; 超出窗口时,不是重新 prefill 全部历史,而是用 block-table 零拷贝加 K 的 Re-RoPE,把保留部分的 K 旋转到裁剪后的位置。
官方 PR 描述里,0.30 的 re-prefill 约 384 ms,0.32 的 K 旋转约 2.1 ms。这个数字不是本次实测,但方向很清楚:把「重建上下文」换成「改 KV 的索引和位置」。
不过,「0.32 长会话有界」必须分层看:
gpu_memory_utilization 0.15(1 GPU profile) | ||
EncoderDecoderCache,约 30 s 重建 | max_positions(约 30 s)后仍会重建 | |
这意味着:
- Stage 0 的旧历史会被滑窗裁掉。产品层如果要求「记得很早以前的内容」,必须自己做摘要/重开,vLLM-Omni 不会自动摘要。
- 窗口是 serving 侧的默认值,不是 checkpoint 的默认值:MiniCPMO45DuplexWindowConfig 的注释写明 checkpoint 自身是 off,是 serving 为了给长会话兜底才默认 basic(#8879)。客户端显式选 off 仍然能拿回全历史,代价是 KV 线性增长。
- Stage 1 仍然是 4096 上下文,它不是「无限长」的。
- 窗口只在同一个 request 的连续追加内生效。barge-in 换 epoch 后,旧 KV 仍然不保留,窗口救不回来。
本次没有触发窗口重建,也没有测「重建导致的首包 underrun」。这是下一步该补的实验。
五、并发从 4 到 16:数字背后是三件事
0.32 的 shipping YAML 在 1 GPU 上写的是 16 个 session;2/3 卡 profile 则是 4,因为每个 stage 的 max_num_seqs 和显存切分不同。本次 3 卡实验就是 max_sessions=4。
比数字更重要的是三件事:
- 有界输出:每个 session 的 pending output 默认 2 MiB / 512 events;溢出只失败当前 response 或关闭受影响 session,不拖垮其他 session。0.28 的无界 asyncio.Queue() 没有这个隔离。
- admission 是显式的:第 5 个 session 直接收到 duplex_session_capacity_exhausted: limit=4,不会悄悄把已有会话降级。
- 跨 session 批处理:audio encoder 的分页 KV 和跨 session batch,让多个会话可以共享 encoder 的 GPU 工作;Stage 1 的 batching 则直接体现在 TPOP 上。
实测 C4(4 路并发 × 3 批,共 12 个有效会话):
语音结束→首音频均值 807 ms; Stage 0 TTFT 从 C1 的 32 ms 升到 55 ms; Stage 1 TTFC 从 118 ms 升到 258 ms; 音频 max gap 1.05–1.09 s,和 C1 几乎一样; streaming RTF 0.974,仍然略快于实时。
并发的主要代价落在 Stage 1 的首包和 token 生成,不是落在「模型等静音」。 下面第七节把这 200 ms 拆开看。
六、打断:epoch 还是那个 epoch,但取消之后更干净
上一篇说「打断是支持的,但代价是丢掉那一整段上下文」。这句话仍然成立。
0.32 的链路是:
用户重叠语音 / 显式 barge_in ↓cancel append tasks + active response task ↓epoch += 1(原子 fence) ↓invalidate 旧 epoch 的未发送输出 ↓abort 旧 stage request ids ↓下一次 append 用新 request id、新 KV
落到具体对象上:
e | e+1 | |
和 0.28 相比,0.32 补的是「取消之后」的工程正确性:
已排队但未发送的 AudioDelta 被 invalidate; 已经 dequeued 的旧 epoch 输出也会被标记无效; playback.ack的 played_ms/committed_ms决定 history 截到哪里;输出队列有界,旧 epoch 不会无限堆积。
本次实测显式 barge_in:
3.1 / 3.3 / 4.1 ms 收到 response.done(status=cancelled)(旧回答已发 120 ms 音频);在 2.5 s 时打断、旧回答已发 2.12 s 音频,取消确认 4.3 ms; - 4 次测试里,取消 fence 之后旧 response 的音频包都是 0。
但有一个很容易误解的点:默认会话预设是 overlap_policy=listen_only。本次把 25.648 s 的追问直接叠在正在播放的回答上,得到的是 3 个完整 response、0 个 audio.cancelled。系统没有自动取消,而是把后续话排成新的回合。能力上 MiniCPM-o 4.5 在 0.32 已经声明 supports_barge_in=True,但要不要自动打断,仍然取决于会话策略/VAD 配置。显式发 barge_in 才会走硬打断。
还有一个不能回避的事实:旧 KV 不会回滚。新 epoch 从空 KV 开始,system/ref 前缀重新 prefill。想要「打断后继续同一上下文」,必须在 history 层自己重放/重建,不能指望窗口 KV 把旧记忆救回来。
七、实测 606 与 807:差的那 200 ms 在哪
口径比数字更重要
native duplex 不是「客户端 commit 之后模型才开始想」。本次实测里,模型经常在 2 s 尾巴还没放完时就已经开始回答;客户端 commit 反而落在 response.created 之后。于是 commit→首音频 会出现 −1.39 s 这种负值。
所以这篇续集统一用真实语音结束作为起点:
t_speech_end → t_response_created → t_first_audio → t_response_done ↑ 真实 WAV 播完 ↑ 首包已准备好,随即投递结果
环境:4×A800-SXM4-80GB,用 GPU 0/1/2;minicpmo_4_5_3gpu.yaml;Stage 0/1/2 各一卡;max_sessions=4;V1;temperature=0;basic 窗口;输入 5.469 s、16 kHz、200 ms 分片、按实时节奏,末尾补 2 s 静音。
response.created | ||
| 607 ms | 807 ms | |
close()session.closed |
表里两列的 created 和首音频只差 1 ms,不是笔误:response.created 事件发出后首包随即投递,两个打点本来就贴着。
先说明:这些是本次原创实测,不是公开发布基线,无法通过 release notes 独立证实或证伪;它们只对这套硬件/commit/配置/素材成立,不能直接外推成通用 SLO。原始事件 JSON 和探针脚本在文末列出。
另外做了一次 5 路尝试(记作 C5):第 5 个会话在握手阶段被拒绝(duplex_session_capacity_exhausted: limit=4);已接入的 4 路语音结束→首音频 819 ms,和 C4 同一量级。
拆解
C1 的 607 ms 可以拆成两段:
- 约 405 ms:用户说完到服务端开始处理。里面可能包含模型结束判定/静音等待,也混杂着客户端上报和时钟对齐的误差,本次没有单独的 trace 能把它拆干净。
- 约 201 ms:服务端从接受 append 到首输出。其中 Stage 0 TTFT 32 ms、Stage 1 TTFC 118 ms,剩下约 51 ms 是 stage handoff、调度和 Code2Wav 首包。这一段是服务端自己上报的,可信度高一个量级。
这里的 405 ms 是用客户端「语音结束」与服务端 append 打点相减得到的近似,不是逐段 trace;201 ms 才是服务端自己上报的指标。两者时钟来源不同,所以这个拆分只能解释量级,不能当逐段归因。
更保守的说法是:约 0.4 s 花在「用户说完」到「服务端开始处理」之间,但这 0.4 s 里面还混着客户端上报延迟、时钟对齐误差和打点粒度,未必全是模型在等静音。 真正的结束判定耗时,需要服务端自己打一条「最后一次 append 到达」到「第 N 个静音 unit 判完」的 trace 才能给准。本次没有这条 trace,所以只能给区间,不能给点值。
不过有一个结论不依赖这个拆分:C4 的端到端只比 C1 多 200 ms,而这 200 ms 里可归因的部分全在服务端指标上(Stage 0 TTFT 32→55 ms、Stage 1 TTFC 118→258 ms)。也就是说,不管你信不信那个 405 ms,并发的增量都没有落在「等静音」这一侧。
C4 的 807 ms 则是:
前半段仍然在 0.4 s 量级,和 C1 同一水平; 服务端首输出从 201 ms 涨到 400 ms:Stage 0 TTFT 32→55 ms,Stage 1 TTFC 118→258 ms。
也就是说,4 路并发的代价几乎全部落在 batching 后的生成,不是落在模型「等静音」的 0.4 s。 如果你的优化目标是压首音频,优先看 Stage 1 首包和 stage handoff,而不是去改结束判定。
冷启动和 audio cadence
服务器启动后的第一个会话,语音结束→首音频 6087.8 ms;此后同一服务上的会话是 606–608 ms。第一个会话不能计入稳态 SLO。
4 路也有类似的坑:只做 1 路 warmup 后立刻跑 4 路,第一批是 2924–3392 ms;按 4 路 warmup 后是 780–828 ms。warmup 必须匹配目标并发度,否则会把 batching/图捕获冷启动误算成并发退化。
音频节奏也不是「连续流」:
每个 7.72 s 回答被切成 9 个 chunk; 首包只有 120 ms; 第二个 1 s chunk 在 1.05 s 后才到; 之后基本 1 s 一个 chunk; 长期 RTF 0.974–0.982,生成略快于播放。
如果客户端一收到首包就开播,约 0.93 s 后会 underrun。要么预缓冲 ≥1.1 s,要么接受首段欠载。 这是 1 s model unit 的结构性结果,不是网络抖动。
五个容易误读的点
第一,「0.32 重写了 GPU 调度层」。 没有。它重写/收拢的是会话控制面:session 谁拥有、KV 窗口怎么裁、输出怎么投递、取消怎么 fence。vLLM 的 scheduler 仍然是那个 scheduler,只是多了 resumable 停车、窗口重建、duplex sampling 这些钩子。
第二,「supports_barge_in=True 就会自动打断」。 不会。能力位只说明模型/运行时支持这条命令;本次官方预设仍是 overlap_policy=listen_only,叠流不会取消在播回答。要硬打断,显式发 barge_in,或者配置带 barge_in_on_speech 的 VAD。
第三,「C4 延迟翻倍,说明并发线性退化」。 不是。C4 只比 C1 多了 200 ms,而这 200 ms 能归因的部分全在服务端指标上(Stage 1 TTFC 118→258 ms),前半段仍在 0.4 s 量级。换句话说,并行度增加时,模型「等你说话」的成本基本没变,变的是生成首包的排队与批处理。
第四,「commit→首音频才是真实响应时延」。 在 native duplex 里,模型经常在 commit 之前就开口;本次 commit→首音频 出现过 −1.39 s。commit 只是客户端封口,不是「模型开始思考」的时刻。要么用「真实语音结束」,要么明确写清 commit 口径,不能混着比。
第五,「首包 120 ms 就能立即播放」。 不能。第二个 1 s chunk 要等约 1.05 s;首包只是「先给你 120 ms 的甜头」。播放器要么预缓冲,要么接受一次 underrun。
还有一个失败样本值得记录:把整段音频不按实时节奏一次性灌进去,探针得到的是 response.listen,不是回答。这不能当作「积压时延」。native duplex 依赖 1 s unit 和静音边界,非实时灌流需要另设 flush/等待策略,否则测到的是自己的输入方式。
八、哪些结论没有变
版本演进很容易让人产生「全都换了」的错觉。实际上,以下约束在 0.28/0.32 都没变:
1 s model unit,首窗 1.035 s,前置补 35 ms 零; 1 s 音频 → 100 帧 fbank → Whisper streaming encoder → 50 个位置 → stride-5 pooling → 10 个 audio embedding; Stage 0 每段最多 20 token、28 字符; turn_eos不是 stop;Talker 25 个 codec frame + 终止符(26);Code2Wav 25 帧 + 3 帧左上下文 → 24 kHz PCM; prefix caching 关闭;native lane 只收 audio/vision append,不接受边说话边追加文本; Stage 0 KV 里是「输入音频 embedding + 输出文本/决策 token」,不是音频 codec; barge-in 用新 request,旧对话 KV 不保留; 服务端不按实时节流输出,客户端必须自己缓冲。
所以 0.32 不是「换了一代模型」,而是「把同一套时分复用模型塞进了一个更可运营的会话系统」。
九、选型与工程清单
如果你正在做选型,我会这样建议:
新部署、要并发/长会话/可观测性:选 0.32。
用 0.32 的 engine-owned session 和 bounded output; 用 basic窗口,接受「旧历史会被裁掉」;用显式 barge_in或带barge_in_on_speech的 VAD,不要假设默认listen_only会自动打断;用 4 路/16 路目标并发做 warmup,再测 SLO。
旧环境、短会话、低并发:0.28 仍可用。
但要接受:4 session、Stage0 无窗口、输出无界、取消正确性弱、旧音频可能泄漏。
要低时延:
先区分「语音结束→首音频」和「commit→首音频」,不要用后者做 SLO; 优化 Stage 1 首包和 handoff,而不是只盯 Stage 0 TTFT; 客户端预缓冲 ≥1.1 s; 如果首音频必须 <200 ms,当前 1 s unit + 25 帧 Talker 的算法下限不满足,需要更小 unit 或流式 codec。这不是换个 YAML 能解决的。
要长会话:
用 0.32 的 basic 窗口; 监控 Stage0 KV、Stage1 KV、audio encoder cache、Code2Wav batch; 产品层自己做摘要/重开,不能指望 runtime 自动压缩; 记住:窗口只在同一个 request 内生效,barge-in 后仍然从空 KV 开始。
要打断后继续同一上下文:
两版都不支持「原地回滚 KV」; 在 history 层保留已 committed 的文本/音频,新 request 重新 prefill; 或者接受「打断即新话题」; 不要把 window_kv当回滚机制。
十、结语:持久 KV 是地基,0.32 补的是门、锁和消防通道
上一篇的结尾是:全双工的难,一半在模型怎么听和说,一半在让模型在持续上下文里记住自己的话,又能在被抢话时干净利落地丢弃该丢的那部分。
两个月后,这个判断没有变,只是 0.32 把这层基础设施做得更完整了:
会话有了唯一 owner; Stage 0 KV 有了窗口; 并发有了 admission 和背压; 取消有了输出 invalidate 和 playback ledger; 时延有了可以拆解的数字。
但 0.32 没有变魔术:1 s unit、Stage 1 的 4096 上下文、audio encoder 的约 30 s、barge-in 不回滚 KV,这些边界还在。它把「能跑」做成了「能运营」,但离「任意长、任意并发、任意打断」还有距离。
如果下一篇继续写,我想追三个问题:
- 窗口重建:basic 窗口在真实长会话里什么时候触发,首包会不会 underrun?
- 多 session 的 p99:本次 C4 是 12 个会话,16 路/1 GPU 的尾延迟还没测;
- 多节点:MiniCPM 的 resume 与 multi-frontend lease 冲突,跨节点会话迁移还没有生产级答案。
附录:本文源码坐标
32:vllm_omni/engine/duplex/session/engine_session.py:1039-1082 | |
32:vllm_omni/model_executor/models/minicpmo_4_5/duplex/window_kv.py:751-925 | |
32:vllm_omni/model_executor/models/minicpmo_4_5/streaming_audio_encoder.py:205-312 | |
32:vllm_omni/engine/duplex/session/runner.py:1134-1209 | |
32:vllm_omni/engine/duplex/delivery.py:61-150 | |
32:vllm_omni/deploy/minicpmo_4_5_3gpu.yaml:10-16 | |
32:vllm_omni/model_executor/models/minicpmo_4_5/duplex/capabilities.py:19 | |
32:docs/design/fullduplex.md:101-231 |
basic_window_high_tokens=8000、 low=6000:32:vllm_omni/model_executor/models/minicpmo_4_5/duplex/policy.py:24-26,可被 sessionextra_body覆盖;DEFAULT_MAX_NEW_SPEAK_TOKENS_PER_CHUNK=20、 DEFAULT_MAX_SPEAK_CHARS_PER_CHUNK=28:同文件:98-99;输出 2 MiB / 512 events:32:vllm_omni/config/stage_config.py:680-681;Code2Wav 65 536:32:vllm_omni/deploy/minicpmo_4_5_3gpu.yaml:87-96的max_num_batched_tokens/max_model_len/max_tokens,是调度与长度配置,不是 KV 容量。
max_sessions=4、5.469 s 中文输入、temperature=0 这一组条件。原始事件 JSON 与探针在 bench/results/、bench/duplex_bench.py、bench/bargein_probe.py,应在相同环境复现,不应直接外推成通用 SLO。eb11446)与 v0.32.0(5917730);上一篇的基线是 2026-08-20 的 main(718d9a4)。实测:A800-SXM4-80GB ×3,Stage 0/1/2 各一卡,max_sessions=4,V1 引擎(不是 MRv2 那条多副本部署路径);没有 0.28 同机 A/B。