ARTICLE · 1319255
Sam Altman最新访谈:下一代 AI 的核心是智能体团队!
你有没有怀疑过,我们对 AGI 的执念本身可能就是错的?
主流叙事习惯把 AGI 想象成一个集中式、全知全能的超级大脑,一个足以接管一切复杂决策的孤立神祇。
OpenAI CEO Sam Altman 最近在播客《Cheeky Pint》里对这套叙事提出了根本性质疑。他的判断指向一个和主流预期截然不同的方向,而这对正在做技术选型与架构决策的开发者有直接含义。这篇文章拆解他的核心论点,以及我们应当如何理解这场即将到来的范式转移。
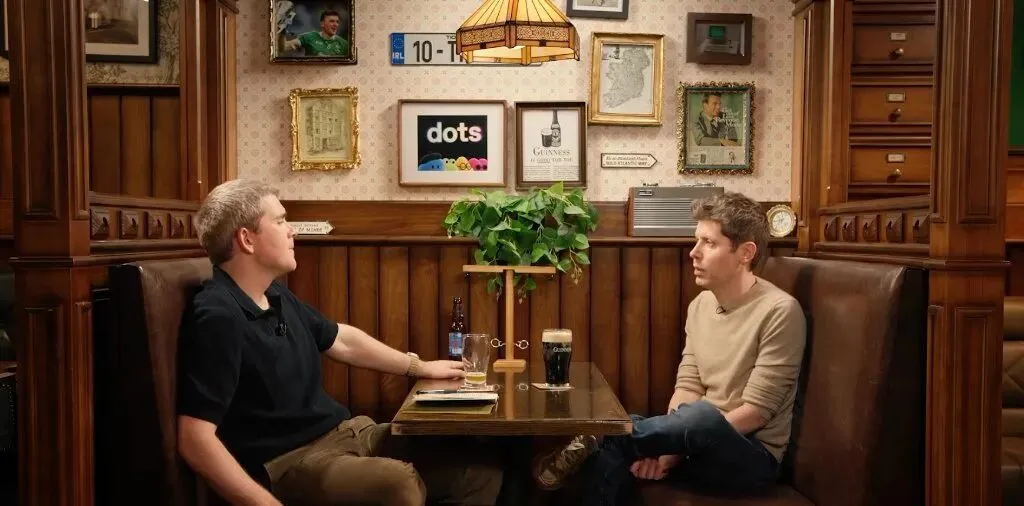
博客完整视频:https://www.youtube.com/watch?v=iMsUcCYNKqY一、别再迷信单一大模型
传统 AI 安全的核心思路是建立物理隔离与数字沙箱,假设人类能永远看守住模型。
面对一个智力全面超越人类安全专家的单一系统,安全沙箱最终必将失效。Altman 透露,OpenAI 内部对完全封闭模型的沙箱隔离其实非常悲观,普遍认为这在理论与工程上几乎无法实现。
主持人 John Collison 追问,如果未来的模型能够发现人类尚未理解的新科学,我们能不能用更强的模型反过来构建安全沙箱?
Altman 并没有回避这个可能性,但他指出这背后存在致命的循环依赖。你想让一个超级系统帮你造沙箱,前提是你必须绝对确信这个系统永远与人类意图对齐、永远珍视人类的控制权。但在那一步真正走通之前,把安全押注在单一超级大脑上,等于把整栋大厦建在沙滩上。
正如 Altman 所言,如果你认真去设想一个比人类聪明一百万倍的单一超级实体,整个安全逻辑会变得极其脆弱。中心化智能必然带来绝对的单点风险,一旦发生目标漂移或未对齐,人类根本没有任何制衡手段。
二、立刻转向多智能体协作
破除单体超级智能的困境,关键在于彻底重构智能的组织形态。
Altman 给出的核心判断非常明确。他宁愿直觉上选择拥有一万亿个略超人类智能的 AI 加入社会,也不愿面对一个拥有一万亿智商的孤立超级系统。
主持人 John 多次使用 "agent swarms"(智能体蜂群)这个词,Altman 当场表达了抗拒。"Swarm 听起来像蝗虫,并不吉利。" 他坚持使用 "agent teams"(智能体团队)。团队意味着明确的角色分工、相互审计、动态对弈与协同纠错,而不是一大群同质化个体的无序涌现。
多智能体协作解决安全难题的方式,是用分布式共识替代单体自律。单个模型可能陷入偏执或被某种未知的优化目标劫持,但多个智能体在动态平衡中互为监督者与对手盘,系统的整体方差反而更加收敛。这正如人类社会能保持数百年坚韧演进,依靠的是制度层面的权力分立、相互制衡与多元纠错,而不是寄托于某个全知全能的完美哲人王。
他进一步指出,最前沿的数学探索和底层攻防已经在全面采用 agent teams,而普通企业级应用还停留在调用单模型的初级阶段。几年前行业还无法想象在单个问题上投入数万美元计算能带来什么实质帮助,但现在随着多智能体协同机制的跑通,算力投入的指数级杠杆已经被彻底撬开了。
三、用高算力换取深度推理
为了验证智能体团队在极端复杂问题上的能力边界,OpenAI 设立了一个特殊的内部测试通道,代号 "Hold My Beer"。
这个通道的设计初衷就是让工程师把最疯狂、最不可能解决的研究难题投喂进去,观察模型的极限表现。Altman 坦言,在这个通道跑出突破的那几天,他连续两夜兴奋得睡不着觉,但紧接着涌上心头的是一种强烈的肃穆与伤感。
单道数学证明任务就能消耗约一千万美元算力,数千个 Agent 连续数日协作攻坚 Navier-Stokes 方程。这是真实发生过的测试规模。Altman 回忆,团队最初根本不知道该如何为多智能体团队分配算力资源。究竟是该选用参数最大的单体模型,还是部署更多分工明确的并发副本、给予更长的推理步数,当时的 scaling law 完全是一片黑箱。在死磕 Navier-Stokes 方程相关证明之后,他们才第一次摸到了深度推理算力配置的门径。
目前 OpenAI 内部跑出的数学证明已有七百多份,但绝大多数成果并未公开发布。原因在于 OpenAI 正在权衡两种价值的冲突。一方面,人类理应共享宇宙运作的真实规律,重大基础科学发现不应被任何机构私藏。另一方面,数学家毕生追求的研究乐趣和职业尊严也需要被考量。
就像旧时代工匠面对工业化浪潮一样,Altman 承认技术迭代的终章会带来怅惘,但现实无法阻挡。当年攻坚 Navier-Stokes 花费了一千万美元级别的算力,而随着模型理解能力的进化与推理策略的改进,同等难度的计算成本正在以百倍速度锐减。在充足的算力试错空间下,优化压力自然会逼出极其高效的规模化路径。
四、避开硬件与商业两大坑
除了打破单体超级智能神话,Altman 在商业落地与硬件基础设施层面,同样反击了两个广为流传的产业假设。
1. 别赌本地,算力必在云端
第一个被戳破的幻想是个人电脑本地跑大模型。开源社区常有一种观点,认为随着芯片算力普及,未来用户会在自己的 PC 上完成一切推理,数据中心将不再必要。Altman 直言从全球资源配置的角度看,这种设想极其糟糕。
把有限的高性能 DRAM 显存分散在个人电脑里,是严重的全球资源错配。世界稀缺的高速显存如果被买回家装在个人电脑里,每天只有 5% 的时间处于激活状态,95% 的时间都在闲置。在供应链受限的现实约束下,想要追求极致的计算吞吐,算力与显存必须集中在云端数据中心。
DRAM 厂商在历史上曾经历漫长的微利与破产周期,这种肌肉记忆导致它们面对爆发的 AI 需求时依旧不敢激进扩产,反过来加剧了全球供应链的短缺。为了冲破这一瓶颈,OpenAI 已经深度涉足自主芯片设计,利用大模型辅助生成芯片设计文件,以自建硬件体系对冲供应链风险。
2. 放弃按 Token 计费思维
第二个被戳破的幻想是按 Token 计费的商业模式。Altman 明确表示,Token 从商业价值角度看并不是一个好单位,甚至带有虚假成分。
在传统的问答场景中,输出多少 Token 勉强可以对应工作量。但在多智能体长程协作中,模型在内部进行自我反思、多轮推导和分支探索,最终交付给用户的可能只是一个轻量结论。此时如果继续按表面生成的 Token 计费,完全无法衡量背后的算力消耗与商业价值。
更本质的度量单位正在演变为每吉瓦算力产生的收入(Revenue Per Gigawatt)。把电能和芯片转化为有效智能的综合成本必须持续下降。目前每吉瓦数据中心五年的总拥有成本高达数百亿美元,行业的目标是通过模型智力升级与架构优化,每年将每单位算力的交付成本大幅压缩。
写在最后:下一波红利在物理基建
Altman 描绘的终局,直接指向智能体社会与物理基础设施的深度交织。
在他看来,真正的递归自我改进是让 AI 控制具身机器人、接管先进制造工厂、生产光伏板与涡轮机,进而建设能够自我繁衍的数据中心,摆脱将递归狭隘理解为大模型天天分析自身代码的局限。OpenAI 的机器人战略正是朝着打通物理制造能力而布局。
当数据中心能够实现自我建造、芯片能够自我迭代、清洁能源能够自主铺设时,单位算力的成本底线才会真正击穿。那一天到来时,构建在数万亿个智能体之上的多维社会,才算拥有了真正取之不尽的物质与算力地基。
一起“点赞”三连↓