ARTICLE · 1319430
AI 已经能拼出完整浏览器利用链
从 V8 堆破坏到 Chrome 沙箱逃逸,防守方如何建立可验证的证据门禁
真正改变安全流程的不是 AI 能让程序崩溃,而是它开始把多个局部缺陷组合成跨越安全边界的、可验证的攻击路径。
一次崩溃,离接管系统还有多远
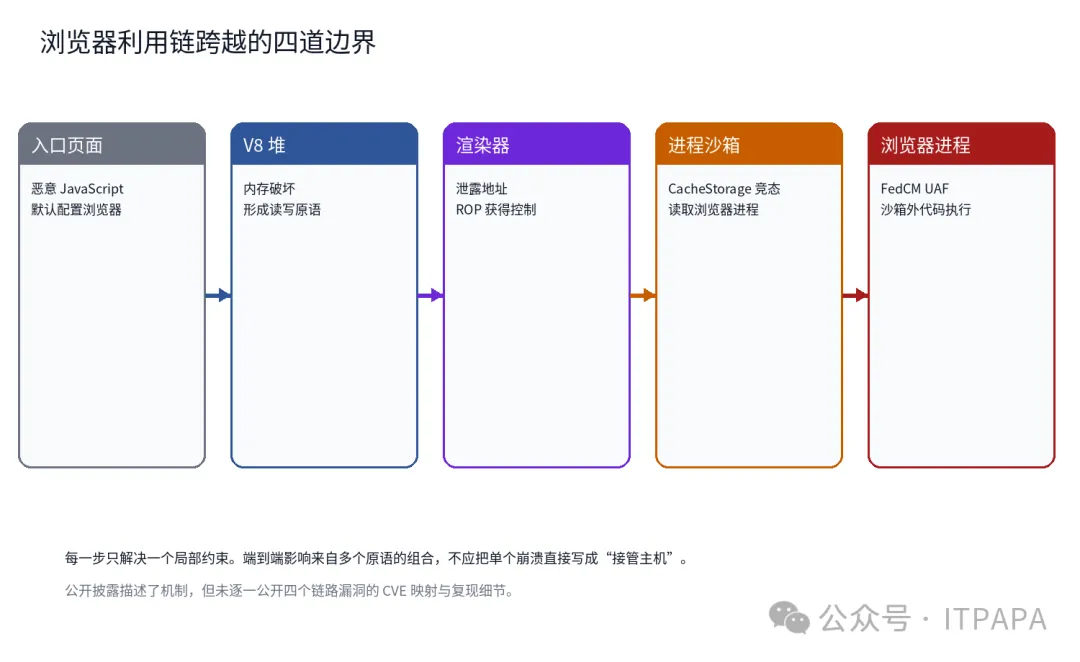
2026 年 10 月 27 日,Anthropic Frontier Red Team 披露了五条由内部研究模型辅助完成的真实软件攻击链。最受关注的一条针对 Chrome:从恶意网页触发 V8 堆内存破坏开始,随后越过 V8 内存区域沙箱并绕过 ASLR,在渲染器进程内构造 ROP 链;接着利用 CacheStorage 竞态读取高权限浏览器进程的内存布局,最后借助 FedCM 的 use-after-free,在 Chrome 进程沙箱外执行代码。
Anthropic 表示,其 macOS 默认配置下的概念验证会在页面加载后数秒内启动 Calculator,无需再次点击;截至 Chrome 156,相关研究累计获得 62 个 CVE,均为高危或严重,其中包含 13 个沙箱逃逸和 21 个可用于攻陷渲染器的漏洞。Google 的 Chrome 156 稳定版公告则确认 156.0.8078.47/.48 于 10 月 20 日发布,并包含 354 项安全修复。
这里必须把证据边界说清楚。62 个 CVE 是 Anthropic 对整个 Chrome 研究项目的汇总,不等于这条四阶段利用链恰好由 62 个漏洞组成;公开文章也没有把链路中的 V8、CacheStorage 和 FedCM 缺陷逐一映射到具体 CVE。Chrome 公告会在大多数用户完成升级前限制部分缺陷详情,因此外部读者目前能够核查的是攻击链机制、修复版本和部分报告者记录,无法独立复现整条利用链。
核心判断安全团队不应把“AI 找到一个 crash”当成影响结论。必须用逐级证据证明根因、利用原语、边界突破和端到端影响,并在每一级保留可复核材料。
浏览器不是一个进程,而是一组相互约束的安全域
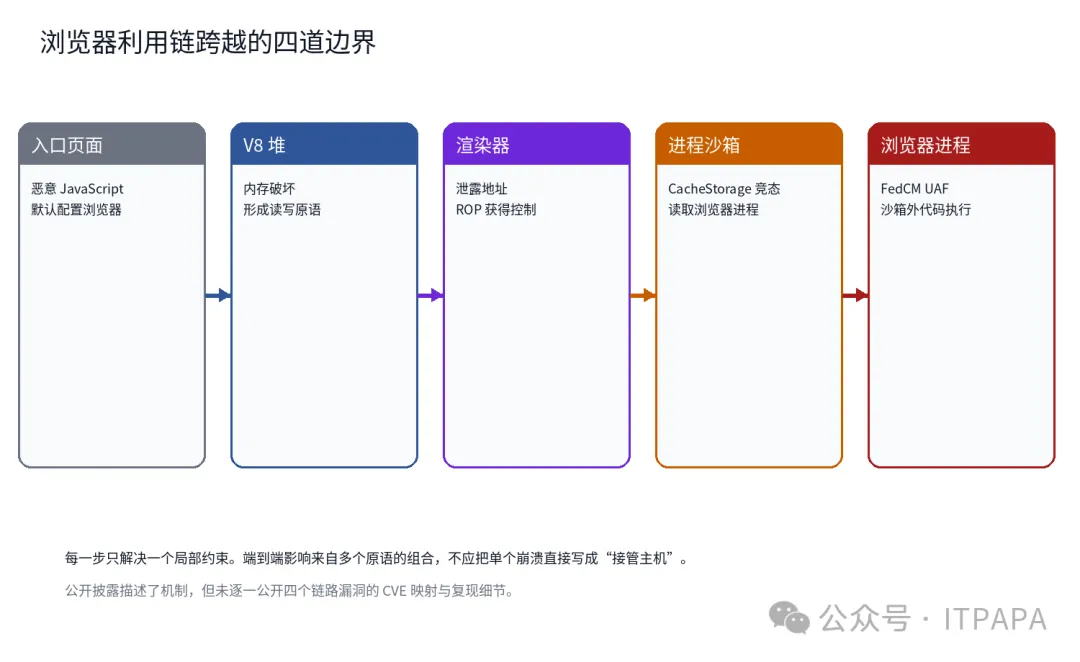
图 1Chrome 利用链依次越过语言运行时、渲染器和浏览器进程边界。
第一段:从 JavaScript 行为到 V8 堆破坏
网页脚本首先进入 V8。若 JIT 优化、对象表示、边界检查或对象生命周期出现错误,攻击者可能让引擎在错误的地址读写。一个 sanitizer 报告或崩溃只能证明程序走到了非法状态;要进入利用链,研究者还要说明哪些字节可控、读写范围多大、对象布局是否稳定,以及垃圾回收和编译优化会不会改变结果。
第二段:越过 V8 沙箱并控制渲染器
现代 V8 用内存区域隔离和指针压缩等机制限制引擎内存错误的影响。即使获得 V8 堆内读写,攻击者仍需找到能访问沙箱外地址或泄露代码地址的路径。Anthropic 的披露称,第二个缺陷同时用于越过 V8 沙箱和击败 ASLR,随后用 ROP 控制渲染器。这里的证据重点不是“能覆盖一个指针”,而是地址泄露、可复用 gadget、控制流稳定性与平台版本是否同时成立。
第三段:渲染器控制不等于系统代码执行
渲染器负责解析不可信网页,按设计被操作系统级进程沙箱限制。一个成功的 renderer exploit 通常仍不能随意读取用户文件、调用高权限浏览器接口或启动本地程序。攻击者需要额外的 IPC、共享内存、服务端点或浏览器进程漏洞来跨越边界。
第四段:信息泄露与内存破坏配合完成逃逸
公开机制显示,CacheStorage 竞态先从高权限浏览器进程泄露内存布局,FedCM 的 UAF 再提供控制路径。这个顺序很典型:内存破坏负责改写状态,信息泄露负责对抗 ASLR,安全域之间的合法 IPC 则成为触达高权限对象的通道。单独看,每个缺陷的影响可能有限;组合后才形成沙箱外代码执行。
把漏洞结论拆成五级证据
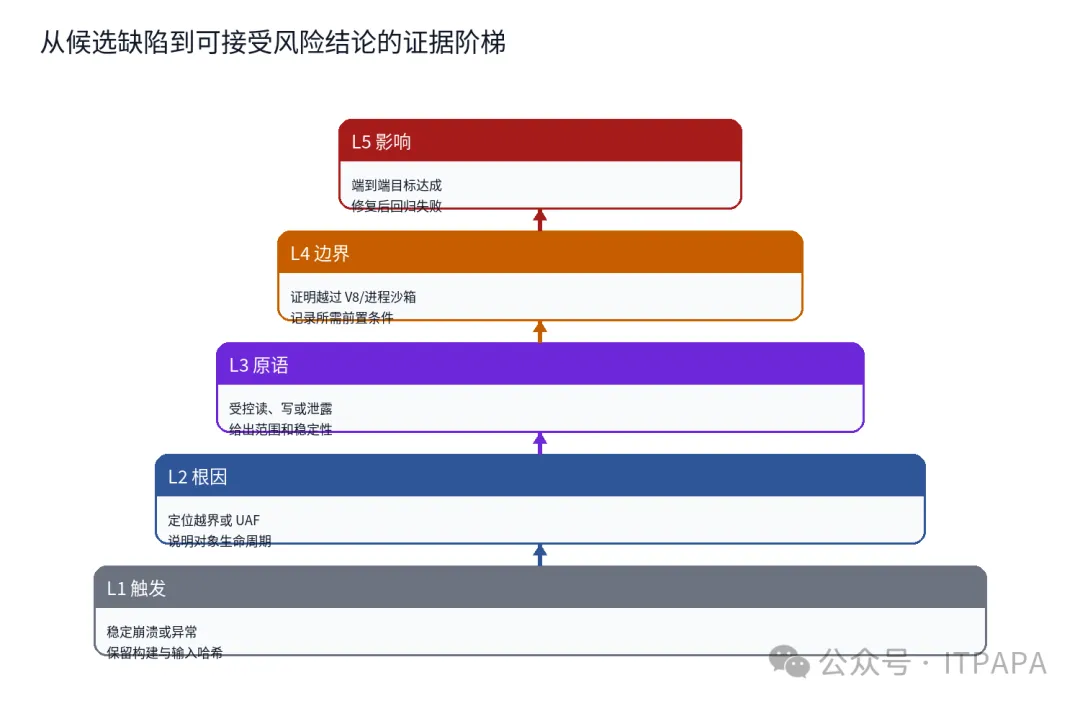
图 2每上升一级,都要新增证据,不能用高一级结论倒推低一级事实。
级别 | 可接受的事实 | 必须保留的证据 | 不能直接声称 |
L1 触发 | 固定环境可稳定出现崩溃、异常或策略违例。 | 目标 commit、构建参数、输入哈希、stderr、core 或 sanitizer trace。 | 远程代码执行。 |
L2 根因 | 确认越界、UAF、类型混淆或授权缺失的代码路径。 | 最小触发器、对象生命周期、补丁或 bisect 结果。 | 任意读写。 |
L3 原语 | 可控读、写、地址泄露或对象伪造在统计上可复现。 | 可控位、范围、成功率、失败模式、平台约束。 | 越过沙箱。 |
L4 边界 | 原语能突破一个明确的安全域。 | 边界前后权限、IPC 路径、审计日志与隔离环境结果。 | 主机完全失陷。 |
L5 影响 | 端到端目标在限定条件下达成,补丁后不可达。 | 隔离 PoC、录像或遥测、补丁差分、回归测试、独立复核。 | 对所有版本普遍适用。 |
这套分级能解决两个常见问题。第一,扫描器会大量产生“像漏洞”的候选结果,若没有确定性复现,PSIRT 很快被噪声淹没。第二,安全报告常把 CVSS、漏洞类型和最坏影响混在一起,导致修复团队不知道当前证据究竟走到了哪一步。分级后,研究者可以继续升级证据,业务团队也能按已证明的边界安排优先级。
AI 为什么开始能做多阶段利用
多阶段利用不是一次生成一段 PoC。它更像一个持续的实验循环:读取代码与二进制,提出假设,构建目标,运行触发器,解释崩溃,修改利用策略,再根据新观察寻找下一道边界。大上下文、工具调用和长时间状态保持,让模型可以把过去需要多位研究员手工衔接的步骤放进同一任务轨迹。
Anthropic 描述的平台会并行运行多类扫描代理,包括覆盖导向、目标导向和威胁模型导向策略;对确认结果再做变体分析,并统一进入验证和风险分级流水线。它还明确指出,独立人工分诊是当前限速环节。11 月 2 日更新的协调披露看板显示:37,966 个候选中,6,376 个进入外部公司评审,6,009 个被评审,1,862 个获确认;看板同时提醒,“确认有效”包括重复项、不会修复和不一定可达的真实缺陷,不能直接等同于可利用的高影响漏洞。
因此,厂商所说的“模型能以很少人工介入完成利用”应视为厂商主张,公开演示与补丁记录为它提供了支持,但没有公开完整任务轨迹、失败样本、算力成本和全部人工提示。对企业而言,更可靠的结论是:发现成本正在下降,而复现、分级、披露和修复能力必须同步扩容。
一条能落地的验证流水线
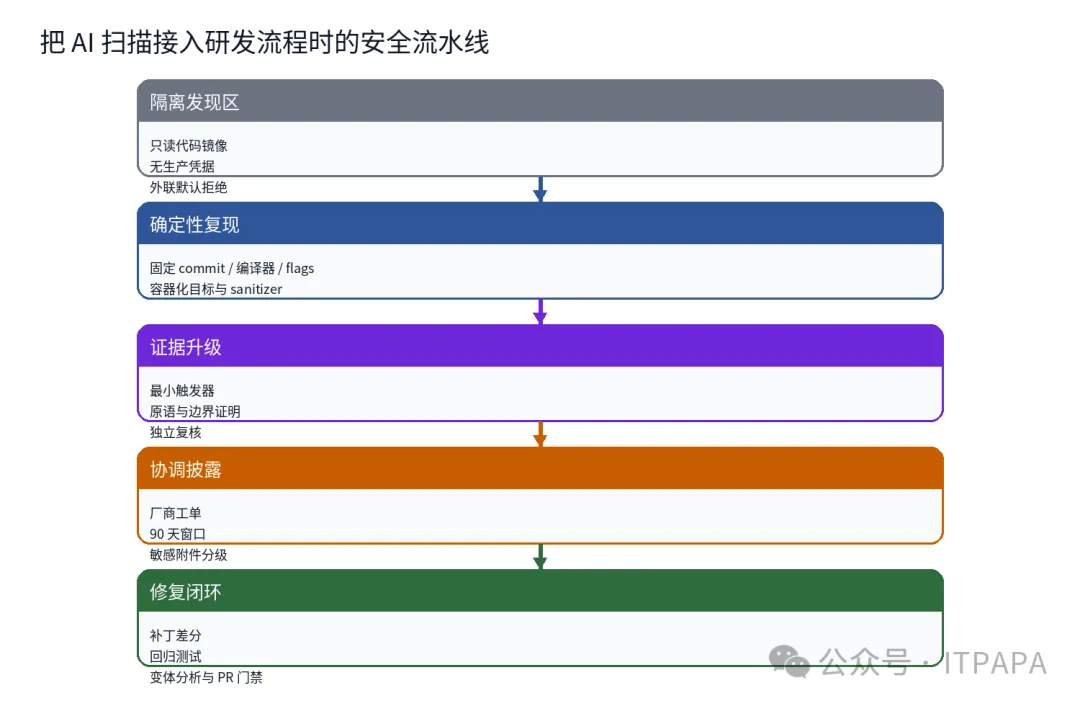
图 3候选发现与影响验证分区,敏感利用材料只在受控区流转。
隔离发现区
扫描代理只读取固定 commit 的代码镜像和专用构建产物。运行环境不挂载生产密钥、不继承开发者 SSH agent,默认禁止互联网外联,只允许访问内部制品库、编译缓存和受控目标。每次工具调用记录命令、工作目录、输入输出摘要和模型版本,便于复盘模型是否读取了未授权数据。
确定性复现区
候选结果进入由人维护的复现模板。模板固定编译器、优化级别、sanitizer、操作系统镜像与 CPU 架构,并至少在冷启动环境重复运行。竞态类问题应记录调度参数和成功分布;内存安全问题应保留未符号化与符号化栈、对象分配序列和最小输入。
证据升级区
研究者逐级回答三个问题:可控什么、跨过哪道边界、在什么前置条件下稳定成立。高风险 PoC 与普通 crash 样本分库存储,访问由人员角色和披露工单控制。任何包含稳定利用原语的产物都不应直接进入普通 CI 日志或聊天系统。
修复与回归区
补丁验证不能只看 crash 消失。研究者应先确认根因被消除,再运行变体输入,最后检查相邻安全不变量。回归测试最好落到触发根因的最小行为,而不是把完整利用链永久放进开源测试集。对浏览器这类高价值目标,完整 PoC 可以保留在访问受限的安全实验室。
防御性实验:用证据包阻止夸大结论
下面的实验不包含 Chrome 漏洞触发代码,也不尝试构造读写原语。它模拟企业内部的漏洞接收门禁:研究代理提交 JSON 证据包,验证器依据声称的影响级别检查必需字段。示例数据全部为演示值。
证据门禁示例字段与阈值应按组织威胁模型调整
# evidence_gate.py演示数据,不对应任何真实漏洞
REQUIRED = {
"trigger":["target_commit", "build_id", "input_sha256", "trace"],
"root_cause":["fault_class", "source_location", "minimized_case"],
"primitive":["primitive_type", "controlled_range", "repro_runs"],
"boundary":["boundary_name", "before_privilege", "after_privilege"],
"impact":["isolated_poc", "patch_commit", "regression_test", "reviewer"]
}
ORDER = ["trigger", "root_cause", "primitive", "boundary", "impact"]
def validate(pkg):
claimed= pkg["claimed_level"]
errors= []
forlevel in ORDER[:ORDER.index(claimed) + 1]:
forkey in REQUIRED[level]:
ifnot pkg.get(level, {}).get(key):
errors.append(f"{level}.{key}missing")
runs= pkg.get("primitive", {}).get("repro_runs", {})
ifclaimed in ("primitive", "boundary", "impact"):
ifruns.get("success", 0) < 3 or runs.get("total", 0) < 5:
errors.append("primitivereproducibility below gate")
ifclaimed == "impact" and not pkg.get("boundary", {}).get("boundary_name"):
errors.append("impactclaim has no boundary evidence")
return{"accepted": not errors, "errors": errors}
演示证据包artifact URI 仅为占位
{
"finding_id":"DEMO-2026-001",
"claimed_level":"boundary",
"trigger":{
"target_commit":"demo-commit", "build_id": "asan-o2-demo",
"input_sha256":"demo-hash", "trace": "artifact://trace"
},
"root_cause":{
"fault_class":"use-after-free", "source_location": "demo.cc:120",
"minimized_case":"artifact://min-case"
},
"primitive":{
"primitive_type":"controlled read", "controlled_range": "16 bytes",
"repro_runs":{"success": 4, "total": 5}
},
"boundary":{
"boundary_name":"demo renderer sandbox",
"before_privilege":"untrusted content",
"after_privilege":"demo service read"
}
}
预期结果与复核方法
测试动作 | 预期结果 | 复核重点 |
删除 boundary.after_privilege | 门禁拒绝,返回字段缺失。 | 不能只写“突破沙箱”,必须说明权限变化。 |
把成功次数改为 2/5 | 门禁拒绝,提示原语复现率不足。 | 阈值是流程门禁,不是漏洞真实性定理。 |
把 claimed_level 改为 root_cause | 可通过低级别门禁。 | 允许先提交根因,不允许沿用高影响标题。 |
补齐 impact 但缺 patch_commit | 门禁拒绝。 | 端到端结论必须进入修复闭环。 |
由第二位研究员重跑 | 结果、哈希与环境一致。 | 独立复核不能只阅读原作者录像。 |
复现次数 3/5 只是便于演示的最低阈值。真实项目应按漏洞类型设置:确定性越界应追求接近 100% 的触发稳定性;竞态漏洞需要报告试验次数、时间分布和负载条件;一次成功的端到端利用可以证明可行性,但不能用来估算现实攻击成功率。
检测与审计:模型轨迹也要成为证据
AI 研究代理与传统模糊测试器的区别,是它会改变假设、调用不同工具并生成新的中间代码。如果只保存最终报告,团队无法判断结论来自真实执行、模型推断还是研究员手工补全。至少应采集以下事件:
事件 | 关键字段 | 用途 |
agent.plan | task_id、model、prompt_hash、hypothesis | 还原研究意图,发现目标漂移。 |
tool.exec | command、cwd、container_digest、exit_code、stdout_hash | 证明命令在何处执行,防止伪造运行结果。 |
target.run | build_id、input_hash、sanitizer、signal、duration | 建立确定性触发记录。 |
artifact.create | artifact_id、type、sha256、classification | 追踪 PoC、core、最小样本和敏感等级。 |
claim.update | old_level、new_level、evidence_ids、reviewer | 阻止无证据升级影响结论。 |
disclosure | vendor、ticket、sent_at、embargo_until | 维护协调披露时间线。 |
检测逻辑示例重点是证据一致性与敏感产物流向
alert if claim.new_level in ("boundary", "impact")
andcount(claim.evidence_ids) == 0
alert if tool.exec.network_destination not in approved_allowlist
alert if artifact.classification == "weaponizable"
andartifact.destination in ("chat", "public_ci", "email")
alert if target.run.build_id != evidence.trigger.build_id
alert if disclosure.embargo_until > now
andartifact.shared_outside_case == true
企业落地时最容易踩的五个坑
把扫描数量当成安全产出
候选数量适合衡量发现覆盖,不能衡量风险下降。Anthropic 看板自己也把补丁数称为更可靠但滞后的指标。企业应同时看候选去重率、独立复现率、维护者确认率、修复周期、回归覆盖和重复引入率。
让模型直接访问生产环境
漏洞研究需要编译、调试和运行不可信输入,但这不构成访问生产密钥与客户数据的理由。研究区应使用脱敏镜像、合成数据和网络出口策略;需要闭源二进制时,也应复制到受控环境,而不是让代理登录生产主机。
完整 PoC 到处流转
从 crash 升级到稳定原语后,材料的敏感等级已经变化。应将可武器化 PoC 与普通缺陷报告分离,建立下载审计、短期凭据、禁止公共 CI 输出以及披露期自动到期策略。
把 CVSS 当作唯一排序
同一 CVSS 分数下,已证明跨边界的漏洞、仅存在理论路径的漏洞和需要特殊编译选项的漏洞,修复优先级不同。证据级别、资产暴露、可达性和边界位置应与 CVSS 一起进入排序。
补丁上线后停止变体分析
多阶段链说明攻击者会寻找相邻原语。修复一个 UAF 后,应围绕同一对象生命周期、同类 IPC 消息、相同缓存所有权规则和兄弟调用点做变体分析。否则,链路只需要替换其中一环。
适用边界与成本
这套证据门禁适合有源代码或可控二进制、能构建隔离复现环境、并具备 PSIRT 或安全研发职能的组织。它不会把普通研发团队变成浏览器利用专家,也不能消除闭源符号缺失、竞态不可重复和平台差异。
主要成本来自三处:确定性构建与制品存储;具备内存安全、沙箱和操作系统知识的人工复核;协调披露与补丁回移。模型推理费用通常不是唯一瓶颈。候选发现速度上升后,分诊与维护者沟通更可能成为队列最长的一段。
对大多数企业,第一阶段无需追求完整 RCE。更现实的目标是:让 AI 扫描产出的每个高危结论都带有可重放的构建、最小触发器、证据级别和修复回归;对真正跨越关键边界的少数结果,再投入专家完成端到端验证。
结语:漏洞发现正在变快,证据纪律必须更严格
Chrome 案例的价值不在于证明某个模型“会黑客技术”,而在于展示漏洞研究自动化已经从单点缺陷走向跨边界组合。对防守方,最危险的反应是用更多扫描器制造更多列表,却没有能力判断哪些结论成立、哪些材料可公开、哪些补丁真正切断了攻击路径。
把 crash、根因、原语、边界和影响分开,把每次升级绑定到可复核证据,再把完整轨迹、敏感制品和修复回归纳入同一流水线。这样,AI 才能缩短暴露窗口,而不是把 PSIRT 变成一个更快堆积噪声的工单系统。