ARTICLE · 1339018
超轻量agent记忆插件memlite实测笔记
几十条结论,非要搭套基础设施?
799 KB、零依赖
5 行代码跑起来
本地记忆内核 · BM25 · 因果树 · 单机实测
respire-memlite
📦 5 Parts + Conclusion
👉 滑动
PART 01
它是什么
内核与存储
PART 02
轻是真的轻
体积与内存
PART 03
速度
够用不算神
PART 04
上手
五行代码
PART 05
用前须知
三个边界
PART ///
写在最后
适合什么场合
来源:000基础文档/respire-memlite 轻量性与便捷性测试报告-20261110.md
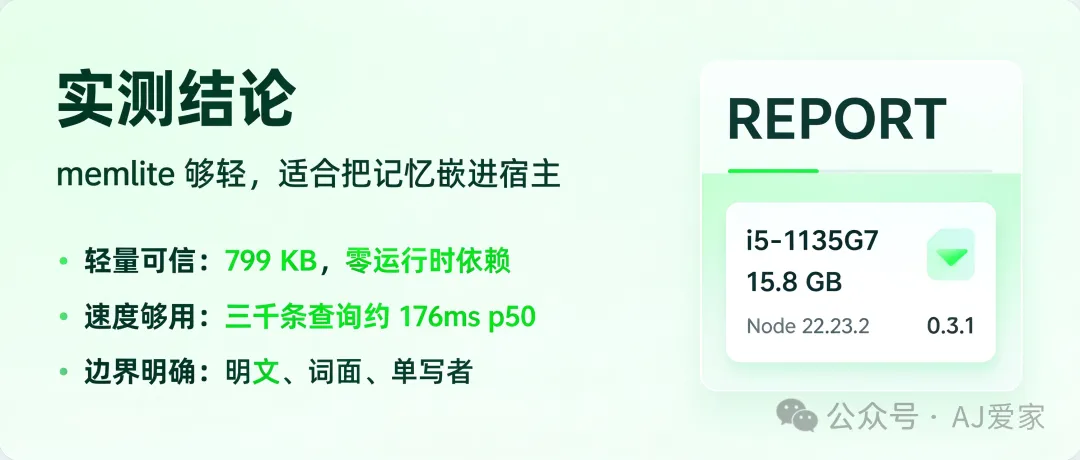
测试环境:i5-1135G7 / 15.8 GB / Windows 11 / Node 22.23.2 / @rsrsai/memlite 0.3.1
上周想给编辑器插件加一层「记住上次的结论」。问了三家,一家要起常驻服务,一家要登录拿密钥,一家要我先建向量库。就为了几十条判断搭一套基础设施,我怎么算都觉得不值。
后来翻到 memlite。它自己说:可嵌入、零依赖、召回 1ms 级。前两条我信一半,第三条干脆装上测一遍。
01
PART
它是个什么东西
WHAT IT IS · 内核与存储
memlite 是 risense-ai 做的本地记忆内核,两个版本:Rust 单文件二进制 respire-memlite,和 npm 包 @rsrsai/memlite。两边读写同一份 memory.jsonl。存储就是一个追加写的 JSONL,检索用 BM25,再加一棵 parent_id 串起来的因果树,MIT 协议。没有数据库,也没有账号和云。
我测的是 npm 版 0.3.1。Rust 版本机没装,所以「单文件、免 Node」这半句我只能照官方说法写,下面所有数字都不含它。
02
PART
轻是真的轻
WEIGHT · 体积与内存
799 KB。整个 node_modules 是 818,724 字节,只有一个包。运行时依赖零个,fs-ext 是可选件,装不上也照用。
index.js 118 KB,干活的就是这一份。剩下的是两套入口、两份类型声明,还有 483 KB 的 sourcemap,跑起来不加载。
没有服务,没有端口,没有账号。这三样比体积更实在。整套测试我没配过环境变量,没登录,也没起任何东西,new Memlite({ dataDir }) 加一个 open() 就开始干活。
冷启动跑了五次:import 21 到 27 毫秒,空库打开 10.9 毫秒,三千条的库冷开 39 到 41 毫秒。一条查询端到端 376 到 429 毫秒,其中 node 自己启动就占 130 毫秒上下。当 CLI 用没问题,常驻当然更快。
磁盘和内存也顺手量了:
rsrs 那边 3437 条,加密 SQLite 88 MB 再加 5.2 MB WAL。两个数不好直接比,memlite 这份不加密也不放向量。但它把东西放得很朴素,这倒是真的。
03
PART
速度:够用,也不算神
SPEED · 逐档压测
每档跑 20 次取分位数,纯词面,不开嵌入:
曲线基本是直线,三十倍数据换十七倍延迟。原因是它每次查询对全库重新分词,没有持久倒排。这个是我从曲线形状推的,没跑 profiler。
按这条线,百来条的库一条查询十毫秒左右,三千条接近两百毫秒。对「插件里记住几百条结论」这种用法够了。条数上万,就得考虑加缓存或者开嵌入档。
同机对照,rsrs 用 3437 条跑同一条查询,五次是 1195、971、933、904、906 毫秒。memlite 三百条那档比它快一个量级。但两件事不一样。rsrs 那 933 毫秒里含本地嵌入推理,能按意思找。memlite 是纯词面,靠词对上。要按意思找,它得开嵌入档,这个我这次没测。
04
PART
上手:五行代码,不用配
USAGE · 最小能跑
最小能跑的代码是五行、185 个字符:
import { Memlite } from '@rsrsai/memlite';
const m = new Memlite({ dataDir: './data' });
m.open();
await m.remember('结论', { title: '标题' });
const r = await m.recall('结论', { limit: 5 });
不传 dataDir 也行,它按 MEMLITE_DATA、项目里的 .memlite/、用户级目录、最后的 ~/memlite-data四层找。我用假环境试过,回退落点是对的。
几个用起来顺手的地方:
写完就能查。主路径同步落盘,不等索引。我写了一条带唯一标记的记录,马上召回的命中就是它自己,后端标 bm25。
因果树两个接口。remember(..., { parent }) 挂因,show() 回来直接带祖先子孙。命中一条就知道它前因后果,不用再发一轮请求。
条件写不用服务端。两个实例指同一个库,A 按 revision=0 写成功,B 还拿 0 去写,直接抛 STALE_VERSION,带着当前版本号,库里最后是 A 的内容。轻归轻,乐观锁没省。
敏感信息默认拦住。写「数据库密码是 Passw0rd!2026」直接被拒,提示改存位置指针。手机号、JWT 也拦得住,普通技术结论照过。
坏一行不炸库。我手工塞了一行非 JSON,bad_lines 记 1,剩下两条照常能查。
bench 是它自带的,20 条语料 × 20 条改写查询,hit@1 17/20,85%,和官方口径对得上。升级版本以后重跑一遍,就知道有没有退化。
05
PART
几件用之前知道就行的事
NOTES · 三个边界
✦ 明文落盘
记事本能打开,git 能同步,宿主用 Rust、TS 还是 Python 都一样,读的是同一份。方便就在这儿,在意隐私也得防着这儿。本机能读文件的人都能读你的记忆。respire 主线用加密库,管的就是这一层。
✦ 查询靠词
我拿 19 条真实查询去撞 8 条记忆,17 条命中,连「超时网关」这种词序颠倒的都中。空的两条是「gateway timeout」和「TLS 握手失败」,一条换了语言,一条换了整句说法。这种查询交给 agent 先扩成同义词再查,两条都回来了。所以只要宿主会改写查询,词面这套基本够用。
✦ 多进程按单写者用
我起两个 node 进程对同一个库各写 400 条,八百条全落盘,零坏行零报错,追加写这层是稳的。但 status 里 lock_backend 是 in-process、cross_process = false,mode 写的是 single-writer。各进程读的又是自己那份索引快照,会有几十条的滞后。一个库交给一个进程写,最省心。
///
LAST
收个尾
SUMMARY · 适合什么场合
memlite 的定位是「塞进宿主里 import 就用的轻内核」,不做「功能全的记忆系统」。
库在几千条以内,内容是技术结论和项目上下文,查询里带得出关键词,或者宿主能替你改写,还要明文和 git,这种场合它挺合适。
顺手给作者提两句:
包里 VERSION 常量还是 0.3.0,package.json 是 0.3.1,宿主做版本展示会读错,建议对齐一下。
「召回 1ms 级」这句,改成「毫秒级,随条数增长」更稳妥,它本来就够轻,不用这句撑场面。
复现脚本和原始 JSON 都在报告里,附录 A 有命令,附录 C 是这次补测,谁都能重跑。
我是百年江湖 随意沉浮,怕什么真理无穷,进一步有进一步的欢喜。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING