ARTICLE · 1341094
11w Star 的 Agent 记忆插件:最难的不是记住,是别信旧经验
11w Star 的 Agent 记忆插件:最难的不是记住,是别信旧经验Claude Code 有一款记忆插件 claude-mem,斩获 11 万 Star,上线一年多迭代至第 15 个大版本。一句话概括它的作用:记下 Agent 的所有操作沉淀,在下一轮会话里复用。 乍看只是存储问题。但通读这一年的提交记录就能发现,各个版本攻坚的核心,从来不是 “存得更多”,而是 “少记错、别乱记”。 最初的思路简单直白:Agent 读过的文件、执行过的命令、拿到的返回结果,全部入库;新会话启动时,再把这批记录塞回上下文。 这条路很快走不通。为修复一个 Bug,Agent 可能读取上百次文件、调用数十次工具、跑一大堆 Shell 指令,动辄生成数万 Token 的流水。可真正值得留存的,往往只有寥寥两句:根因是什么,该怎么解决。 把全部流水喂回会话,要承受双重代价:高昂的 Token 开销,以及海量噪声稀释模型的判断能力。 第三代版本引入了 Observer(观察者):用一个独立模型持续监听主 Agent 的操作流,把上百次工具调用浓缩成结构化记录 —— 发现了哪些线索、尝试过哪些路径、哪些经验可以复用。 主 Agent 负责干活,Observer 负责记账。走到这一步,它早已不再是单纯的日志存储器。 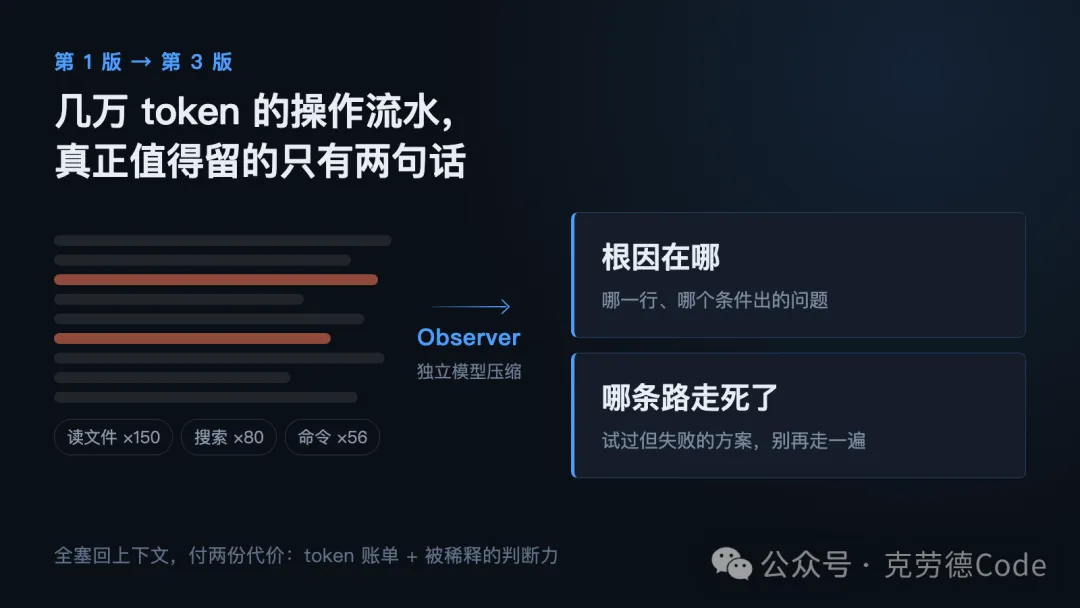
第二道瓶颈,和记忆本身无关。 早期方案依靠持久化队列:事件入库,由 Worker 逐条消费;一旦进程崩溃,重启后继续消费队列。2026 年 5 月,这套队列被彻底移除,替换成进程内的会话消息缓冲区:session message buffer。原因十分尖锐:保存了原始事件,不等于能够复原 Observer 的理解状态。 想象这个场景:Observer 读完前十条事件,已经形成对任务的初步判断,正在处理第十一条,这时 Worker 意外挂掉。原始事件一条不少,但模型中途构建出来的理解全部丢失。重放时,新启动的 Observer 会推导出完全不一样的结论,甚至重复记录已经处理完毕的事项,最终演变为重试风暴。 这说明,恢复中断的模型会话,绝非简单重放事件就能完成。系统需要保留原始记录用于完整回放;缓冲区只维护进程内事件,保证有序接收、自动去重,只有当结果成功落库,才标记消费完成。被读到,不等于被记住。 更隐蔽的隐患紧随其后。原先依靠 Checkpoint 标记读取位置,实现逻辑是:数据载入内存就更新游标。如果此时程序崩溃,缓冲区清空,但进度停留在第 100 行;重启之后从第 101 行继续,第 100 行就此永久丢失。 日志完好无损,恢复机制本身却制造了数据丢失。对应的修复方案是 Checkpoint Gate:必须等到数据成功落库,再向前推进游标,原理和消息队列的消费确认一致。 一款记忆插件,就此不得不引入一致性、幂等性与崩溃恢复机制。 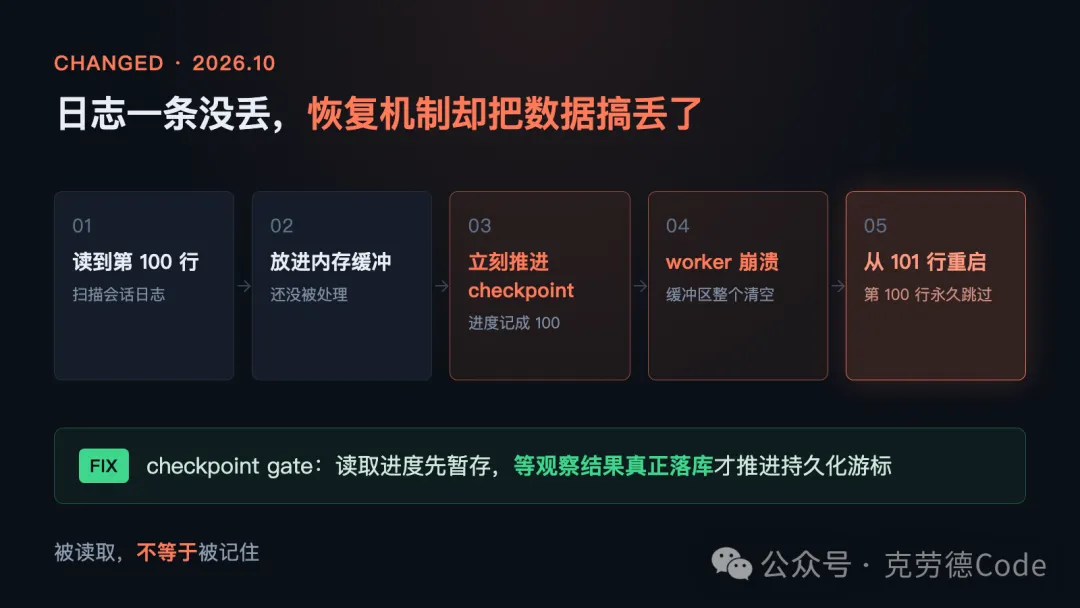
设计 Observer,本意是避免主 Agent 的上下文被撑爆。可当主 Agent 连续运行十几个小时、发起上千次调用,Observer 需要持续接收数据流,自身的上下文同样会不断膨胀。 为了解决一个 Agent 的上下文过载问题,我们造出了另一个饱受上下文限制的 Agent。 最早的解法十分粗暴:保留系统提示词与最近消息,截断中间内容。代价是观察链条断裂,被砍掉的片段,很可能正是理解当前任务的关键。 到 8 月底,方案迭代为定长轮换会话。新的 Observer 并非从零启动,系统会把此前全部观察浓缩成一份交接摘要,交代清楚 “截至目前发生了什么”,再交给继任者。 相当于定期换班。风险也很明确:上一轮 Observer 漏掉的隐性前提,后续接手的模型永远无从知晓。 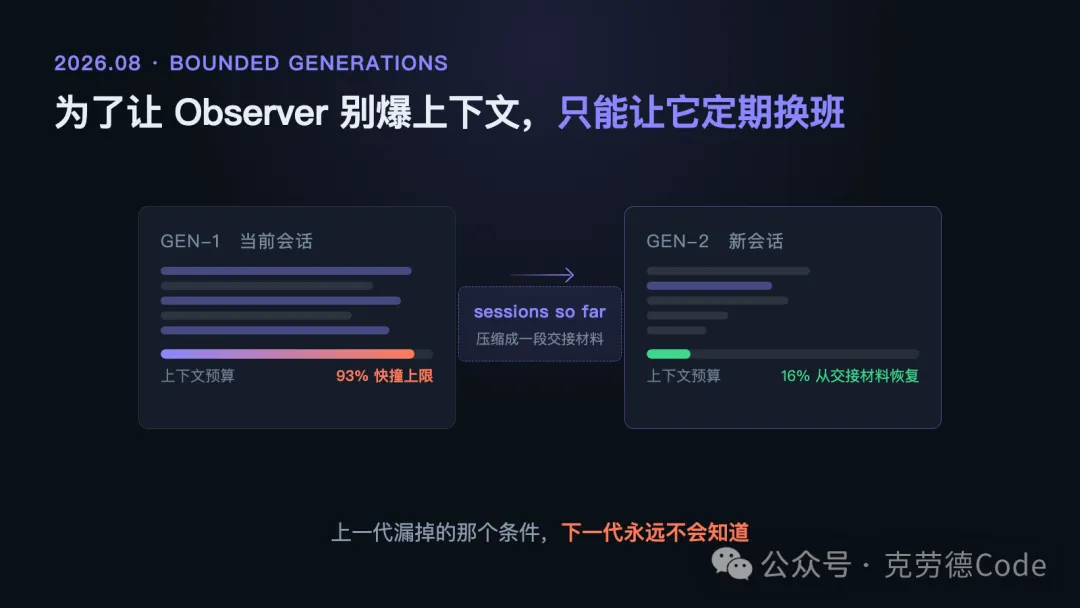
10 月的统计数据很直观:高负载场景下,Agent 每小时生成 600–1060 条事件,但 Observer 每小时仅能处理 275–430 条,积压峰值一度接近 4800 条。Agent 早已完成任务,负责记录的观察者还在消化很久之前的操作。 于是批处理机制登场,同时设置严苛的合并规则:只有同一用户、同一个 Agent、同一目录下的连续事件,才允许打包;混杂的事件一旦合并,Observer 会误判操作之间的关联。而且批块并非越大越好,在项目样本中,最优批大小设为 8,但实际平均每批只能处理 1.6 条 —— 子 Agent 的事件交错涌入,很难凑满批次。 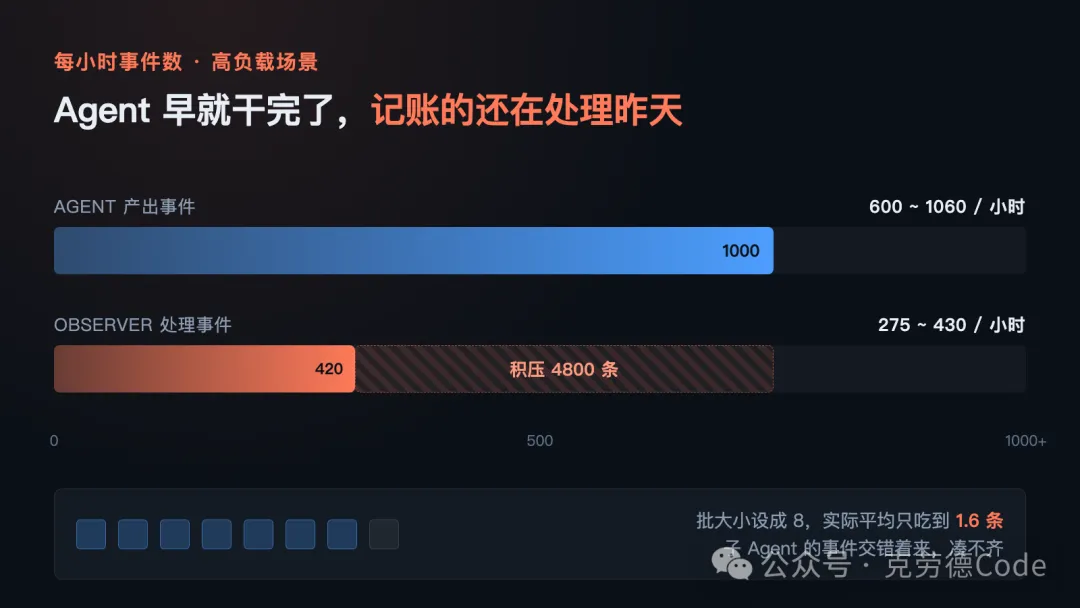
问题的重心,慢慢从 “如何记录” 转向 “如何使用记忆”。 最初的策略,是在新会话开始时推送最近的历史记录。但新近发生的未必最重要:两个月前敲定的架构规范,很容易被连日大量的文件修改记录挤出上下文窗口。 9 月,项目加入了类 ACT-R 的记忆强化机制(默认关闭):反复被验证、触发的旧经验,权重持续抬升;同时预留四分之一配额给最新观察,防止陈旧经验长期垄断上下文。 除此之外还有 File Read Gate:遇到大文件时,如果系统已经存有相关观察,会阻止模型一次性读取全量文件,引导它先看文件结构,或是只读必要片段。 记忆系统,开始反过来改变 Agent 调用工具的行为模式。 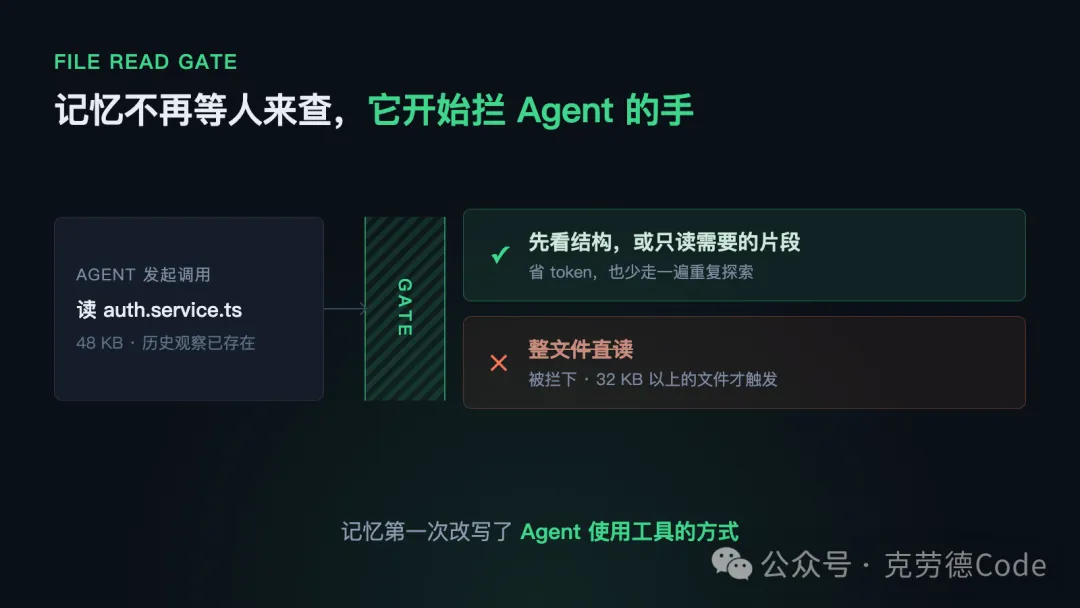
这是整个演进过程里最值得深思的一环。 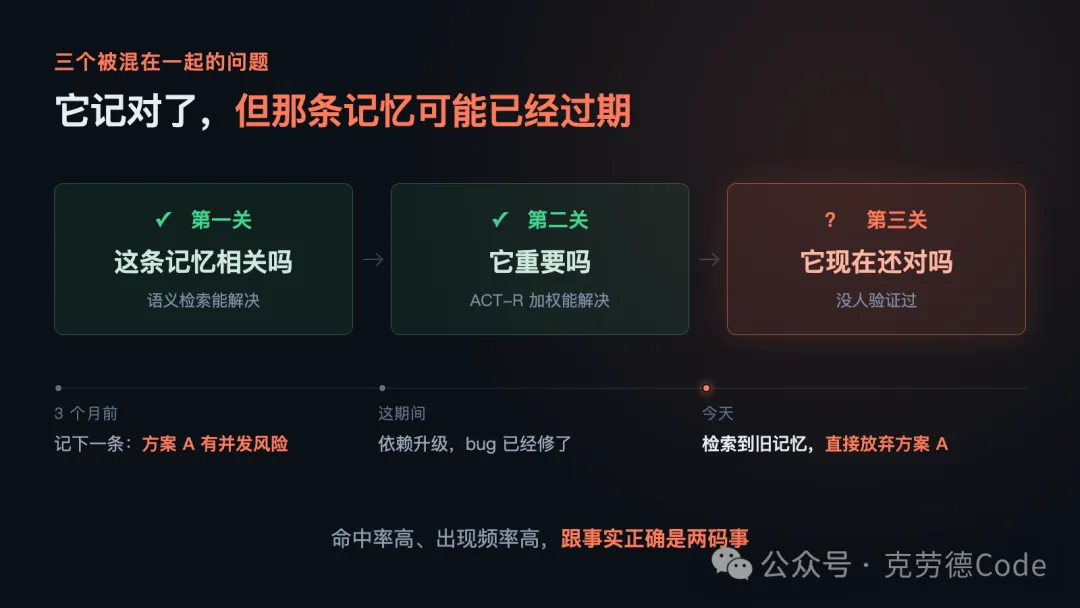
三个月前,Agent 调研某个认证模块,当时依赖库存在兼容缺陷,Observer 记下结论:方案 A 存在并发风险,不要采用。三个月之后依赖升级,原有 Bug 已经修复。当 Agent 再次遇到相似需求,检索到这条记忆,便直接放弃方案 A。 它没有遗忘。恰恰相反,它精准召回了历史经验,并且不加甄别地把过期结论套用到当下。 三类问题常常被混为一谈:这条记忆是否相关、是否重要、时至今日是否仍然成立。语义检索负责判断相关性,ACT-R 权重负责衡量重要程度;但命中频次高、关联性强,绝不等于结论依旧符合现实。 另外,文本压缩还容易抹掉约束条件:“在某个旧版本下,方案 A 存在兼容问题”,经过压缩简化之后,会变成 “方案 A 不可靠”,一条带有前置限定的局部经验,被升格为普适规律。 项目已经增加基础校验,例如验证引用的 Git Commit 是否真实存在,防范虚构记忆入库。可 Commit 真实,不代表当初的解读准确;一条经验过去成立,也不代表它永久有效。 回看这一年的迭代:为了留存工作历史,嫌弃原始日志杂乱,诞生了 Observer;为了稳住 Observer 的事件流,搭建缓冲与故障恢复;为了解决 Observer 自身上下文溢出,设计轮换交班;面对事件生产速度远超消费速度,引入可控的批处理;记忆体量膨胀之后,加上检索与权重排序;当记忆能够左右 Agent 的行为,就必须审视它的可信度。 它没有成长为具备自主目标的完整 Agent,却演化出一套以大模型为内核、拥有独立生命周期与状态机的观察子系统。 行业内谈论 Agent 记忆,大多还停留在挑选向量数据库。而这十五个版本讲的是另一层真相:难点从来不是记住,而是在恰当的时机,唤起那条正确的记忆,并且知道什么时候,不能再采信过去。
本文基于对 claude-mem(github.com/thedotmack/claude-mem,v15.9.0)架构演进过程的梳理。项目数据引自 GitHub 仓库公开信息,版本号与 star 数统计截至 2026 年 11 月。
一、初版就撞上高墙
二、记账的观察者,同样会宕机
三、极具讽刺的困境
四、记账速度,跟不上Agent 干活速度
五、记忆开始干预决策
六、记忆没错,但可能已经过时