ARTICLE · 1345678
九图三视三音:H3 参考片接满,模板却只开了三个槽
前六篇把「装什么、连什么、多大多长、词怎么写、声音怎么来、首尾怎么钉」走完了。这一篇进「参考」——把别人的脸、别人的运镜、别人的音色,搬进你要拍的这条片子里。
绝大多数人第一次做参考片,流程是这样的:打开 r2v 模板,拖两张图进画布,在提示词里写「保持人物一致」,跑完一看——不像。于是以为是图不够多,凑到九张再跑,还是不像。
本篇一句话结论:参考不起作用,八成不是图不够,是参考条件根本没走到采样器。官方在节点提示里写得很直白——不接 vae,参考图只喂给文本编码器;不接 audio_vae,参考音频同样只喂文本编码器。
而这条链上还压着三层东西:模板给的控制点数量不等于模型能吃下的上限(图像只开了 3 个槽,模型能接 9 个);标签编号跟着接线顺序走,换一下插槽,提示词里的 <Picture 1> 就指到别人身上;保留关系有四档标记,写错档位,参考等于没写。
这篇所有数字都能自己验:通路上限读节点的接口定义,槽位和接线读模板 JSON 里 #136 的连线,标记体系读官方给参考模式写的那份格式指南。
① 参考不是一个口,是四个口
r2v 模板里真正干活的只有一颗节点:MiniMaxH3ReferenceToVideo(中文界面叫「MiniMax H3 参考转视频」,在模板里编号 #136)。整条片子怎么生成、参考怎么进、声音怎么带,全压在这颗节点上。
查它的接口定义,会看到四个「自动增长」输入组,各自带着上限:
| ref_images | 9 | |
| ref_videos | 3 | |
| ref_video_audios | 3 | |
| ref_audios | 3 |
四个口分两类:ref_images 是静态素材的入口;ref_videos 负责运动和结构;两条音频通路互不替代——ref_video_audios 是「这段视频自带的声音」,ref_audios 是「我单独给你一条声音」。同一段参考视频可以同时占一个 <Video 1> 和一个 <Audio 2>,编号各自独立,不要求对齐。
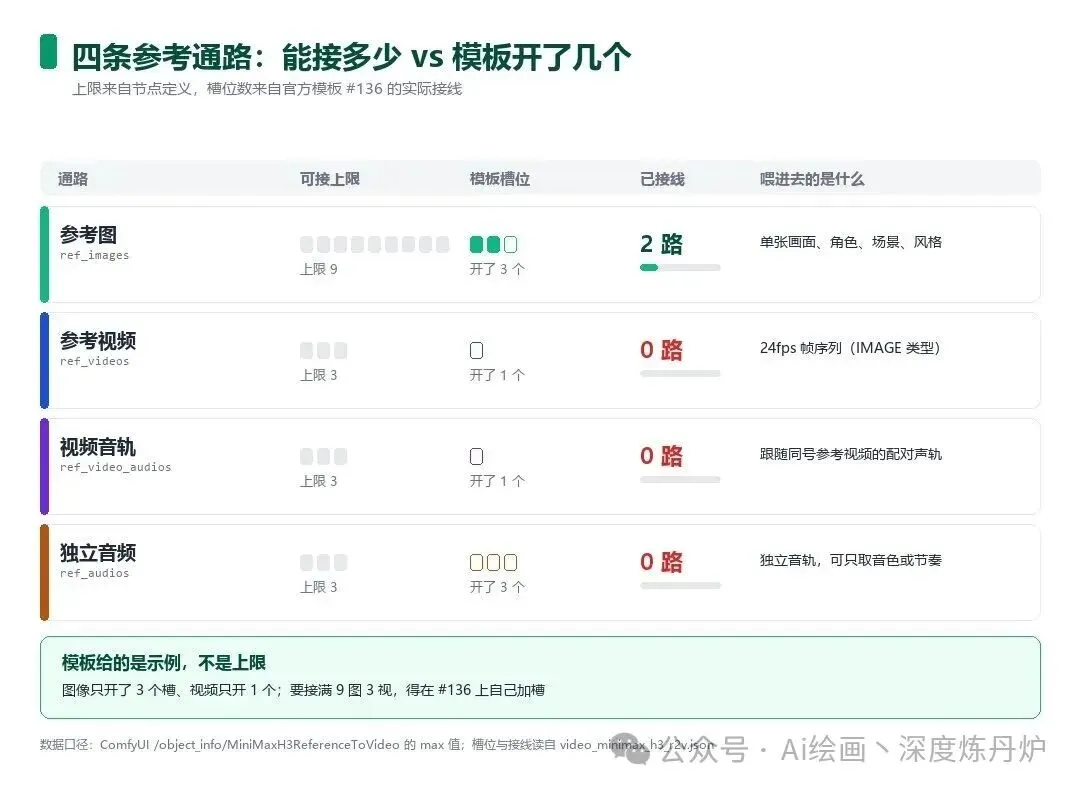
这里有个容易忽略的细节:ref_videos 吃的是帧序列。也就是说你没法把一个 mp4 直接拖进去,得先解码成 24fps 的 IMAGE 批次再连过来。这个设计让「参考视频」的精确定义变成了「一段按帧排好的画面序列」——它不关心你原来是多少帧率的文件,只关心喂进来的帧。
② 模板给你开的槽,不等于模型的上限
上面那张表是模型的能力。模板实际给了多少?把 #136 的输入插槽挨个数一遍就清楚了。
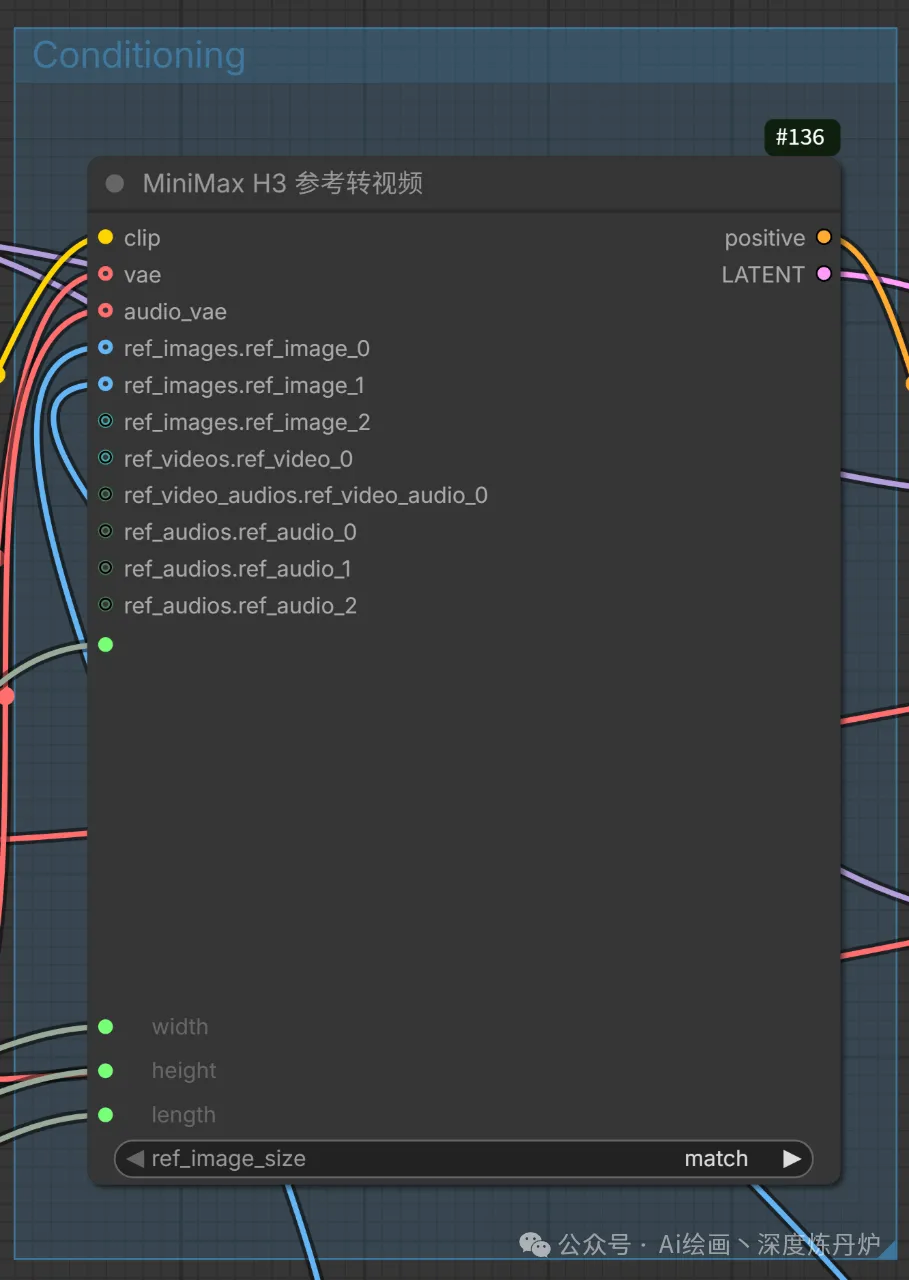
这张是官方模板的真实画布截图,不是示意图。数一下就能看到:ref_images 开了 3 个槽(ref_image_0 / 1 / 2),其中前两个接了线、第三个是空心的;ref_videos 只开了 1 个槽;ref_video_audios 也只开 1 个;ref_audios 倒是开了 3 个,一个都没接。
也就是说,模板的默认状态是「两张图,可能配一段音」,其余全空。你要接九张图,第一步不是去找图,是在节点上把槽位加出来——这类输入组在界面上表现为可增长的插槽组,加槽之后才谈得上接满。
为什么模板这么保守?因为这四组插槽加起来理论上能挂 18 个输入,画布上全展开会挤成一堵墙,而且大多数人的场景就是一两张图。模板选的是「常用起步」,不是「能力边界」。把模板当上限,是参考片最常见的认知错位。
顺带说一个反直觉的点:图像只开 3 个槽、音频却开了 3 个——这个不对称说明模板预设的主场景是「少量图 + 音色克隆」,而不是「九图大参考板」。想走参考板那条路,槽位得自己铺。
③ 两个 VAE:参考能不能真的到达采样器
这是本篇最该记住的一条。看 #136 的前三个输入:clip、vae、audio_vae。多数人只连 clip(因为文本编码要靠它),另外两个当摆设。
节点自己的提示写得很清楚,我把原文抄在这里:
vae 的提示原文
Without it reference images/videos only condition the text encoder.
audio_vae 的提示原文
Without it reference audio only condition the text encoder.
翻成白话:不接 vae,你塞进去的参考图和参考视频,只会被文本编码器「读一遍」,不会进入 latent 条件,采样的时候完全不参与。参考音频同理。
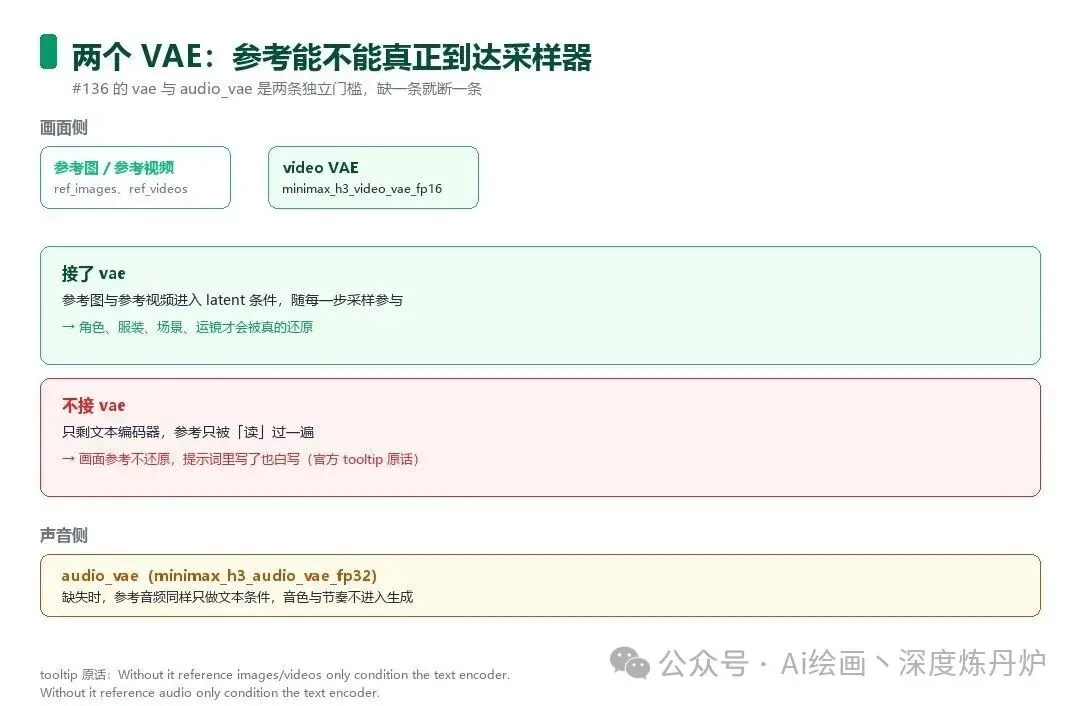
模板里那两个 VAELoader(#119 加载 minimax_h3_video_vae_fp16、#120 加载 minimax_h3_audio_vae_fp32)就是开这两道门的钥匙。它们和 t2v / i2v 模板里的 VAE 是同一个文件,但作用完全不同:在 t2v 里 VAE 只负责解码出画面和声音,在 r2v 里它还负责把参考编码进条件。
这解释了一个很典型的现场:从 t2v 模板拷几颗节点过来拼参考片,跑得通、不报错、画面也有——但就是不像。因为 t2v 的采样链路里 VAE 接在解码端,参考节点的 vae 输入是空的。官方把这句话写进提示里,说明踩的人足够多。
顺带澄清一个流传很广的说法:「在 t2v 画布上放个参考节点就行」。不行。参考条件要生效,必须真的连到采样器那条链路上;放一颗游离的节点,它算出来的东西没人接,等于没放。
④ 编号跟着接线顺序走,不跟文件名走
官方模板的说明里有一句操作指引,值得逐字读:提示词里引用输入,要按连接时的确切顺序打标签。也就是说 <Picture 1> 指的是「接在第 0 个图槽里的那张」,不是「文件名排序第一张」。
这条规则的实际后果是:你调整了插槽顺序,提示词就得跟着改。把原本接 ref_image_0 的 A 图挪到 ref_image_1,那 <Picture 1> 就从 A 变成了之前的 B。提示词里所有点名的地方全部错位,而且不会报错——只是生成结果莫名其妙。
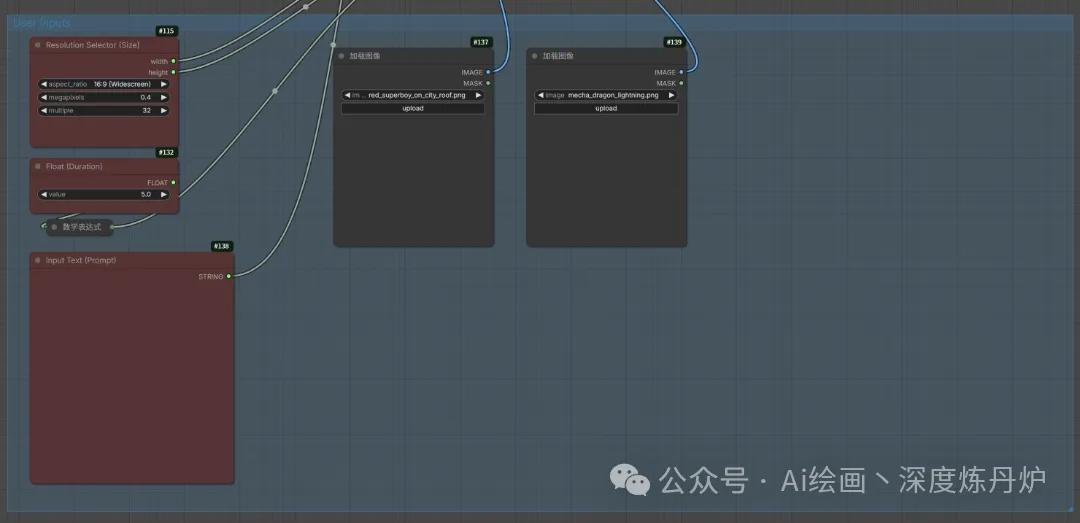
这是模板的输入区实拍。左边是输出尺寸(16:9、0.4 百万像素、32 倍数)、时长(5.0 秒)和提示词框;中间两张 LoadImage 分别接在 ref_image_0 和 ref_image_1 上。
四种标签的分工也有讲究,这条很多人搞混:
| <Subject N> | ||
| <Picture N> | ||
| <Video N> | ||
| <Audio N> |
最容易错的是 <Picture N>:很多人把参考图全写成 <Picture 1>、<Picture 2>,以为这样最保险。但按官方规则,如果这张图只是用来定义「这个人长什么样」,它应该被写进 <Subject 1> 的定义里当来源引用,而不是占一个独立的 Picture 编号。反过来,如果这张图要当首帧,那它必须是 <Picture N>。两种写法在成片里的效果不一样。
⑤ 保留关系有四档,不是「像」和「不像」
参考片真正难的地方在这里:你和模型之间得有一套共同语言,说清「这段参考到底要被保留到什么程度」。官方给参考模式定的是一套固定的英文标记,画面侧四档、音频侧四档。
| fully_preserved | |
| partially_preserved | |
| attribute_transfer | |
| weak_reference |
| fully_copy | |
| partially_copy | |
| reference | |
| weak_reference |
两个容易读错的地方:
第一,attribute_transfer 和 weak_reference 不是程度深浅,是关系类型不同。前者是「把 A 的属性给 B 用」,后者是「大概像那个味儿就行」。前者要求目标主体明确,后者连主体都不要求。写错这两个,等于让模型干了另一件事。
第二,成片里新增的内容不算「参考保真度下降」。官方专门提醒过这一点:你在新片里加了原本没有的动作、背景、情节,不该因此把标记往下降档。标记评的是「参考那部分的去向」,不是「这两条片子有多像」。
还有一条硬规则:标记只能在该标签已经定义好的职责范围内选。先在 <Subject 1> 的定义里说清它是「脸 + 服装」,那后面就只能在这两样上判 fully / partially,不能突然说它「整体弱参考」。
⑥ 完整提示词是六段,不是一段话
参考模式的输出格式和文生视频不一样。文生视频主要是一段主描述,参考模式要拆成六段,按顺序:
subject_definitions(定义每个参考标签)→ summary(任务类型 + 目标片 + 主要参考关系)→ retention_analysis(每条参考的去向与档位)→ detailed_description(按播放顺序逐镜检查点)→ overall_soundscape(环境声与物理声)→ non_diegetic_music(只有观众听得到的配乐)。
其中 summary 开头必须挂一个方括号任务类型前缀,按参考资产在成片里的实际作用选,可以组合、不重复:
keyframe completion —— 图当首帧 / 关键帧 / 尾帧
reference generation —— 只做角色、场景、风格、动作、运镜的生成指导
video editing —— 直接改写一段已有视频
video continuation —— 从已有视频结尾往下接
audio reuse —— 同一段音频整段或部分复用
audio reference —— 只借音色、风格、节奏,不拷信号
组合写法官方给了例子:拿参考视频往下接、同时用一张图当尾帧,写成 [video continuation + keyframe completion]。只改了原片音轨但没动画面,就是 [video editing + audio reuse]。
这里有个反直觉的判断:参考视频只是提供了运镜或剪辑节奏,不该算 video editing。它属于 reference generation。只有你真的在改动那段原视频,才用 editing / continuation 这两个前缀。很多人一看到接了视频就写 video editing,任务类型从一开始就错了。
关系式描述:一句话分配一个职责
官方推荐的行文方式是「逐个点名 → 分配唯一职责 → 按时间顺序写意图」。落到实操上,就是每个参考资产配一句「它负责什么」,不要让一条参考背两个职责,也不要两条参考抢同一个职责。
可直接套用的骨架
<Subject 1>(来自 <Picture 1>):保持面部、发型与外套颜色
<Video 1>:沿用其缓慢推镜与剪辑节奏
<Audio 1>:用其音色与语速,不复用原台词
[Shot 1] 从这里开始……(按播放顺序逐个镜头铺开)
参考板的写法属于 <Picture N> 的一个特例:一张图里有多个分格(正面、侧面、全身),它就该被定义成分镜/构图参考,并在后面的镜头里指向具体分格。官方允许的表述是「这张图是第 1、2 镜的分镜参考,定义了视点、主体位置与镜头顺序」,然后在镜头里写「<Picture 2> 的正面全身」。不要只说「参考这张板」,要指到格。
正文字数上,官方给生成类任务的建议是 350–500 个英文单词;对白密集的段落优先保证台词时间线完整,不必凑字数。
⑦ 模板自带的两个默认值,建议动手改
参考片的采样设置和文生视频不一样,这不是玄学,模板里的说明节点自己写了。
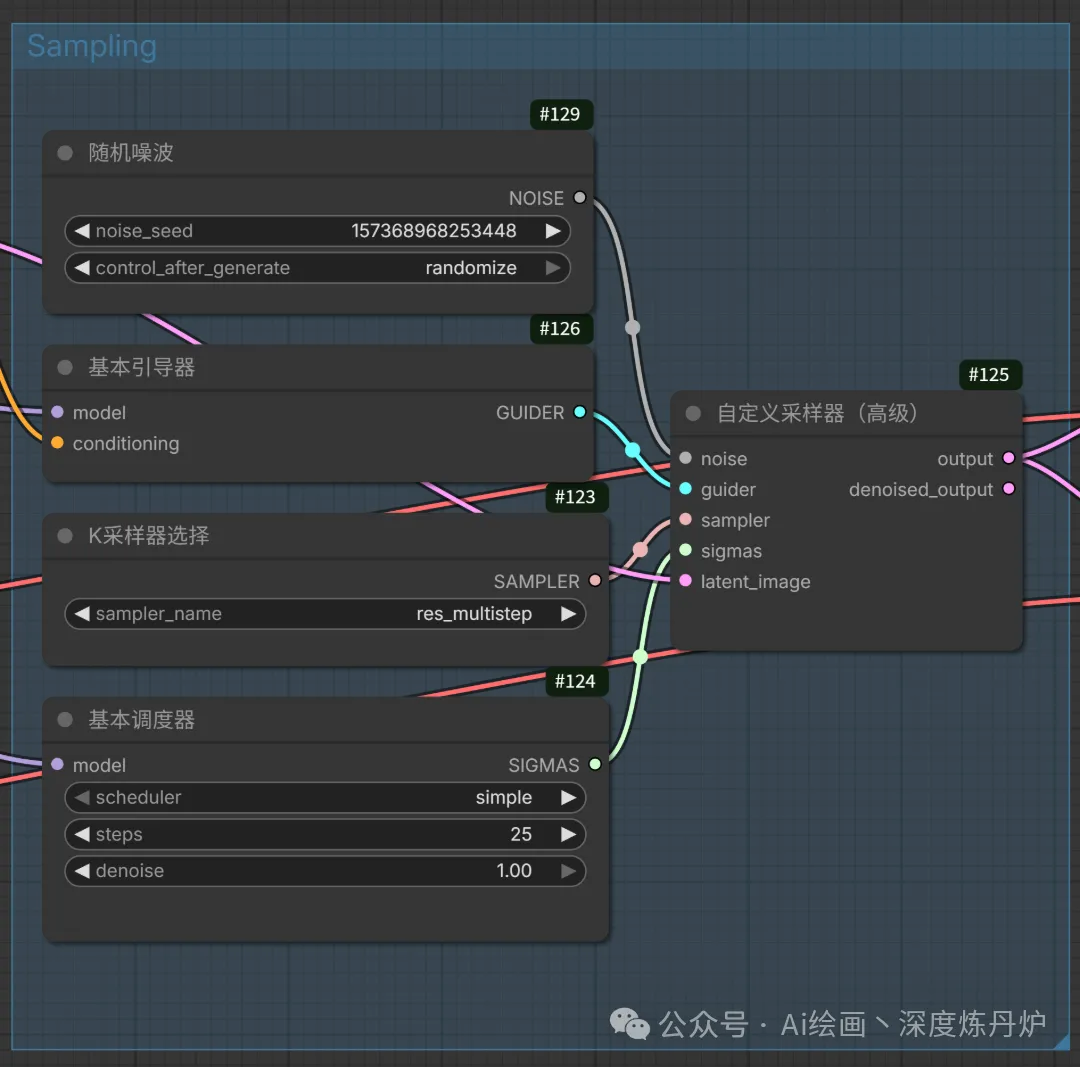
实拍看到的是:采样器 res_multistep,调度器 simple,步数 25。和 t2v 模板的 20 步比,参考片默认多 5 步——因为参考 token 要跟着每一步走,条件更重。
但模板的说明节点里有一句和默认值相反的建议:参考密集的提示词,beta 或 normal 调度器往往比 simple 表现更好。默认给的是 simple。也就是说,照着模板原样跑,你用的是「能用但不是最优」的那一档。
这个改动成本极低:把 #124 的 scheduler 从 simple 换成 beta 或 normal,其他不动,同一个种子对跑一遍就能看出差别。参考越多、越需要贴合,这个差异越明显。
ref_image_size:快和省,二选一
这颗参数只有两个值,但它直接决定参考的力度:
| match | ||
| max |
实操建议:试拍定风格阶段用 match,定稿或角色特写用 max。不要一上来就 max 配九张图,那是最慢的组合,改一个参数要等很久才知道对不对。
⑧ 参考片排查表
⑨ 这一篇的四句话
一、参考是四个入口,不是一个。图 9、视频 3、视频音轨 3、独立音频 3,类型还各不相同——参考视频要的是帧序列,不是文件。
二、模板的槽位是示例,不是上限。图像只开 3 个、视频只开 1 个;要接满,先在节点上加槽。
三、两个 VAE 是参考的门。缺 vae,图只喂文本编码器;缺 audio_vae,声音同样。这两条线一断,九张图也是白喂。
四、保留关系要写档位。画面四档、音频四档,选错档等于换了个任务;标记只能在已定义职责范围内挑。
本文基于 ComfyUI 官方仓库 Comfy-Org/workflow_templates 中的 video_minimax_h3_r2v.json、本机 ComfyUI 0.43.0 的节点接口定义(MiniMaxH3ReferenceToVideo)、MiniMax 随模型分发的参考模式提示词格式指南(ref-en.txt)整理。文内截图均为本地加载该模板后的真实画布截取。
许可信息仅供参考,商用前请自行核实许可原文;统计数据来自社区公开数据,非官方保证。
文中「模板槽位小于模型上限」「调度器建议与默认值不一致」等观察,以及留档与排查思路,为作者归纳,非官方原文。