ARTICLE · 1352295
处理PDF不想上传文件?浏览器本地就可以完成操作 | 实测
本文为个人实际体验后的客观记录,仅介绍站点功能,不构成使用建议。
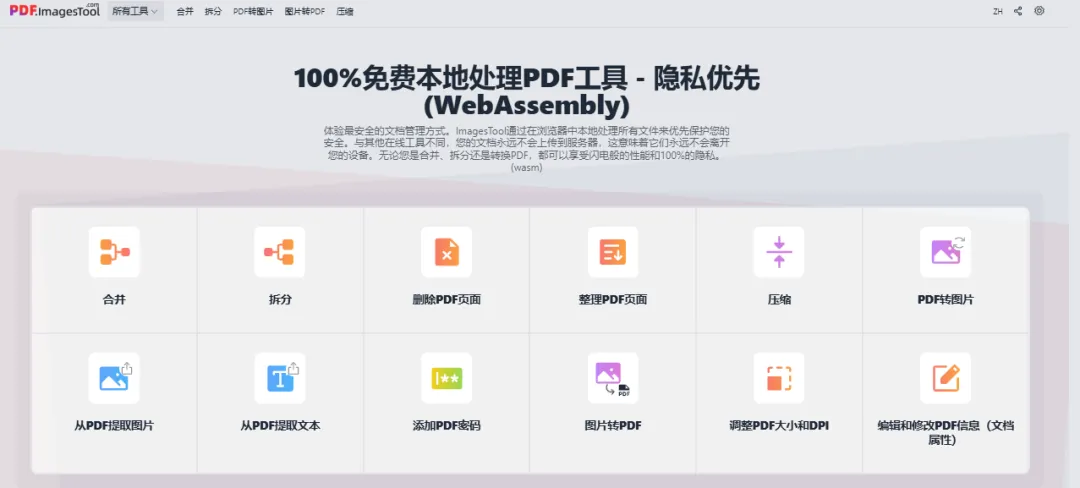
日常工作中经常会处理各类PDF文档,不少线上PDF平台需要把文档上传至服务器,对于含有敏感信息的材料,很多人会有所顾虑。这次体验的 pdf.imagestool,是依托WebAssembly技术运行的网页PDF处理站点,文档全部在浏览器本地设备完成运算处理,不会向外传输文件数据。
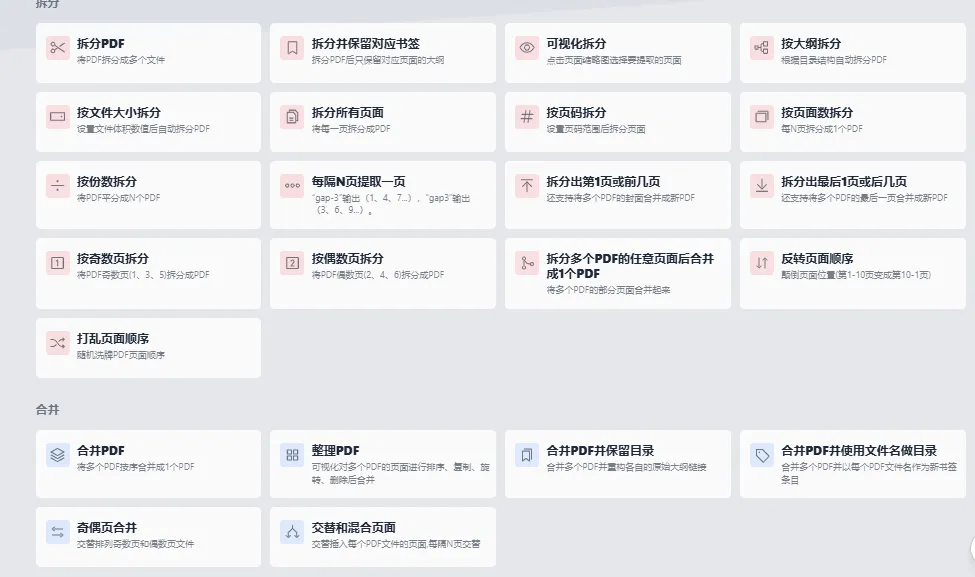
📑 覆盖的主要处理能力
▫️页面编排类
支持PDF合并、拆分,拆分支持按目录、页码、文件大小、奇偶页等多种规则;可以可视化调整页面顺序、删除多余页面、页面旋转、裁剪白边,也能够完成多页拼版、页面分割拼接等精细化排版操作。
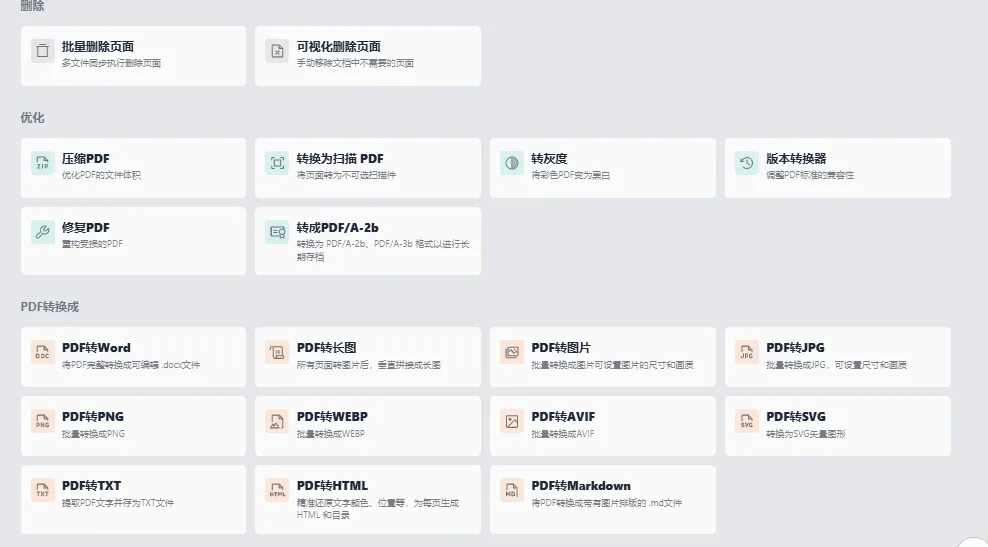
▫️文档优化与安全设置
可对文档进行体积压缩、转为灰度版本,也可以做文档修复、转换为归档专用PDF‑A格式;支持设置文档访问密码,也可以处理已加密文档的权限问题。
▫️格式互转与内容提取 支持PDF向图片、Word、TXT、Markdown、HTML等格式转换;同时支持图片、Office文档转为PDF。能够提取文档内部的图片、文字素材;扫描版PDF可以借助OCR能力识别印刷文字。
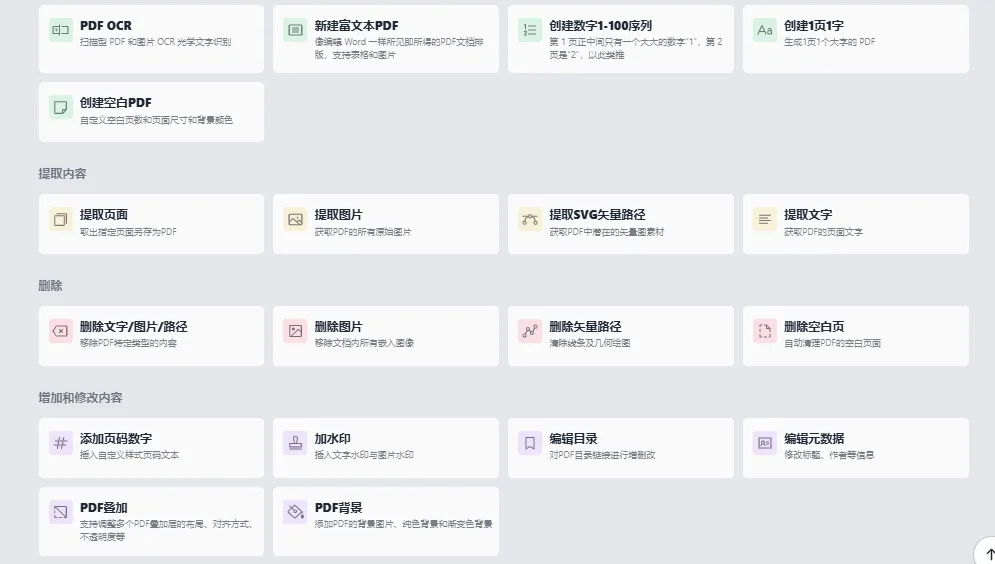
▫️附加编辑功能
可以添加水印、插入页码,修改文档元数据信息,也支持新建空白PDF、富文本PDF文档。整个平台无需注册账号,打开网页即可使用对应的功能模块。
📝 实测使用感受
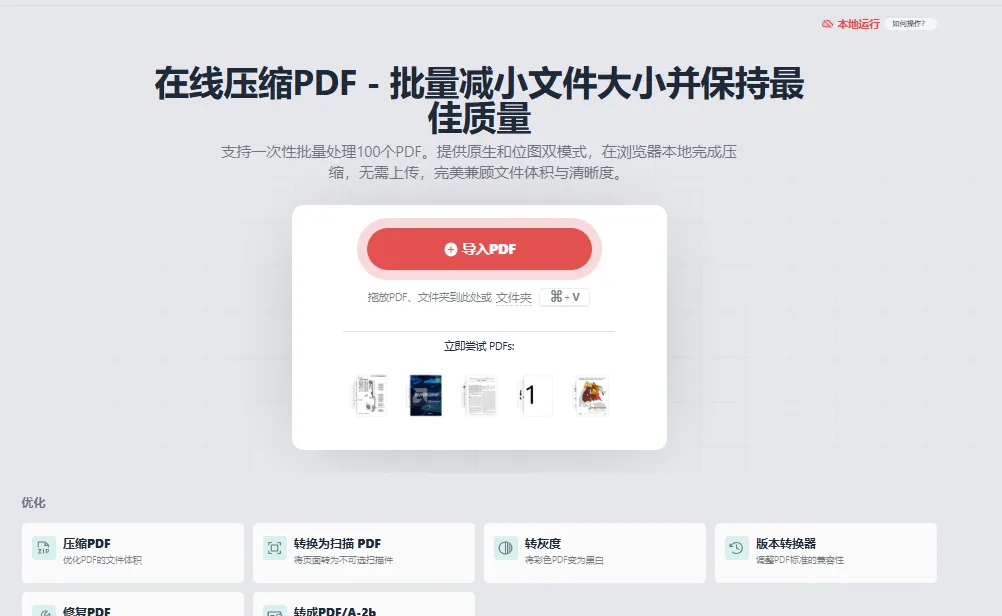
网页初次打开需要加载处理引擎模块,加载完成之后,即便断开网络,依旧可以继续完成PDF相关处理工作。 大体积、页数较多的文档,处理表现取决于电脑内存性能,过大的文件建议分批操作。它集合了非常多细分PDF处理能力,但复杂加密、损坏严重的文档,处理效果会存在不确定性。
⚠️ 需要留意的事项
处理各类文档,请确认手中素材具备合法使用权限,遵守著作权相关法规。 OCR识别效果取决于原始文档清晰度,识别后的文字建议人工复核校对。 网页受浏览器沙盒机制约束,超大文件会受设备硬件条件限制。 本文仅客观科普功能,不对处理结果、站点稳定性做担保。
💬互动话题
平时处理PDF,你会更介意文件上传云端,还是更看重操作简单省事?在PDF处理过程里,你遇到过最棘手的问题是什么?欢迎在评论区聊聊你的经历。
关注本号,持续带来各类网页工具客观实测分享。
点点“赞”,“分享”和“推荐”,给我充点儿电吧~ 需要私回:2026153451