ARTICLE · 1354637
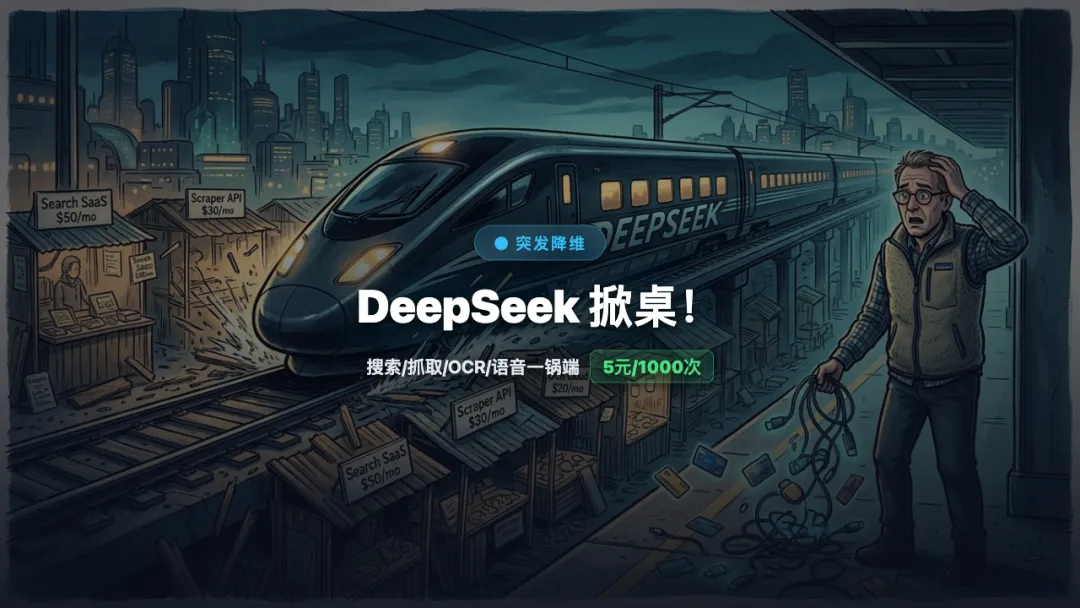
DeepSeek 突袭开放全套 App 工具链 API:搜索、OCR、抓取与语音一锅端,谁还在买第三方 SaaS?
> 声明:本文记录并交叉核验 2026 年 11 月 13 日 DeepSeek 官方开发者平台发布“全套 App 工具链 API”事件。文中关于接口规格、定价标准、AWS SageMaker 上架及中间件成本对比均为已核实事实;关于 SaaS 商业生态冲击与 Agent 架构重构为编辑技术研判。
深夜一点半,一位在深圳做自主研究 Agent 的独立开发者正盯着自己本月的账单发愁:给 Tavily 充了 25 美元搜索配额,给 Firecrawl 续了 30 美元网页抓取费,OCR 接口每月还得烧掉 15 刀,再加上语音识别与大模型 Token,一套跑得跌跌撞撞的 Agent 循环每个月固定要啃掉近两百美元。为了把这堆杂七杂八的服务粘在一起,他的 Python 脚本里塞满了 5 套 SDK、4 种重试逻辑以及密密麻麻的异常捕获。
紧接着,DeepSeek 开发者后台在 11 月 13 日悄悄推送了一行低调的公告:App 核心能力全面开放为独立与集成 API。
他点开文档,揉了揉眼睛,把那张定价表反复看了三遍:原生搜索 API 查一次 0.005 元人民币(折合 0.75 美元/千次),抓取网页直接回传干净的 Markdown 格式也是 5 块钱 1000 次,文档图片 OCR、语音识别 ASR、语音合成 TTS 全量打包在册;甚至只要在 deepseek-flash 对话参数里加上一句开关,模型就会自己完成多步联网推理与网页阅读。
他顺手写了个测试脚本敲下回车,看着终端瞬间吐出的结构化数据,瘫坐在人体工学椅上笑了出来——过去两年里无数 AI 创业者苦心孤诣搭建的技术护城河与月租收费站,在这一刻,被彻底打成了一个每天几毛钱的微小舍入误差。
昨夜,无数 AI 创业者的“中间商”饭碗被一锅端了
如果你在过去两年里关注过 AI 应用层的创业潮,你会发现一个心照不宣的秘密:市场上超过 80% 所谓的“自研 Agent 平台”或“垂类智能助手”,本质上都是极其脆弱的中间件拼装工。
用户的指令发进来,后台先拿关键词调一下 Google 或 Bing 的搜索代理(比如 Serper 或 Tavily);搜出来的几十个网页链接,再派无头浏览器集群(比如 Browserless 或 Firecrawl)吭哧吭哧扒下来清洗成 Markdown;遇到 PDF 或图片财报,再转发给第三方的 OCR 云服务做版面分析;最后,把这一大坨清洗过的上下文打包扔给 GPT-4o 或 Claude,让大模型生成一篇总结。
这个链路不仅长得像多米诺骨牌——任何一个环节挂掉都会导致整个 Agent 任务超时中断,更致命的是它的计费剪刀差。
为了维持这条复杂的链路,开发者必须同时维护三到五个不同的 SaaS 账号,每个服务都有单独的最低充值门槛、并发限制和冷启动延迟。而那些以此为核心商业模式的中间件公司,靠着给大模型“喂水喂粮”,估值轻轻松松被吹到了几千万甚至上亿美元。
但所有人都在假装看不见那个房间里的大象:大模型厂商自己就有一套世界上最强大的原生工具链,它们之所以没开放,只是腾不出手。
11 月 13 日,DeepSeek 终于腾出手了。它没有搞隆重的线上发布会,也没有发煽情的公关稿,只是把自家日活千万级 App 底层最核心的轮子,原原本本地做成了标准 HTTP 接口,明码标价挂上了货架。
5 块钱 1000 次:当梁文锋决定把自家 App 的底裤公开卖
这次开放的规格,几乎是对着现有工具链市场“抄家式”的无死角覆盖。
DeepSeek 这次并没有耍“大模型全家桶强制绑定”的把戏,而是非常清爽地把能力拆解成了两套调用形态:
第一种是模型原生集成参数(Integrated Chatbot Tools)。在调用主力推理模型 deepseek-flash(DeepSeek-V4.1-Flash-1017)的标准端点时,开发者只需要声明参数: - deepseek_web_search:打开它,模型自己决定什么时候去全网搜索。在常规模式下它返回带索引的网页摘要;而在“深度思考(Thinking)”模式下,它会自发执行多轮假设、自主拆解搜索词、多跳交叉核验,甚至自动把关联链接全部读一遍; - deepseek_read_url:用户在聊天框里随手扔一个长文章或财报链接,模型底层自动调用无头引擎渲染拉取,把清洗干净的内容注入上下文; - File Input:支持直接上传 PDF、Word、Office 文档和高清图片,底层自研 OCR 引擎自动完成复杂的双栏排版重构与表格提取。
第二种则是真正让独立开发者尖叫的原子级独立 API(Standalone Tool APIs)。如果你只想把它的工具嵌入到你自己的开源框架或自研私有模型中,DeepSeek 同样奉陪: - POST /v1/tools/search:调用 DeepSeek 自建的高速网页搜索引擎,直接返回结构化的高质量网页列表; - POST /v1/tools/fetch:给它一个 URL,它负责搞定渲染、绕过基础反爬、剔除牛皮癣广告,直接返回清洗后的纯粹 Markdown; - POST /v1/tools/ocr:图片与扫描件高精度文字与版面识别; - POST /v1/tools/asr:语音转文字端点,支持 16-bit PCM WAV 和 Ogg Opus 格式,单次支持最长 120 秒音频(最大 8 MiB),最绝的是无需指定语言参数,全球主流语言自动识别; - POST /v1/tools/tts:文本转自然拟真语音。
Search API (/v1/tools/search) | ¥5.00 / 1,000 次 | ||
Fetch API (/v1/tools/fetch) | ¥5.00 / 1,000 次 | ||
OCR API (/v1/tools/ocr) | |||
ASR API (/v1/tools/asr) | |||
TTS API (/v1/tools/tts) | |||
| Flash 核心模型推理 |
更绝的是梁文锋团队的极客作风:为了彻底打消开发者的顾虑,他们甚至在 GitHub 上直接开源了一套完整的 Web 聊天前端示例工程。开发者只要拉下代码,填入自己的 DeepSeek API Key,10 分钟内就能在本地或内网完整复刻出一个具备搜索、读文件、语音交互的 1:1 像素级 DeepSeek 官方网页端。
那些靠“套壳+抓取”融了数百万的 SaaS,正在连夜改 PPT
商业世界的残忍之处在于,当一个底层的巨头决定把自己用得顺手的工具按成本价开放时,它往往不是故意要针对谁,它只是在“清扫战场”,而中间商们却要付出整个商业模式崩塌的代价。
让我们来算一笔最直接的算力与工具链经济账单。
以一个每天需要执行 1,000 次深度行业研究任务的商业 Agent 团队为例。每一次任务平均包含:3 次全网关键词搜索、读取 5 篇长篇行业分析网页、解析 1 份 PDF 财报截图、最后由大模型综合生成一份 2,000 字的研究简报。
在旧时代,团队采用硅谷标准的“中间件组合拳”: - 搜索选用 Tavily 或 Serper:3,000 次查询 ≈ 24 美元; - 抓取选用 Firecrawl 或定制爬虫代理:5,000 个网页渲染抓取 ≈ 25 美元; - OCR 选用第三方文档解析 SaaS:1,000 次解析 ≈ 8 美元; - 模型选用 GPT-4o 或 Claude 3.5 Sonnet:阅读上下文加输出 ≈ 18 美元; - 单日合计成本:约 75 美元(折合人民币约 540 元),一个月就是 2,250 美元。
而现在,如果把整套架构无缝切到 DeepSeek 的原生全家桶: - 3,000 次 Search API:15 元人民币(约 2.1 美元); - 5,000 次 Fetch API(直出 Markdown):25 元人民币(约 3.5 美元); - 1,000 次原生文档 OCR:约 5 元人民币(约 0.7 美元); - DeepSeek-V4.1-Flash 消耗数百万 Token:约 10 元人民币(约 1.4 美元); - 单日合计成本:约 55 元人民币(约 7.7 美元),一个月仅需 230 美元!
成本整整暴跌了近 90%!
更致命的是延迟与稳定性的几何级提升。在以前,你的服务器要把数据在五个不同的云服务商之间倒腾五次,任何一处出现网络抖动、Token 过期或速率限制,整个 Agent 就会像断了线的风筝一样抛出 UnhandledPromiseRejection。
而在 DeepSeek 的原生链路里,所有的工具调用都发生在模型服务器内部的局部网络,甚至在一次 HTTP 交互中由模型自行串联。那些依靠在开源爬虫工具外层套个 Stripe 充值框就敢每年收 299 美元会员费的创业项目,生存空间在昨夜被彻底压缩成了真空。
算力账单的残酷真相:从“拼积木”到“大一统原神”
DeepSeek 为什么要掀翻这个桌子?梁文锋难道是在做慈善吗?
当然不是。在这一波看似“做善事砸低价”的背后,藏着极其凶猛的算力飞轮防御战。
- 抢夺高频 Agent 的网络入口
: 纯粹的对话模型是极易被替换的。今天开发者觉得 DeepSeek 便宜就用 DeepSeek,明天若有新模型微调后降价,开发者改一行 API Base URL 就能掉头跑路。但如果你的整个 Agent 体系深度依赖了它的 tools/fetch、它的 OCR 双栏还原逻辑、它的原生结构化搜索结果,你的业务就跟它的基础设施彻底焊死在了一起。工具链才是锁死开发者的真正护城河。
- AWS 与全球算力生态的纵深落地
: 就在同一周(11 月 11–12 日),亚马逊云科技(AWS)正式宣布 DeepSeek 的旗舰 MoE 家族——包括 DeepSeek-V4-Pro、DeepSeek-V4-Flash 以及最新的 DeepSeek-V4.1-Flash,正式全量上架 Amazon SageMaker JumpStart。这意味着全球跨国大企业和合规机构,无需越境调用,直接在自家的 AWS VPC 内部就能一键拉起完全合规的私有化权重。
- 英伟达新一代架构的极致吞吐收割
: 根据开源推理引擎 vLLM 联合英伟达发布的实测报告,DeepSeek-V4.1-Flash 在英伟达最新一代 Vera Rubin NVL72 机架级硬件上,实现了机架级共享内存池化(Rack-Scale Shared-Memory Pooling)的突破性适配。其推理吞吐量与首字延迟(TTFT)再次刷新了行业纪录。这意味着,DeepSeek 敢把 API 卖到 5 块钱 1000 次,是因为它的单次推理和服务边际成本,已经被压到了竞品不可思议的物理极限。
大模型竞争的上半场是“拼参数、拼跑分”的象牙塔较量;而下半场,则是比拼谁能以最低的边际成本、最稳的工业管网,把算力、数据清洗、多模态解析打造成像自来水和自来电一样的公用基础设施。
读者当下动作清单:你的 Agent 技术栈该怎么重构?
作为一名站在第一线的极客、开发者或技术负责人,面对这场工具链大清洗,你现在应该做些什么?
- 果断审计你的 SaaS 账单,清退昂贵冗余的搜索与抓取订阅
: 立即检查你的产品依赖。如果你的系统目前只是用第三方服务做常规公网资讯检索、行业网页拉取或通用文档转 Markdown,请毫不犹豫地开辟一个灰度分支接入 DeepSeek 的 /v1/tools/search和/v1/tools/fetch。按 1000 次 5 块钱的成本核算,绝大多数中小开发团队的账单可以直接砍掉一个数量级。
- 别盲目神化:分清哪些极端边界仍需独立工程防御
: 天下没有万能的银弹。DeepSeek 的 Fetch 和 Search 适合应对绝大多数标准网页和开放资讯,但如果你面对的是带有极高防护等级的 Cloudflare Turnstile、高度复杂的航空票务反爬、或者需要深度登录态协作(比如操作带风控的后台管理系统),原生 Fetch 依然可能会遭遇 403 阻断。在这些深水区,你依然需要保留本地真实浏览器或专用代理方案(比如我们在系统内坚持使用直连真实 Chrome 的 browse机制)。
- 对于多模态语音与文档场景,全面尝试大一统端点
: 如果你的业务涉及大量的录音转写与长音频粗读,别再费心去配置各种复杂的开源 Whisper 镜像了。DeepSeek /v1/tools/asr提供的无参数多语言自动识别,足以覆盖 90% 以上的标准办公音频分析诉求,能省下大量的 GPU 实例闲置费用。
套壳者的丧钟已经敲响,而真正专注在业务逻辑与深度工作流上的工程师,迎来了有史以来弹药最充足、成本最廉价的黄金时代。
【来源与证据清单】 1. DeepSeek 开发者平台:Application APIs 与工具链官方接口文档(2026-11-13)(一手发布) 2. 亚马逊云科技官方博客:DeepSeek-V4 全系列 MoE 模型正式上架 Amazon SageMaker JumpStart(2026-11-12)(云巨头通报) 3. vLLM 与英伟达工程团队联合评测:DeepSeek-V4.1-Flash 在 Vera Rubin NVL72 上的机架级共享内存池化吞吐基准(2026-11-11)(独立评测)