ARTICLE · 1359759
大数据中台全套源码直接开源!企业免费用还能商业化真的靠谱吗
这两天技术圈炸锅了!一套完整的大数据中台,不仅把全部源代码100%交付,还允许免费用于商业项目,不用再掏动辄百万的授权费,多少老板看完直接拍桌子要技术团队立刻评估。
以前一提大数据中台,中小企业基本绕不开三座大山:头部厂商报价动辄上百万,功能臃肿还得配专属运维团队;网上零散开源组件东拼西凑,兼容性坑多,出了问题连个兜底的人都找不到;数据资产散落在业务系统里,想做经营分析得等技术部门排期半个月,黄花菜都凉了。
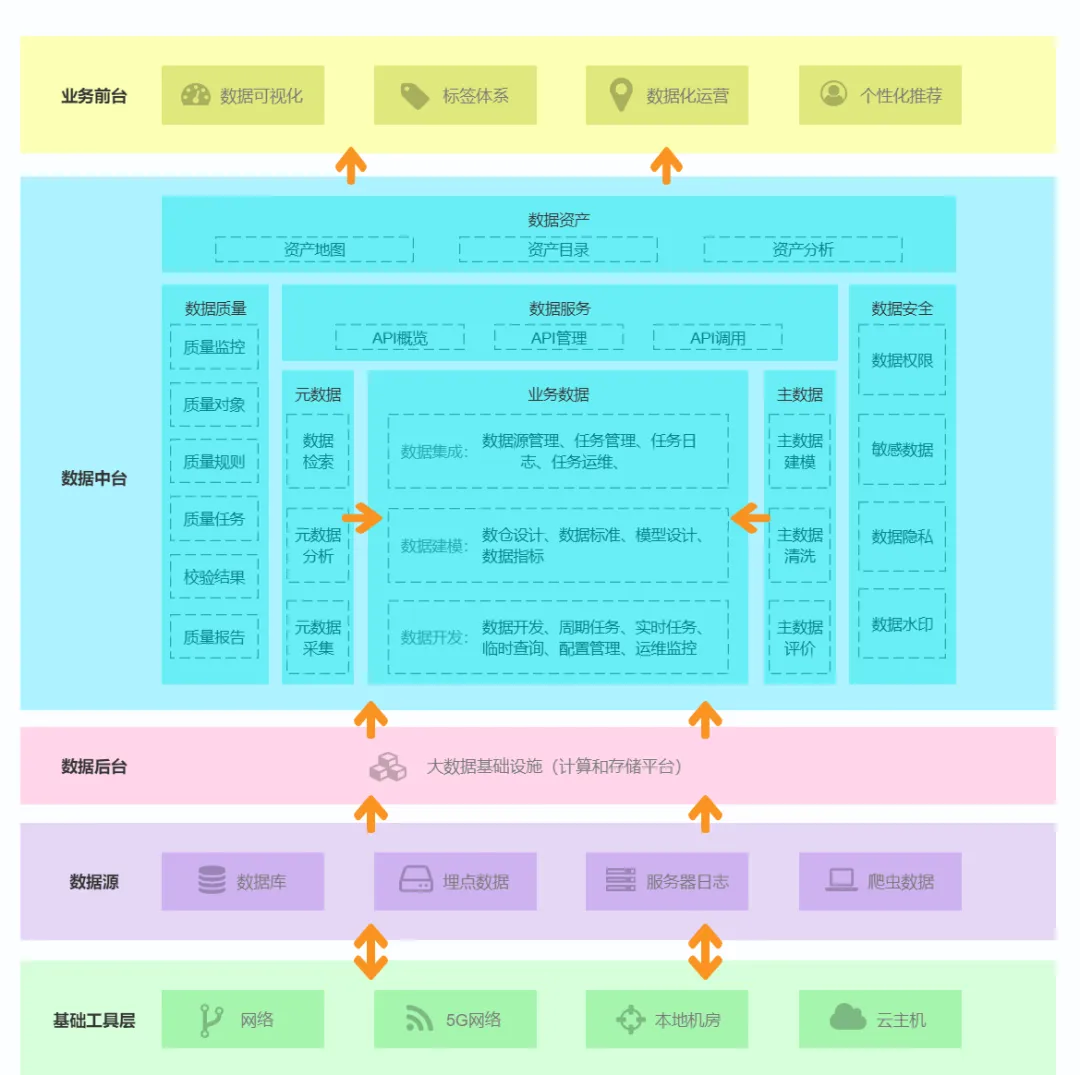
这次开源的蓝树大数据中台,直接把企业级能力全部摊开,从数据接入、治理到可视化、任务调度全链路打通,没有功能阉割,也没有隐藏的商业版门槛,拿到源码就能二次开发,直接上线跑业务。


这套中台最狠的地方,是没有拿半成品糊弄人,十大功能模块全是企业实际跑业务的刚需,每个模块都有成熟的可视化界面,不用从零敲代码搭界面。
全域数据源接入中心
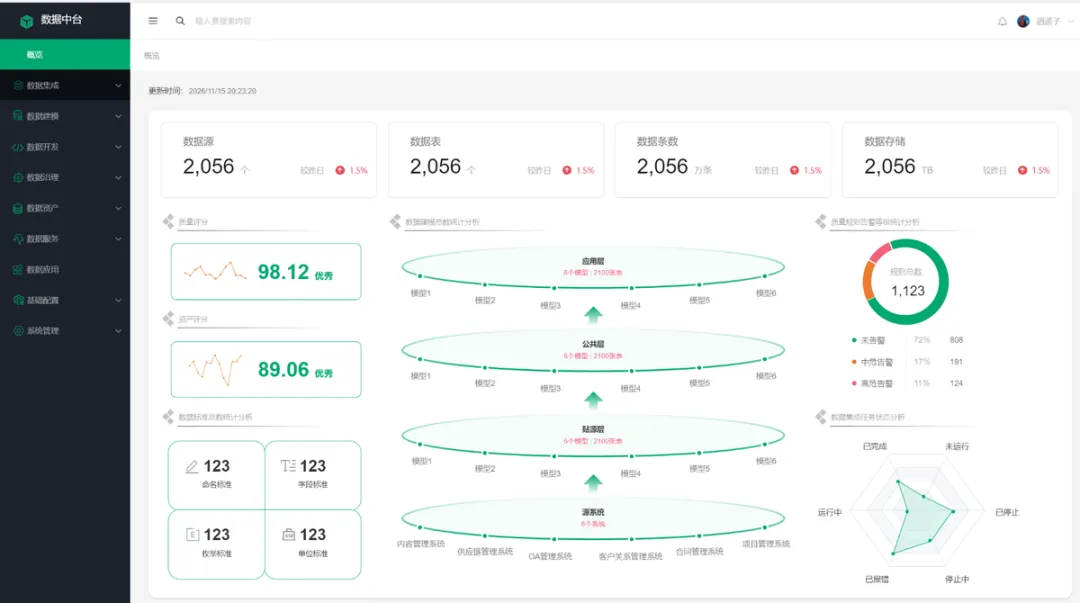
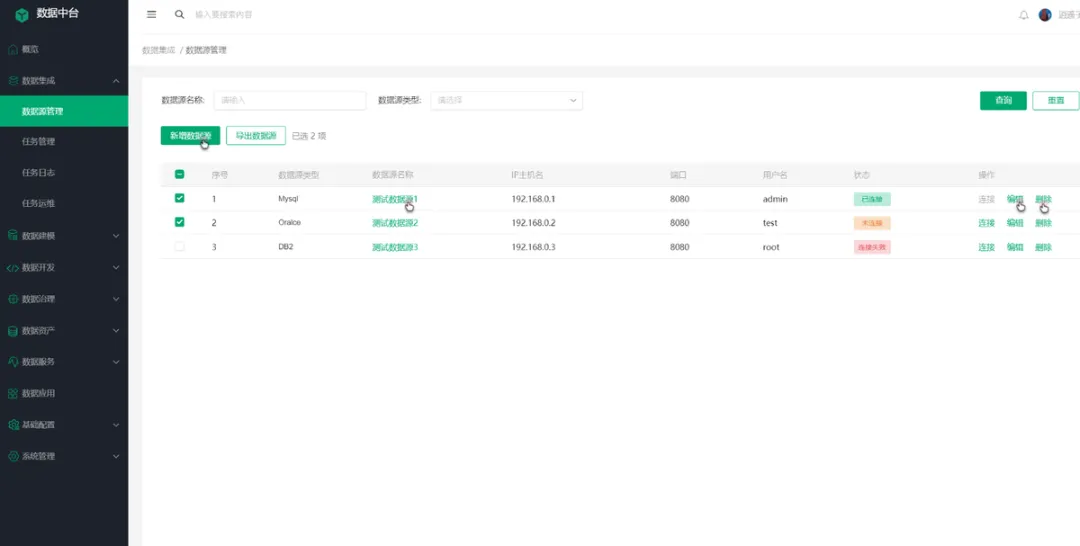
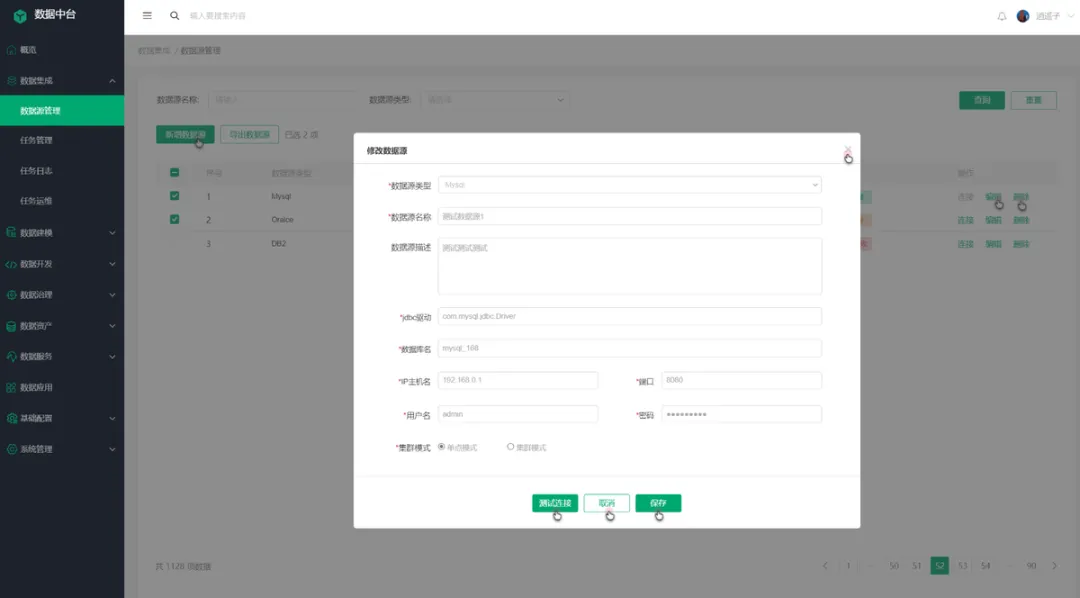
企业最头疼的信息孤岛问题,在这里直接被摁死。这个模块支持MySQL、Oracle、SQL Server等主流关系型数据库,也能对接MongoDB、Redis这类非关系型数据源,就连FTP文件、API接口、IoT设备实时流数据都能一键接入。
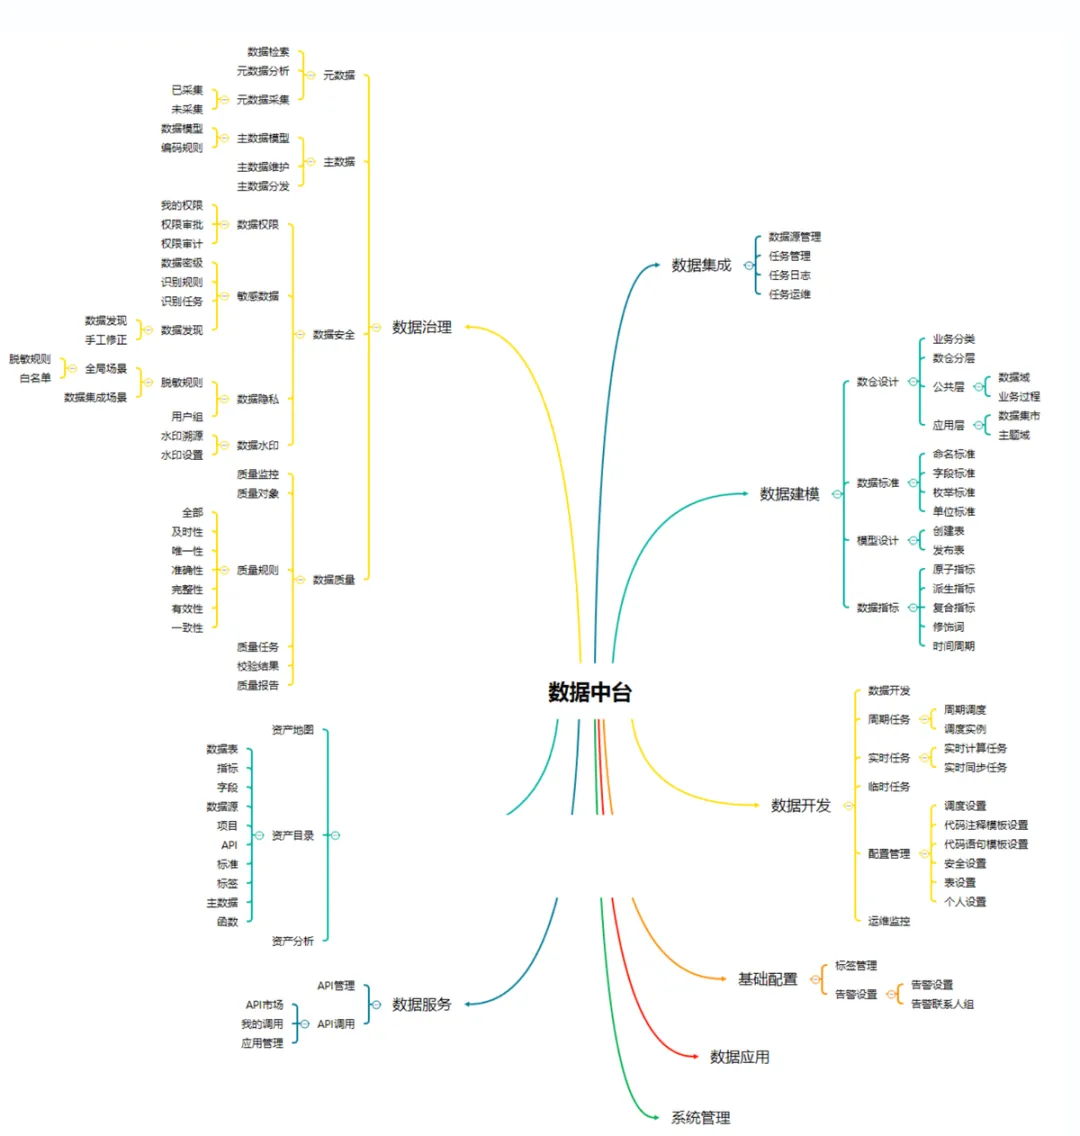
界面上能直接看到所有数据源的连接状态、同步频率、数据量波动,不用写复杂的连接脚本,业务人员填完账号密码就能测试连通性。数据源类型覆盖超过50种,不管是老旧的ERP系统,还是刚上线的小程序后台,都能把数据抽进来。
可视化ETL数据加工工厂
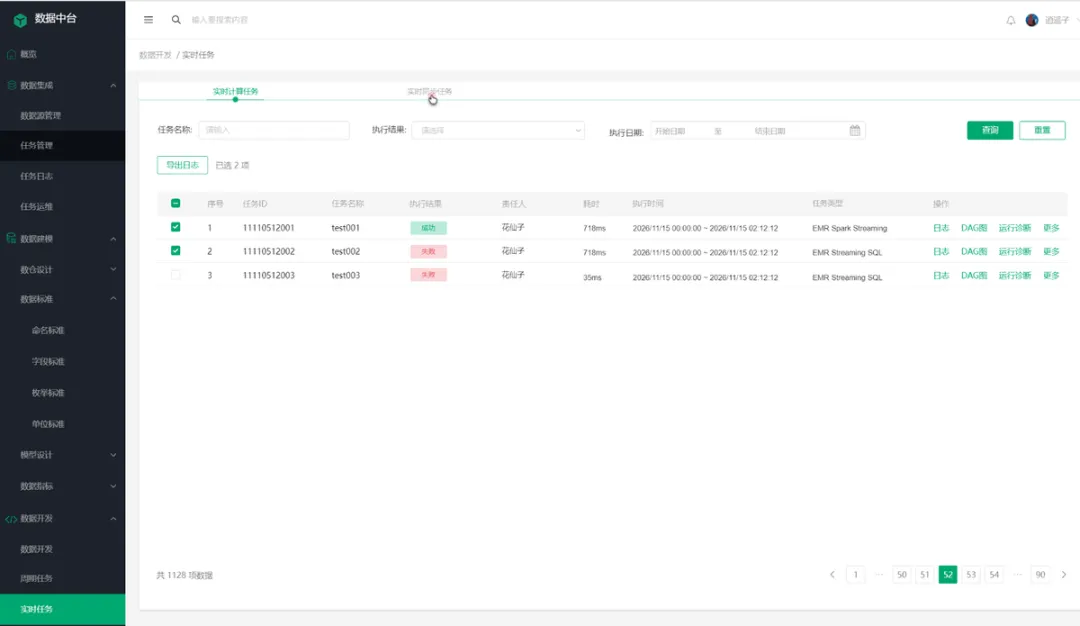
传统做数据清洗,得数据工程师写几百行SQL,业务人员看不懂也改不了。这个模块把清洗、转换、合并、脱敏这些操作全做成了拖拽式组件,过滤空值、字段拆分、格式统一、多表关联,拖拖拽拽就能生成加工流程。
系统自带校验规则,加工逻辑有问题会实时飘红提示,还能预览每一步处理后的数据样例,不用等任务跑完才发现错误。就算是刚入行的数据分析专员,半天就能上手做简单的数据清洗,不用全堆给技术部。
分布式任务调度引擎
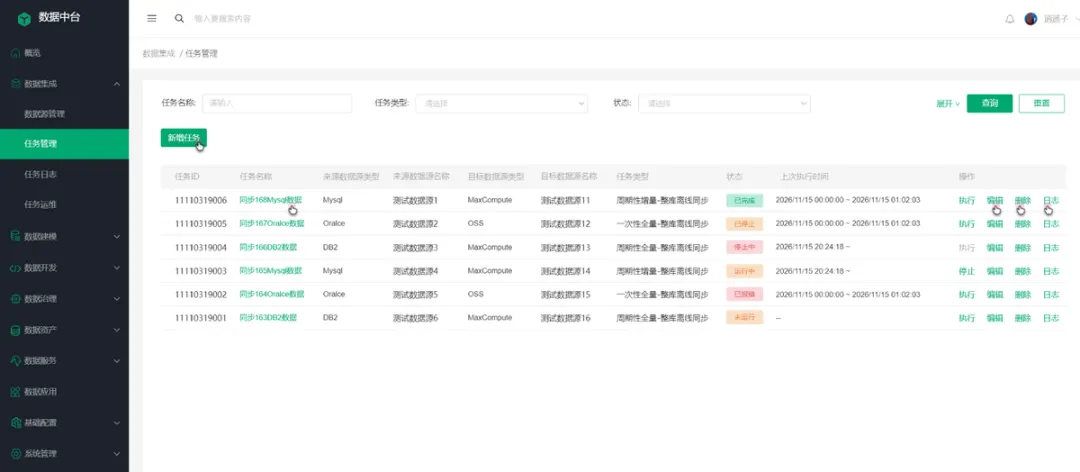
数据同步、报表计算这些定时任务,最怕半夜宕机没人管。这个模块支持分布式集群部署,任务断点续跑、失败自动重试、超时告警,还能设置任务依赖,上游数据没跑完,下游任务绝对不会瞎启动。
调度面板上能看到每个任务的运行时长、成功率、资源占用,支持分钟级到年级的调度周期,单集群可稳定承载10万级定时任务,双11这种业务高峰也不会出现任务堵死的情况。
主数据管理中心
客户、产品、供应商这类核心主数据,各部门口径不统一是老大难问题——销售部的客户等级和运营部的标准不一样,算出来的复购率能差出20%。这个模块专门做主数据建模、编码规则统一、数据质量校验,还带审批流,修改主数据得对应负责人审核才能生效。
系统会自动识别重复的主数据记录,提示合并方案,从根源上解决“一物多码、一人多档”的乱象,全公司的数据口径终于能对齐。
数据资产目录门户
很多企业数据攒了一堆,用的时候根本不知道有什么、存在哪、谁负责。这个模块会把所有表、指标、标签、报表自动编目,配上业务描述、责任人、更新频率,像查图书馆目录一样搜关键词就能找到对应数据。
还能给数据分级分类,核心敏感数据自动加权限标识,普通员工连表名都搜不到,合规风控直接省了大量排查工作。
智能数据质量监控平台
数据错了、漏了,往往等业务决策出问题才发现。这个模块内置完整性、准确性、一致性、及时性四大类近百种校验规则,比如订单金额不能为负、客户手机号必须11位、日订单量波动超过30%自动触发告警。
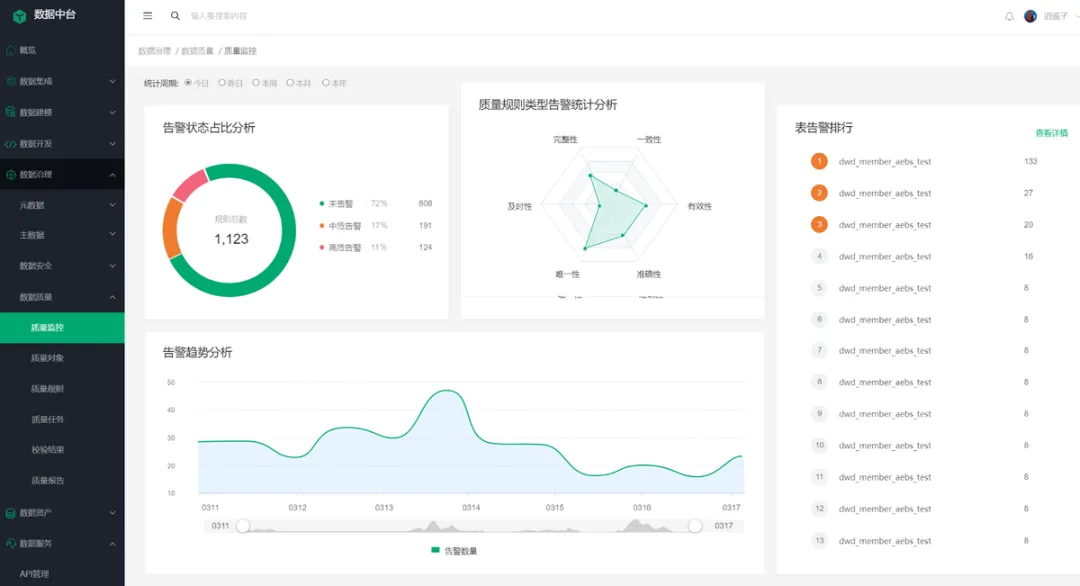
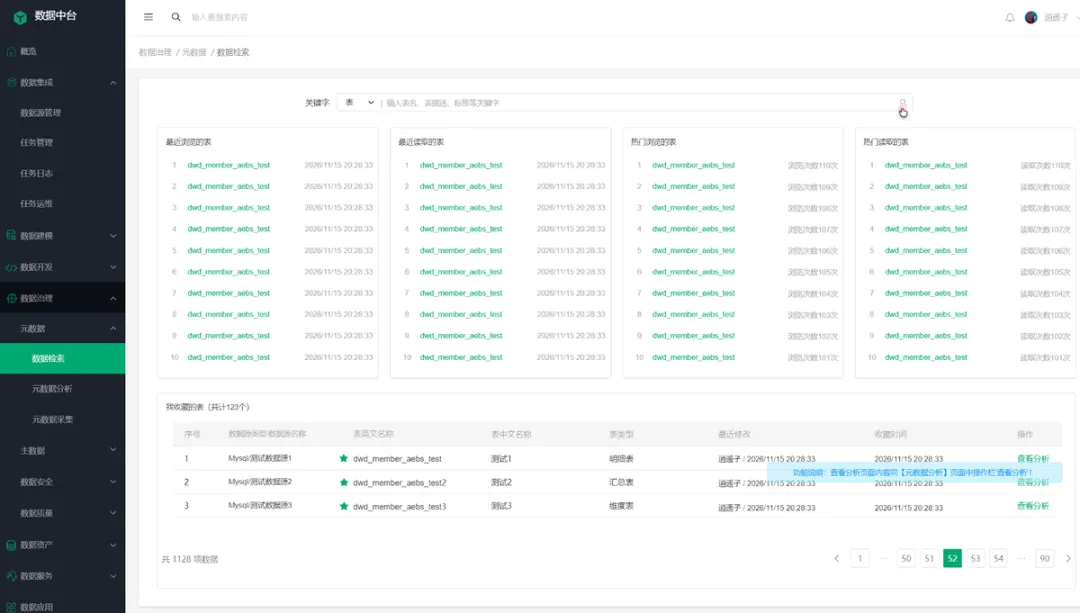
每次校验自动生成质量报告,问题数据精准定位到具体字段和责任人,还能统计各部门数据质量得分,整改情况直接可视化,不用再人工挨个核对。
自助式BI可视化分析平台
老板要经营报表,不用再等技术排期。这个模块自带几十种图表组件,柱状图、折线图、漏斗图、地理热力图、大屏模板随便选,拖拽维度和指标就能生成报表,支持钻取、联动、切片分析。
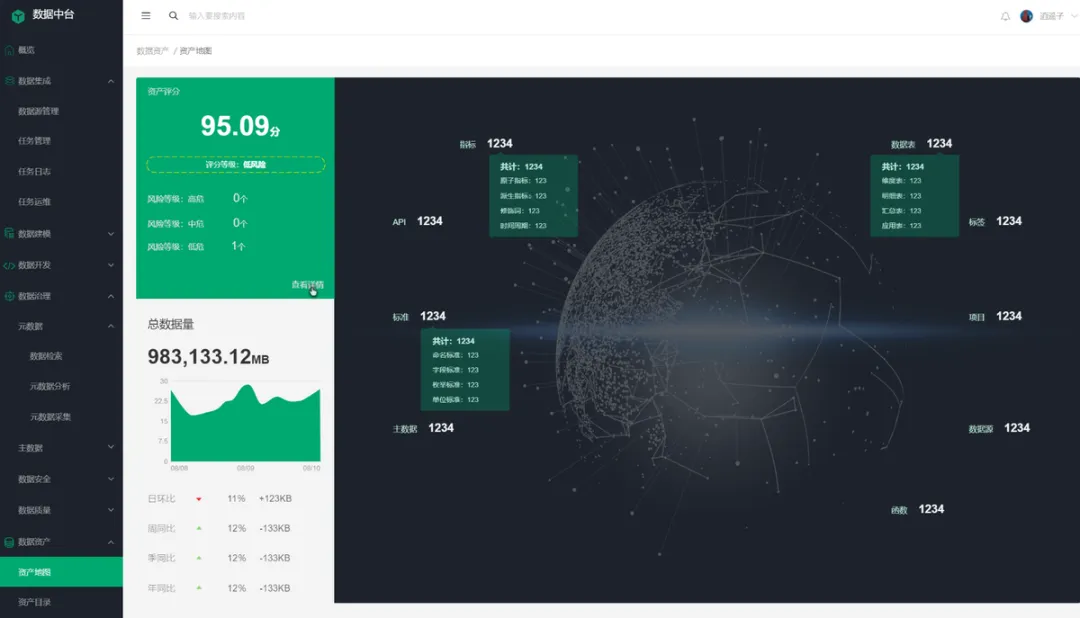
做好的报表可以一键分享给同事,设置查看、编辑权限,还能定时推送到企业微信、钉钉,零代码就能搭建总裁驾驶舱、销售实时大屏,业务部门自己就能搞定分析需求。
实时数据计算引擎
线下门店的实时客流、直播间的实时成交额,等T+1离线数据根本跟不上节奏。这个模块基于Flink实现流式计算,支持毫秒级数据延迟,窗口聚合、实时标签、异常行为检测都能直接配置。
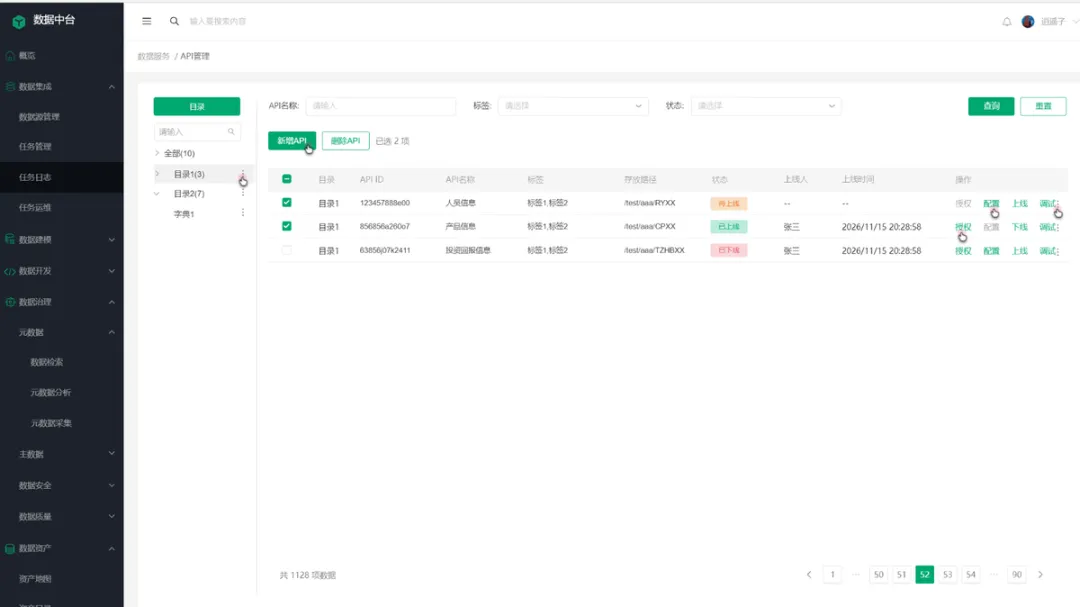
电商大促的时候,技术人员能在面板上实时看到数据延迟、吞吐量、资源占用,出现流量突增自动扩容,不用人工盯着服务器调参数。
统一数据权限管控中心
数据安全是企业的红线,这个模块把权限拆成了数据源、表、字段、报表、功能多个层级,支持按部门、角色、岗位授权,甚至能做行级权限——区域销售只能看到自己负责省份的客户数据,碰不到其他区域的信息。
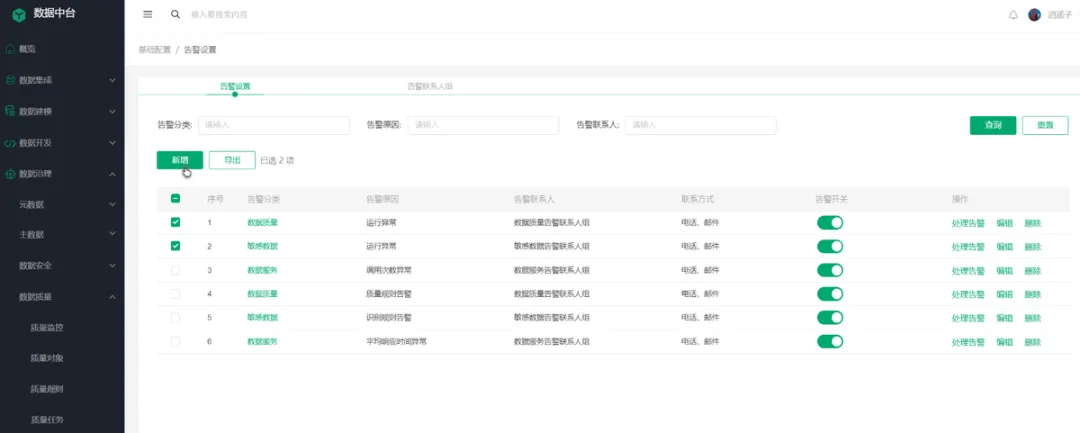
所有数据访问操作全留痕,谁在什么时候查了哪张表、导出了多少数据,审计日志里一清二楚,等保测评的时候直接导出日志就行,不用额外补审计体系。
数据标签与用户画像平台
做精准营销、客户分层,全靠标签体系。这个模块支持规则标签、SQL标签、算法标签三种模式,把用户的消费行为、浏览记录、客服沟通记录整合到一起,自动生成360度用户画像,还能圈选人群包一键同步到营销系统。
零售企业可以快速筛选出“近30天加购未下单、客单价高于平均水平”的客户,定向发优惠券,转化率比群发至少提升40%。
看到这里,建议你把文章转发给公司的技术负责人和业务老板,这套能免费商用的开源中台,大概率能帮你们省下几十万的软件采购预算。


光有功能不算本事,能解决实际业务问题才是硬通货。从社区已有的落地案例来看,零售、制造、政务服务类企业都能快速适配,不用推翻现有系统从零重建。
连锁零售全域经营分析场景
某区域连锁零售品牌有42家线下门店,还有小程序商城和第三方外卖店铺,以前各渠道数据存在不同系统里,每天对账要3个财务花半天时间,库存数据滞后,热销品经常断货,滞销品堆在仓库占压资金。
上线这套中台之后,所有门店POS、电商订单、仓储库存、会员数据实时接入,ETL模块自动完成订单清洗和库存对账,数据质量规则自动识别异常订单。BI平台搭建的经营大屏,老板在手机上就能实时看到每家店的销售额、客单价、库存周转天数。
库存预警规则会在某款商品库存低于安全线时自动给仓管发提醒,滞销品也会按周转天数自动排序,运营人员针对性做促销清库存。落地半年,企业库存周转天数下降27%,财务对账人力成本减少60%,再也没出现过热销品断货一周的乌龙。
离散制造生产能耗管控场景
一家汽车零部件制造工厂,车间里有200多台生产设备,以前设备运行数据、能耗数据、质检数据分散在工控系统和ERP里,管理者想知道哪台设备能耗高、次品率和设备参数有没有关联,得让信息科导数做表,最快也要两天。
通过中台的IoT数据源接入能力,所有设备的实时运行数据、电表能耗数据自动采集,实时计算引擎按设备、车间、产线维度统计能耗和OEE设备综合效率,质量模块关联质检数据做根因分析。
工厂给每台设备设置了能耗阈值,设备空载超过10分钟自动告警,还能通过数据定位到“温度参数超过设定值2%时,次品率提升8%”的关联规律。落地后车间单位产值能耗下降19%,设备异常停机时间减少32%,每年光电费和废品损失就省出近两百万。
政务服务数据共享协同场景
某区县政务服务中心,以前社保、民政、住建的系统各自独立,群众办业务要反复交材料,工作人员也要跨系统查数据,办事效率上不去,投诉量一直居高不下。
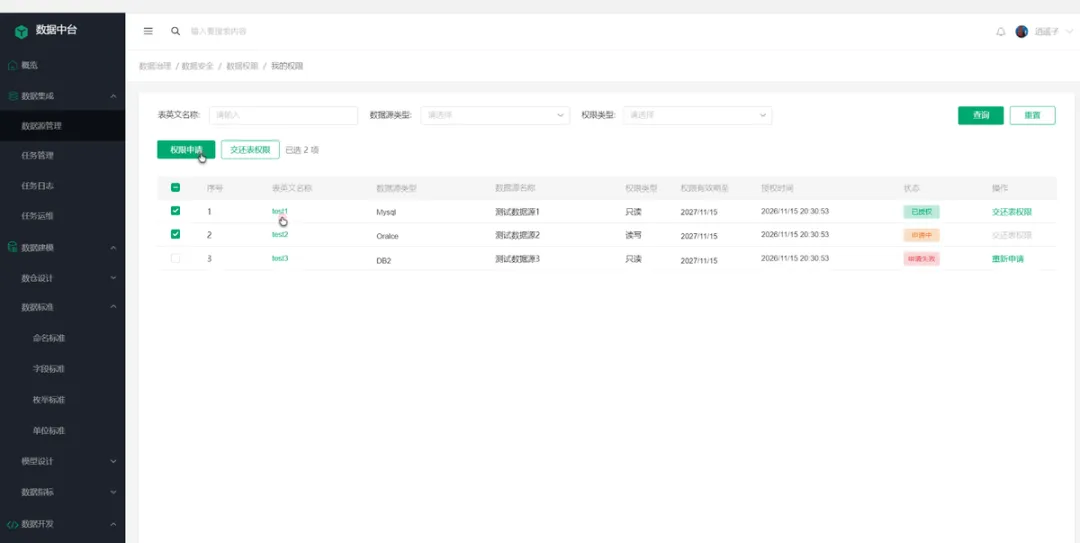
依托这套中台搭建政务数据共享交换平台,主数据管理中心统一了人口、法人、电子证照的核心编码,数据资产目录把各部门可共享的数据编目公示,权限管控中心严格划定数据调用范围,所有访问全程留痕符合政务数据安全规范。
现在群众办营业执照、社保补贴这类业务,能通过共享数据调取的证照一律不用群众提交,平均办事时长从45分钟压缩到12分钟,材料提交数量减少68%,还通过多部门数据联动,精准识别出违规领取补贴的人员,避免财政资金流失。


很多人对中台的印象是“重投入、长周期、养团队”,这套开源中台恰恰反着来,从轻量化、生态、成本三个维度拆掉了中小公司的使用门槛。
轻量化部署,低配服务器也能跑起来
不少商业中台一上来就要求十几台服务器起步,光硬件成本就得几十万。这套开源中台做了微服务架构拆分,支持单机部署、集群部署、容器化云部署多种模式,最小配置4核8G服务器就能跑通核心功能,初创公司用一台云主机就能先搭测试环境验证。
部署过程提供可视化安装向导,不用手工敲一堆部署命令,运维人员跟着指引半天就能完成基础环境搭建。后续业务扩张了,再按需加节点扩容,不用一次性砸钱买大量硬件,也不用被迫替换现有系统,对接老数据源的适配成本极低。
生态兼容能力强,不用被单一厂商绑定
这套中台没有做封闭生态,主流的大数据组件像Hadoop、Spark、Doris、Kafka都能无缝对接,企业原来已经在用的组件不用废弃,直接接入整合就行。源代码完全开放,企业有个性化需求,自己的技术团队就能改,不用看厂商排期脸色,也不用担心厂商停止服务后系统直接废掉。
社区还在持续更新适配国产化环境,支持麒麟、统信操作系统,以及国产数据库和中间件,有信创需求的企业也能直接用。配套的文档、部署教程、常见问题手册都很全,社区里还有不少开发者分享二开插件,踩坑了能找到大量参考经验。
实打实降本增效,投入产出账算得明明白白
以前买一套商业大数据中台,基础授权费几十万起步,每年还要交15%-20%的维保服务费,定制开发另外按人天收费,中小企业根本扛不住。这套中台采用开源免费可商用协议,企业不用花一分钱授权费,源代码直接拉下来就能用,也没有按用户数、数据量收费的隐形条款。
结合前面的零售和制造案例来看,企业只需要承担少量服务器成本和内部人力成本,快的话一两个月就能上线核心场景,不用等半年一年的实施周期。业务人员能用自助ETL和BI自己处理分析需求,技术团队不用天天接取数报表的需求,人力精力能放到更核心的业务创新上,综合成本相比采购商业方案至少降70%。


很多人关心“免费商用”是不是套路,这里直接说清楚:项目遵循宽松的开源许可协议,企业内部使用、二次开发后对外提供商业服务都允许,不需要公开自己修改后的源代码,也不用额外付费购买授权,只要保留原始版权声明就行。
源码托管地址已经放在这里:
https://www.gitcc.com/jamiepine/lanshu-gitcc 仓库里除了完整后端、前端源代码,还有配套的部署文档、操作手册、数据字典、接口文档,新手也能跟着步骤一步步搭起来。
当然也得提醒一句,免费开源不代表零成本零风险。如果企业自身没有技术运维团队,也可以找社区服务商做付费实施、培训、兜底运维,但这完全是自主选择,不存在强制消费。企业上线前最好先在测试环境跑通业务流程,做好数据备份,再逐步迁移到生产环境。


为了方便大家评估落地,我们整理了一批行业资料,关注公众号「IT奋斗的青年」,在后台回复关键词【中台资料】就能免费领取:
《2024中国大数据中台建设行业白皮书》
《数据中台能力成熟度评估模型》(T/CCSA 标准文档)
《企业数据治理实施指南(GB/T 42752-2023)》
这套开源大数据中台的一键部署脚本与操作视频教程
关注「IT奋斗的青年」,后续你还能持续拿到开源项目深度测评、企业数字化落地实操方案、国产技术栈适配指南、技术选型避坑经验,帮你少走弯路,把技术投入真正转化成业务价值。
最后想问问大家:你们公司做数据建设时,最头疼的是系统打通难、数据质量差,还是采购预算不够?欢迎在评论区聊聊你的经历,点赞最高的三位读者,我们还会额外送出1小时免费的中台建设架构咨询服务。