ARTICLE · 1362676
数字人开源项目很多,但能“打断、并发、插件化”的没几个
数字人开源项目不少,但大多数停在“Colab 里跑一次”的阶段。能接住并发、扛住打断、让运维盯着两个指标判断是否实时、并且以 Apache 2.0 开放的,是另一类东西。
LiveTalking 属于后者。2023 年底开源,至今 GitHub 约 10.4k stars、1.7k forks,v2.0 完成了一次底层架构重构,把模型、TTS、推流全部插件化。它的定位很明确:不做数字人 SaaS,也不让你从零攒“TTS + 口型模型 + 推流”的管线,而是把这条链路收成一条可部署、可并发、可 API 驱动的 GPU 服务。
它到底在做什么:一条管线,四层结构
先看核心流程,一句话就能概括:
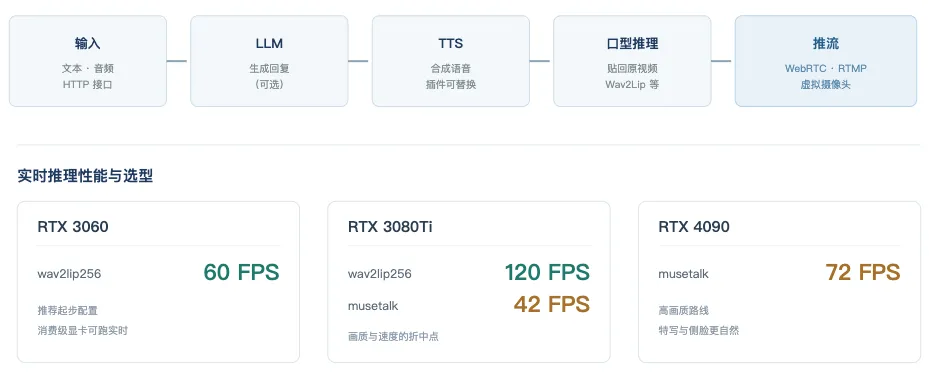
用户输入文字/音频 → LLM 生成回复(可选)→ TTS 合成语音 → 口型模型推理 → 后处理贴回高清原视频 → WebRTC / RTMP / 虚拟摄像头输出
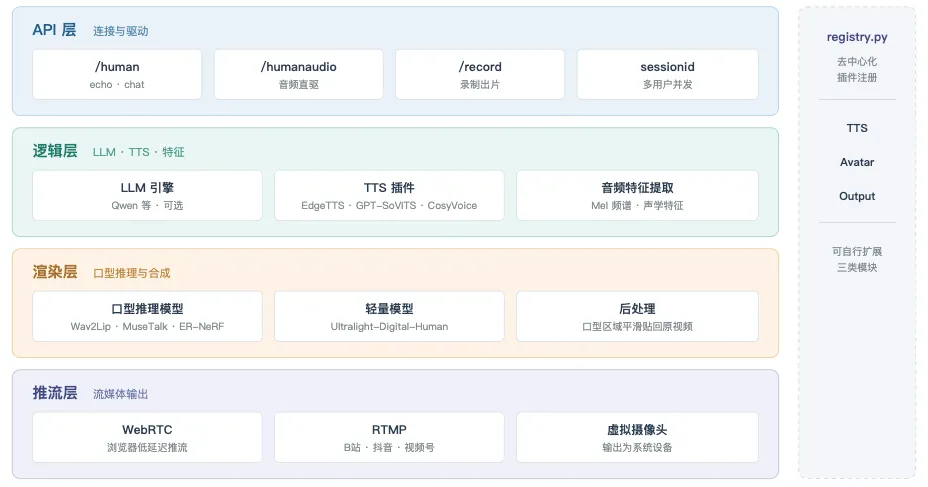
这条流程并不新鲜。LiveTalking 的工程价值在于把它拆成了清晰的分层,并且每一层都留了可替换的接口:
API 层负责连接与驱动。/human接收文本,echo模式直接复读、chat模式对接 Qwen 等 LLM;/humanaudio接收音频文件直接驱动口型;每个连接分配独立sessionid,多用户并发在 API 层就是原生支持的。
逻辑层承担 LLM、TTS 与音频特征提取。TTS 以插件方式接入 EdgeTTS、GPT-SoVITS、CosyVoice、腾讯云等方案,不绑定任何一家。
渲染层是口型推理的核心。支持 wav2lip、musetalk、ernerf、Ultralight-Digital-Human 四款模型,推理完成后只对口型区域做平滑贴回,全身画面保留原视频清晰度——这也是 wav2lip 这类“老”模型在直播场景依然够用的原因。
推流层独立为streamout模块,WebRTC、RTMP、虚拟摄像头并列管理,互不耦合。
v2.0 的关键变化:从“调用”到“插件”
如果只看功能表,v2.0 之前 LiveTalking 已经能跑通全链路。但 v2.0 做了一件对二次开发影响很大的事:把强耦合的调用方式拆成了插件系统。
数字人模型、TTS 语音合成、媒体流传输,全部改为按需配置的 Plugin 接入。底层抽出了BaseAvatar和BaseAsr两个基类,把口型推理、面部贴回、音频特征切分的公共逻辑收拢,新模型插件只需要实现自己的核心逻辑,代码量大幅下降。流媒体传输也从主流程中抽离,独立放在streamout目录下,RTMP 输出在 v2.0 原生加入,对接 B 站、抖音、视频号不再需要绕路。
一个值得留意的工程细节:项目在迭代中把 whisper 特征窗对齐从[0,5]调整到[2,3],消除了约 80ms 的系统性口型滞后。这种级别的修复不会出现在功能列表里,但它说明代码是在真实部署环境里磨过的。
性能:一张消费级显卡决定你能跑什么
数字人引擎的选型,最终绕不开一张表。
数据来源:官方文档与实测汇总。实时门槛是 25 FPS,但 LiveTalking 给出了一个更严格的运维判据:后端日志里inferfps(GPU 推理帧率)和finalfps(最终推流帧率)双双 ≥25,才算真正实时。
并发瓶颈的划分也很清楚:不说话时瓶颈在 CPU(每路视频压缩),同时说话时瓶颈在 GPU(每路口型推理)。这意味着部署规划不能只看显卡,CPU 的路数承载同样要算进去。
选型结论直截了当:wav2lip256 从 RTX 3060 起步,追求画面自然度上 musetalk 则从 3080Ti 起步。
“打断”为什么值得单独说
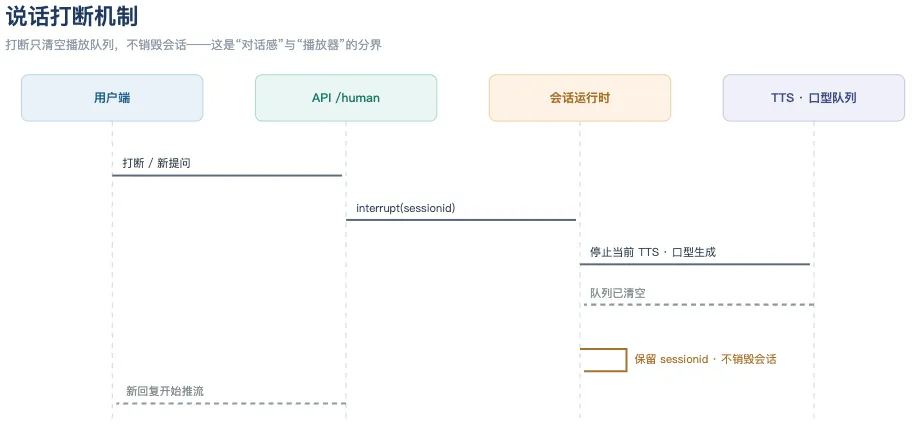
数字人“能说话”和“能对话”之间,隔着一个打断机制。
如果用户插话时数字人继续念稿,交互感立刻退化成“播放器”。LiveTalking 把说话可被打断做进了核心能力,配合sessionid级别的会话管理,客服场景里的“打断重说”才成立。同时它还有一项容易被低估的功能:不说话时播放自定义 idle 视频,避免数字人进入静止画面带来的“死机感”。
这两件事叠加在一起,才是“直播感”而不是“念稿感”的来源。
上手路径与边界
LiveTalking 的接入成本控制得比较克制。源码部署的核心命令就是一条:
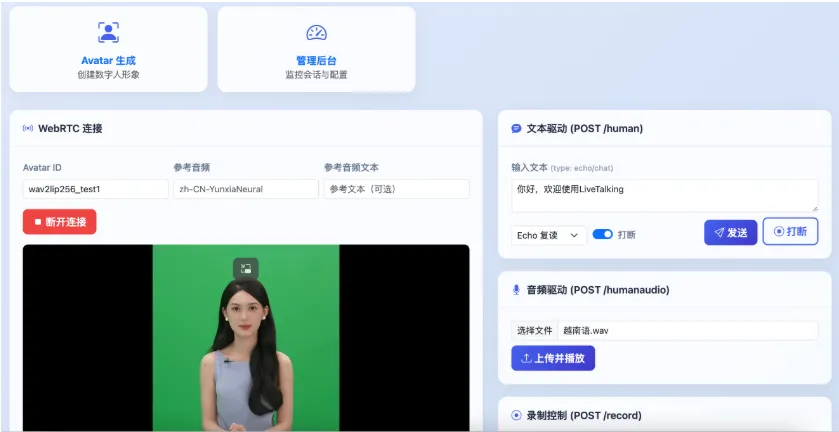
配套的起点包括:Ubuntu 22.04 + Python 3.12 + PyTorch 2.9.1(CUDA 12.8)测试通过;Docker 镜像覆盖 UCloud / AutoDL;Windows 整合包可用;浏览器打开/index.html即可对话,/avatar.html上传视频生成形象,/admin.html监控会话。API 侧,/human、/humanaudio、/record三个接口组合起来就能支撑短视频批量生产——提交文案、驱动口型、录制出片。
但边界也需要说清楚。
开源版和商用版的分界线在“运营级增强”,不在核心链路。商用版额外提供 wav2lipls 高画质模型、TensorRT 推理加速、透明背景/绿幕抠像、唤醒词打断、实时音频流 WebSocket 输入、自适应动作切换等能力。如果你要的是开箱即用的商业交付,开源版和商用版之间仍然有一段距离。
画质有天花板。wav2lip256 的口型生成分辨率是 256,依赖贴回机制维持清晰度,特写怼脸或大幅度侧脸转头场景会暴露局限。它不是替代高保真 3D 路线的方案,而是 2D 视频化身路线上部署门槛更低、GPU 路径更清晰的那一支。
合规不能绕过。项目本身要求基于它发布的视频携带 LiveTalking 水印和标识;叠加国内 AI 生成内容标识相关规定,无人直播的显式与隐式标识需要在架构阶段就纳入考虑,而不是上线前才补。
谁适合认真看这个项目
如果你在做24 小时无人直播、数字人客服、在线教育分身、大屏讲解或批量短视频出镜,并且已经有一张 RTX 3060 以上的卡,LiveTalking 提供了一个不需要按分钟付费的基线:LLM 可接 Qwen,TTS 可用 EdgeTTS 起步,口型推理跑在本地 GPU,推流走 WebRTC 或 RTMP。全链路没有硬性的闭源 SaaS 依赖,边际成本收敛到电费和显卡。
如果你需要的是“开箱运营”而不是“可扩展的引擎”,商用版是更直接的路径;如果你要做的是二次开发或自有产品集成,Apache 2.0 的代码和插件化架构给的是控制权,而不是黑盒。
项目地址:github.com/lipku/LiveTalking(Gitee / GitCode 有国内镜像)。文档:doc.livetalking.ai。