ARTICLE · 1363236
vLLM-Ascend CPU KV 卸载启动失败:非连续布局 Bug 与社区修复进展
模型已加载,KV 卸载却启动失败:从 512 KiB 步长追到缓存页的数据契约
一次 Qwen3.8-27B-w8a8 部署已经完成权重加载,框架也报告了 17.96 GiB 可用 KV Cache,随后却在 CPU 卸载注册阶段退出。最终异常给出两个数:物理块起点间距 524288 字节,单块有效内容 262144 字节。失败点是连接器试图合并多个有间隔的物理块,而当前字节页表示无法保留这个内部间隔。
这个案例值得展开,因为它跨越了推理系统的三层边界:模型后端提供什么张量,缓存管理器如何定义一页,卸载组件怎样识别并搬运这些字节。只检查剩余内存、修改一个带 block 的参数,或者把张量变成连续副本,都可能没有解决真正的数据契约问题。
下面先重建原始错误,再沿固定版本源码推导页大小与合并因子,并用真实 PyTorch 张量执行对应布局函数。最后讨论修复方案怎样保证双向数据正确,以及需要付出什么资源成本。
一、先确定失败阶段,避免把容量报告当作启动成功
归档日志能够直接证明什么
部署记录为昇腾 A2 单设备、TP=1,模型使用 W8A8 权重,运行时为 vLLM-Ascend 0.30.0。配套记录是约 60G 显存额度、CPU 32 核、主机内存 64G,并配置 OffloadingConnector 的 CPU 卸载路径。这里保留的是当时的部署背景,没有重新采集整机占用或目标运行镜像的逐文件指纹。
原始日志中,权重加载阶段报告 32.4213 GB;随后报告可用 KV Cache 为 17.96 GiB,KV 容量为 260342 Token,按每请求 133120 Token 换算得到约 1.96 倍理论并发。GB 与 GiB 沿用日志原单位,这几个数属于不同阶段,不能直接相减计算“还有多少显存没有利用”。
真正使进程退出的调用链发生在后面:注册缓存,规范化分离的缓存部件,再为某个部件建立字节视图。最后抛出的异常不是分配失败,而是无法合并非连续布局。下面是脱敏后的关键事实,省去了重复 traceback 和无关启动提示:
Available KV cache memory: 17.96 GiB
NPU KV cache size: 260,342 tokens
register_kv_caches → _canonicalize_split_cache → _make_int8_block_view
ValueError: Cannot coalesce a non-contiguous Ascend KV cache layout:
stride_bytes=524288, physical_block_bytes=262144
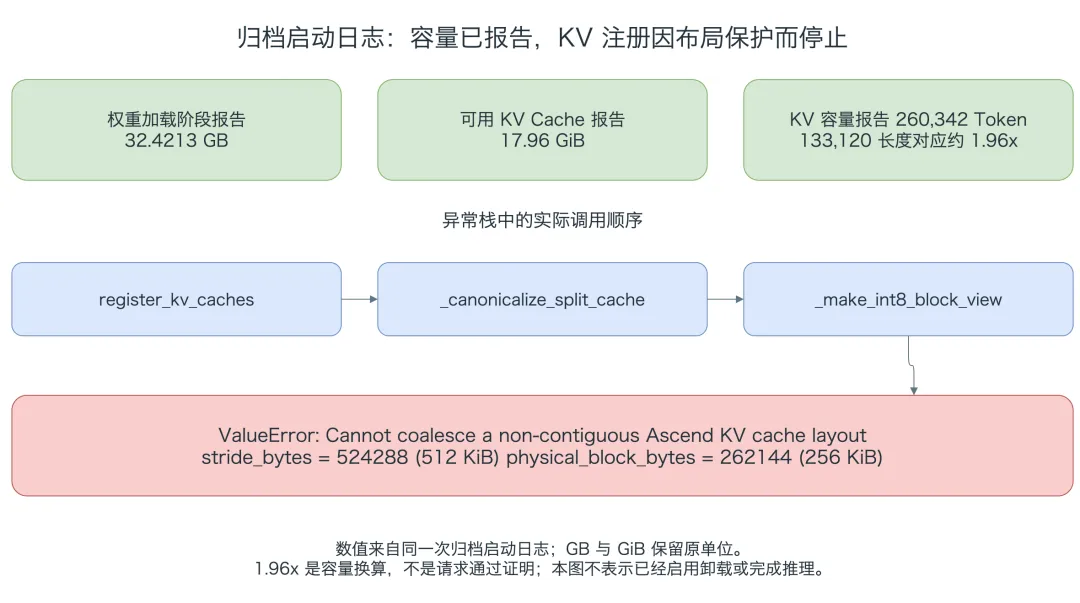
图 1:数值和函数顺序来自同一次归档启动日志,已删除日期、进程及内部路径。容量报告属于真实运行记录;本图不是 profiler 时间线,也不表示卸载或推理已经成功运行。
这说明当时已经走过权重加载和缓存容量计算,却没有完成当前缓存对象的卸载注册。容量计算回答的是按框架规则可以配置多少缓存;注册阶段还要回答这些缓存的数据范围、字节步长和分组描述能否被后续组件正确理解。前一道检查通过,不会自动保证后一道检查通过。
尤其要避免误读 1.96 倍这个数字。它是容量与给定请求长度的换算,不是已经观测到两条满长请求同时驻留、完成生成的结果。服务连注册阶段都未通过,此时拿它估算业务吞吐,缺少整个执行路径的证据。
先区分直接失败原因与更上游的原因
当前证据能直接定位的是布局保护检查,以及触发检查的两个字节数。它没有记录完整的张量列表、层名、各维 shape、storage offset 和精确合并因子。因此,我们可以解释为什么当前视图构造被拒绝,但还不能还原目标模型每一层的完整存储地图。
“为什么最终形成这样的物理布局”与“为什么连接器拒绝这个布局”也要分开。前者可能涉及模型后端、混合缓存分组和分配策略,后者有明确的源码条件。把第二个问题讲清楚,已经可以筛掉一些无效调参;要继续回答第一个问题,则必须补齐实际页描述。
下面的源码分析固定到 vLLM-Ascend 提交 c09d3e20b9c45c80b34ae3781440d90904a44023。本次在 CPU 上执行的是其中两个未改写的布局函数,并没有加载完整 NPU worker。这样既能验证真实的张量视图行为,也能避免把 CPU 结果冒充目标设备上的传输结论。
二、同一个 block,跨三层接口后已经不是同一种对象
从 Token 数量走到字节页
推理配置里的 block size 常以 Token 为单位;算子暴露的物理块则是一段具体数据;缓存管理器的一页可能覆盖多个物理块;卸载层还可以把多页组织成一次传输 chunk。它们存在映射关系,却不能仅凭名字相同就互相替换。
这个案例需要先定义五个量:一个部件每个物理块的有效字节数记为 B,相邻物理块起点间距记为 S,逻辑页有效字节数记为 P,一页包含的物理块组数记为 q,管理器页数记为 N。另有元素大小与存储偏移,决定元素单位如何转换成字节地址。
对包含多个部件的缓存,P 不是随意选的传输长度。注册路径先取得缓存组及每层 spec。Attention 路径使用未填充页大小;状态缓存路径则检查状态张量的有效大小与去掉填充后的 spec 是否一致。页外填充、层间打包和实际有效内容需要分别处理。页描述定义[1]
因此,不能根据模型名字里的 W8A8,就把所有 KV 或状态都按一个字节计算。权重、激活和缓存的类型属于不同配置。后端还可能暴露独立的 K、V、尺度或递归状态;只有取得各部件真实形状和元素类型,才能从元素数量推导有效字节数。
合并因子 q 从哪里来
_canonicalize_split_cache() 首先计算每个部件的一块有效内容:除去第零维,剩余维度的元素数量相乘,再乘元素字节数。若最终选择的部件大小为 b₁、b₂……,将它们合计记为 C,则合并因子来自逻辑页与该物理块组内容的比例:
部件字节 bᵢ = prod(partᵢ.shape[1:]) × partᵢ.element_size()
C = Σ bᵢ
q = P / C
每个部件在一个逻辑页中的复制字节数 = q × bᵢ
这个比例必须能表达为完整物理块组。源码在相应路径检查页大小能否整除部件合计大小。若整除条件不成立,注册应当直接拒绝,而不是用向下取整静默丢掉页尾数据。分离部件规范化[2]
这里有一个阅读源码时容易混淆的细节:外层函数把所选部件的合计大小当作一组物理内容,内层视图函数接收的却是单个部件的块字节数。两处都在讨论 physical block,但计算层次不同。不能拿 P 直接除以某一个 K 部件的 B,就认为得到了正确的 q。
例如在后面的 CPU 夹具中,K、V 每块各为 256 KiB,合计 C 为 512 KiB;若逻辑页 P 取 1 MiB,则 q 为二。连接器分别为 K、V 各组织 512 KiB 内容,两者相加才构成这一页的一 MiB。这个数值关系是可执行例子,不是从原始异常反推出的完整实机布局。
为什么有时又只注册一个完整视图
有的生产者除了部件视图,还能提供真正覆盖这些部件的完整存储视图。适配器会检查候选是否与其他部件共享底层存储、首块地址范围是否覆盖部件,以及物理块数量是否足够;符合条件时,可以选择这个完整视图,而不重复登记相同字节。
这是一项关于真实存储别名的检查,不能只看 shape 更大。复制出来的“大张量”可能拥有完全不同的存储,后续也不会自动跟随原缓存更新。完整覆盖与单纯拥有相同元素数量,并不是一回事。
规范化后的缓存还需要生成 tensor 列表及每组引用。tensor 描述一个按字节访问的页矩阵,引用说明哪个缓存组使用哪份数据、每页有效复制多大。该版本在多个分离视图的路径不会把完整页映射直接套到每个部件上,避免给局部对象错误使用完整页偏移。规范缓存表示[3]
由此可以看到,注册并不只是把几个指针交给复制函数。生产者、页管理器和卸载执行器必须对“这一页到底包含什么”达成一致,才能正确复用缓存。报错发生在这道数据契约尚未成立的地方。
三、把报错变成真实 PyTorch 对照,而不只画一张内存示意图
先推导地址,再检查连续页表示
设第 k 个逻辑页内需要合并第 m 个物理块,该块内部字节偏移为 j。保留真实物理间距时,地址应当是:
A真实(k,m,j) = base + (kq + m)S + j
当前函数要建立一个二维字节视图:每行是逻辑页,每行有 qB 个连续字节,外层行步长为 qS。于是同一个位置会被解释成:
A视图(k,m,j) = base + kqS + mB + j
两者差值     = m(S − B)
如果 q 为一,只有 m 为零,不存在页内跨块问题;如果 S 等于 B,相邻物理块自然连续,也能合并。若 q 大于一且 S 大于 B,连续行会进入间隔,后续真正需要的块却在更远处。保护检查就是在拒绝这种不一致的解释。
这也解释了为什么“张量不连续”这个说法太粗。二维视图允许行与行之间留有空隙,只要每行内部符合约定即可。q 为一时,可以保留较大的外层 stride;q 为二时,同一行内部必须包含两个块,原先位于行外的间隔就进入了行内。
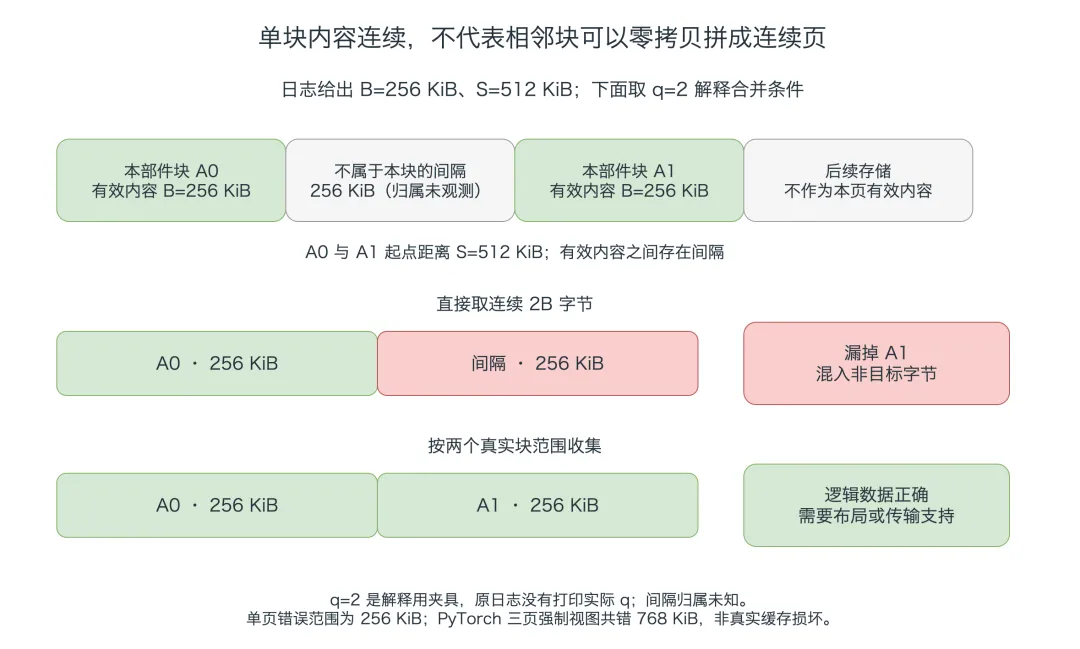
图 2:B=256 KiB、S=512 KiB 来自原始错误。q=2 是说明合并条件的夹具;原日志没有打印实际 q。间隔里究竟是什么,实机证据没有回答。图中错误读取仅说明错误视图的后果,不表示目标服务真的发生过缓存损坏。
原始错误给出 S=2B,却没有给出 P、部件合计 C,因此不能仅凭这两个数断言实际 q 就是二。同样,间隔可能被另一视图使用,不能据此宣布设备浪费了一半显存。可确定的是:对应保护分支要求多块合并,而当前部件间距不满足连续页条件。
本次执行了哪些真实函数
验证环境为 Python 3.13.12、PyTorch 2.10.0,所有张量明确创建在 CPU。脚本校验固定源码文件的 SHA-256,再通过语法树提取 _make_int8_block_view() 和 _canonicalize_split_cache(),保持函数体不变执行。完整 vLLM 包与 NPU worker 不参与这个实验。
每个主要夹具使用三个逻辑页。物理块内填入可区分的标记,K、V 与不同物理块之间也不使用同一个值,这样漏块、串入和次序错误才不会被重复数据掩盖。比较采用真实张量内容、底层存储别名、返回视图的 shape/stride,以及保存恢复后的值。
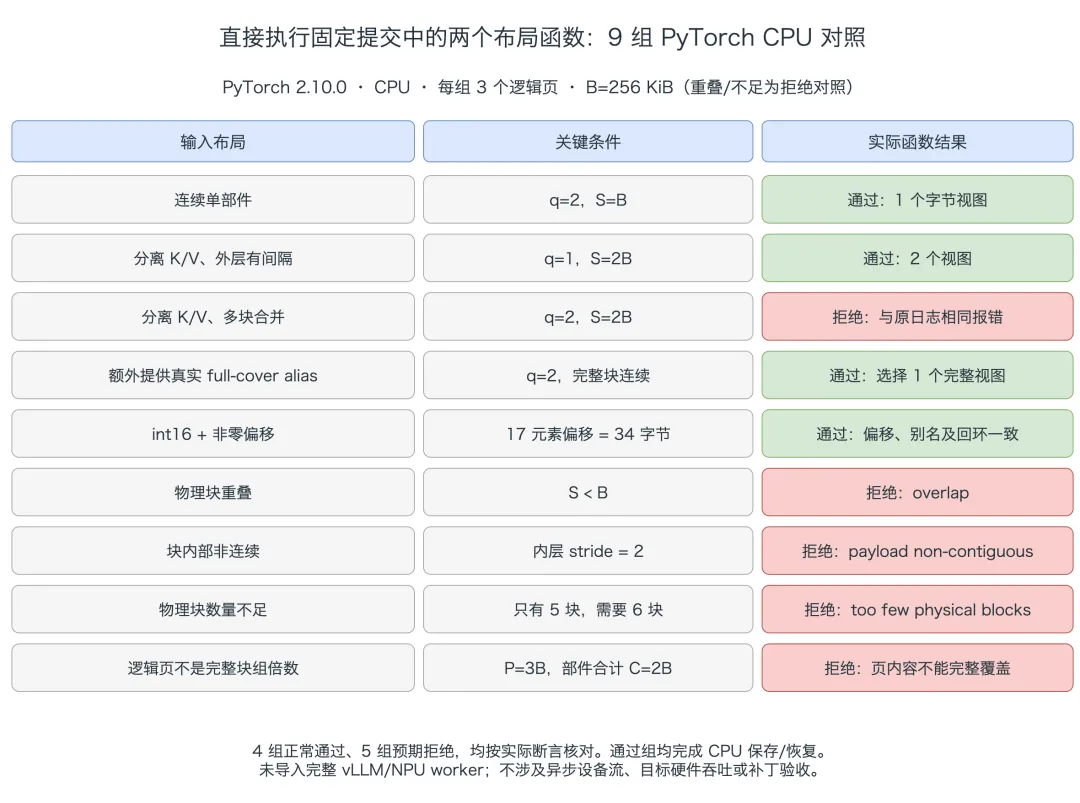
图 3:四组正常通过、五组按预期被原函数拒绝。通过组完成 CPU 保存与恢复;这些结果不包含异步设备流、驱动传输或目标模型端到端运行。
连续单部件且 q 为二时,函数得到一个正确的连续页视图。分离 K/V、块间距为两倍部件大小但 q 为一时,也能通过,返回两份仍保留外层间距的视图。这两组实际结果直接反驳了“所有外层非连续布局都会失败”的笼统理解。
在后一组中,每份返回视图有三行、每行 262144 字节,行步长却是 524288 字节。按行索引可以正确找到本部件的数据,中间另一部件的内容不会因为张量元素总数较小就自动消失。若下游把整个视图的有效元素数当成一段连续内存去读,仍会违反这个外层步长约定。
将相同分离布局改为 q 等于二,原函数产生了与实机记录相同的异常,两个字节参数也一致:524288 与 262144。这里验证的是该保护分支在真实 PyTorch 张量上的行为,不能用来声称已经重现了原模型的全部缓存分组过程。
随后给同一底层存储额外提供覆盖 K/V 的完整视图,规范化函数选择一份完整表示,多块页通过。这个对照说明,能否安全建立页视图与生产者暴露的表示有关;但原目标后端是否能够提供同样表示,仍需实际张量证据,不能把这个 CPU 夹具当作已完成的修复。
另外四组拒绝对照分别覆盖物理块重叠、块内部 stride 不连续、物理块数量不足,以及逻辑页不是完整块组的整数倍。它们检查的是不同错误,不能因为最后都抛出 ValueError 就用同一种容量调参应对。每次实验都核对具体异常信息,而不是只统计“运行失败”。
整数倍对照把 P 设为三个 B,而 K、V 部件合计是两个 B,结果被页内容覆盖检查拒绝。此时即使部件存储足够大,也不能把商截成整数后继续运行,否则页描述会遗漏尾部。这个实验把前面的 q 推导与实际函数行为对应了起来,而不只是引用一条公式。
非零偏移、错误视图与复制副本
还有一组使用两字节的 int16 元素,并在底层存储前保留十七个元素的偏移。原函数必须将其换成三十四字节的偏移,再建立 int8 视图。本次返回视图的偏移、别名与保存恢复结果均符合这个关系。
因此,函数名里的 int8 表示按字节观察存储,不意味着重新量化模型。元素 stride、storage offset 都有自己的单位;当视图元素类型变成一个字节,偏移和行步长也要转换。漏掉其中任一项,可能构造出形状正确、地址却错误的视图。PyTorch 视图语义[4]
为检查保护条件在防什么,实验还显式构造了一份跳过该保护的错误二维视图。三页 K 部件的目标内容共 1572864 字节,与逐块正确读取比较,有 786432 字节不匹配,即每页错一个 256 KiB 块。这个百分之五十只属于该夹具的错误读取比例,不能外推为模型错误率或设备资源损耗。
对同一存储建立三维视图,保留逻辑页、物理块和块内字节三个维度,并设置各自的步长,则内容比较通过,仍然共享原存储。由此可以确认,PyTorch 能表达这些地址;被拒绝的是当前连接器要求的连续二维页表示,而非这些数据完全不能建立零拷贝视图。
继续把这个三维对象用 view 展平成二维,实际得到不兼容 stride 的异常;使用 reshape 虽然得到正确内容,却生成了不共享原存储的新副本。二者的输出形状可以相同,别名关系和后续更新语义却不同。修复讨论若只展示形状正确,便会遗漏这个关键差别。
对被拒绝的分离布局,另做了显式 CPU gather/scatter:按真实块范围收集到连续缓冲,修改原数据,再逐块写回,内容比较通过。它说明可以设计正确的数据搬运,但这是示例路径,并没有替换生产连接器,更没有验证异步执行。
最后检查一次性连续副本是否能跟随生产者更新。副本建立后,把生产者中的一个值从十改为七十七,副本仍保留十,而且两者不共享存储。这个很小的真实对照说明,直接在注册阶段复制一次,可能只注册了一份会过期的快照。
四、结合社区实际修复,再比较正确性与开销
社区已经提出具体修复,旧案例需要放回版本演进中
直接相关的 Issue #20229[5] 报告了 Qwen3.8-27B hybrid 模型在 MRV1 native offload 注册时遇到同类合并异常。它的部件为 128 KiB、间距为 256 KiB,本地归档则是 256 KiB 与 512 KiB。两者几何比例相同,但不是同一次实验,也没有完整环境一致性证据。
追踪这个 issue,还需要同时看布局演进、运行器变化和修复分支。#14340[6] 已合并,提供 hybrid/GQA 非连续缓存布局的背景;#18004[7] 提出从分配侧恢复连续布局,目前仍未合并。不能只引用旧错误,忽略社区正在选择哪一层修复数据契约。
本次核对的最新稳定 release 是 v0.30.0;main 快照固定到 c6857b4d3a311de571cd36ee3cd5c1793a6f5844。main 保留了相同 helper 约束,但已通过 #20097[8] 移除 MRV1。原来的 MRV1 日志因此不能直接代表当前完整模型路径;人工构造的同类几何仍被 main helper 拒绝,也不等于已经在当前 MRV2 模型上重现了整个启动失败。
最直接的候选修复是 #20559[9]。本次 API 状态为 open、未合并,且存在冲突。issue 评论中写了“fixed by”只是关联修复,不能当作已进入发行版的证明。当前 head 的 CI 也不是全绿,部分单元与设备测试为 skipped。
PR 改变的是上层页表示,保护检查仍然存在
PR head 固定到 1d497fa4832e1ab8ef3cc9274e4b8bcaf4f8c9a3。它没有简单删除旧 helper 的保护,而是在无法连续合并的部件上按 kernel slot 拆分视图,让每次进入 helper 时处理合法的单块范围,同时保留跨 manager page 的外层真实间距。
在 MRV2 且为精确 FullAttentionSpec 的适用路径,新增的 _coalesce_interleaved_slots() 进一步验证部件是否共用存储、偏移是否相邻、覆盖范围是否连续;条件满足才合并 K/V 范围,有 padding 时仍避开无效字节。这个连续合并优化有 MRV2 条件,而 kernel-slot 回退并不只受该开关控制,两者不能混为一谈。
它还处理 hybrid 组重叠视图的 CPU 存储去重,并设置同步 native load 与 GDN state pre-copy 的顺序条件。因此,这个 PR 的价值不只是让一次视图构建返回成功,还包括组引用、存储共享和恢复后读到哪个检查点的问题。
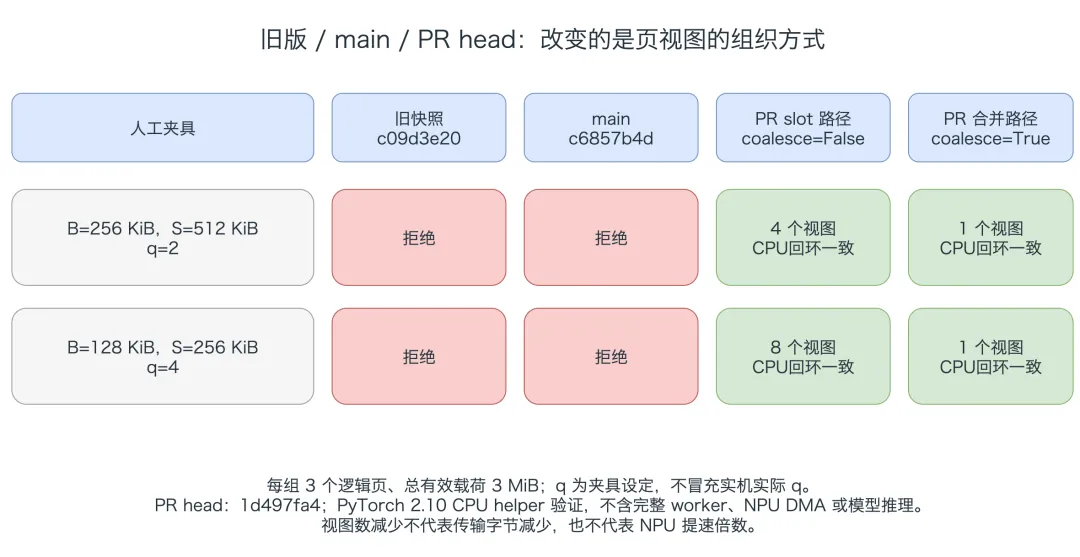
图 4:本次新增的八组 CPU 执行结果。两个夹具各含三个逻辑页,均为 3 MiB 有效载荷;q 是夹具设定,未冒充实机值。比较的是原函数返回的视图与 CPU 回环,不包含完整 worker、NPU DMA 或模型运行。
对本地错误尺寸构造的 q=2 夹具,旧快照与 main helper 都拒绝,PR 的 slot 路径返回四个视图,连续合并路径返回一个。对 128 KiB 部件、256 KiB 间距的 q=4 例子,结果分别是拒绝、拒绝、八个视图、一个视图。成功路径核对了别名、有效字节及保存恢复一致性。
这些结果表明,原文列出的分段表示路线已经有社区代码实现,应该结合它解释具体取舍。视图数从八到一,仍然保持相同有效载荷,不能写成传输量减少八倍或模型提速八倍。
PR 作者另外报告了七十九项 CPU harness 测试,并加入 Qwen3.5-0.8B MRV2 NPU 回归测试;描述明确指出该 NPU 测试与 Qwen3.8-27B 准确率、性能验证待完成。本次 CPU 对照没有替代这些目标硬件验证,也没有复跑作者全部测试。
其他方案不能只因标题相近就视为等价修复
#21592[10] 走的是跳过 MambaSpec 组、只卸载其他组的路线。它与完整支持状态组卸载是不同目标;本地日志没有保存出错组,不能只因模型含 GDN 就推荐它替代当前方案。更广的 packed/hybrid 卸载候选 #17539[11] 还声明需要配套 vLLM 提交,其他模型或较早集成的设备结果也不能迁移成当前 Qwen3.8 的验证。
另一个容易混淆的 #21919[12] 已关闭但未合并,并且方案针对纯 GQA,明确保留 hybrid 路径。closed 不等于 merged,纯注意力模型的连续布局结果也不能拿来覆盖本案例。
带着这些实际实现再比较下面几种设计,才能知道哪些已经写成候选代码、哪些只在 CPU 夹具中成立、哪些仍缺目标模型的硬件证据。
先排除不能改变当前条件的调整
增加主机 CPU 池,可以改变主机侧能够保存多少页;它不会直接把已经存在的 NPU 张量间距从 512 KiB 改成 256 KiB。传输 chunk 大小、逻辑页大小和物理部件 stride 也属于不同层次。参数调整如果改变了布局或分组,应重新打印 P、C、q、B、S 验证;如果这些量仍然相同,就没有证据认为当前保护条件已被修正。
同理,扩大超时不会越过一个明确的布局异常。降低并发也许改变其他资源压力,却不能自动证明当前张量描述变得可合并。工程排障应当记录“哪个量因调整而变化”,而不是只记录一组参数看起来更保守。
删除保护更不能算修复。该保护把可能的数据误读挡在启动阶段;绕过去之后,错误可能延迟到缓存恢复命中时才出现。那时服务可以正常返回,问题却更难和这次布局改动关联。
四种设计方向分别改变什么
第一种方向是使用生产者提供的真实完整页别名。若完整视图确实覆盖所有必要部件,且其页内字节连续,原有二维页接口就有机会继续使用。它的优势是保留原存储关系,减少整理复制;前提是完整覆盖、偏移、页跨度和后端更新路径都得到证明。
#20559 的连续范围优化与此前的完整覆盖夹具还有一点区别:它可以在验证相邻部件之后直接组织连续范围,不一定要求生产者额外提供一个完整张量。原 CPU full-cover 对照证明的是已有完整别名可用;新 PR 对照证明的是其合并代码在指定夹具中可行,二者需要分别说明。
这个前提不能靠构造一个更大的 shape 代替。错误扩大范围可能读到其他层或其他状态,复制出来的张量又失去了别名关系。更复杂的 packed 布局还需要核对页映射,不能把首块范围的检查扩大解释为所有生产布局都已经安全。
第二种方向是把一页描述为多个有效片段,保留每个物理块的范围。逻辑上可以用更高维视图表达这些地址,但后续搬运接口也必须理解分段映射,并在加载时执行相应的逆映射。仅把形状从二维改成三维,而复制代码仍按一段连续区域处理,数据契约并未改变。
这种方案可能减少整理副本,但会增加描述数量、任务聚合和完成状态管理。设第 l 类页有 Nₗ 页、cₗ 个部件、每页 qₗ 个物理块组,朴素逐块描述的片段数是各类 Nₗcₗqₗ 之和;有效载荷则是各类 NₗPₗ 之和。前者不等于最终 API 调用或 Kernel 数,因为后端可能批量合并任务。
上游已有 CanonicalPageMapping 与 CopyRun 抽象,用偏移、片段长度、片段数量以及本地和规范布局的步长表达字节对应关系。不过,有这些字段不等于当前失败分支已经使用了正确映射:本例在建立部件视图时就被拒绝,分离多视图路径也没有直接继承完整页映射。若利用现有抽象,应同时核对映射生成和后端消费,不能只补元数据字段就宣布支持。
第三种方向是增加连续暂存页,保存时 gather、恢复时 scatter。当前二维页接口可以继续面向连续缓冲,但要显式维护原布局与暂存页之间的版本关系。这比注册时调用一次 contiguous 完整得多:每次需要保存的最新内容必须重新收集,每次恢复也必须写回实际被算子使用的缓存。
采用 NPU 侧独立连续暂存区时,开销不能只看主机—设备链路。若一次处理 D 字节有效载荷,单次 gather 需要读取原数据并写入暂存区,相较直接搬运,额外逻辑设备内存读写量约为 2D;随后才是 D2H。反方向的 scatter 也有类似的读写。这个估算是在明确数据路径下的数量级分析,不是本设备测得的带宽或耗时。
在本文三个逻辑页、每页一 MiB 的夹具里,完整 K/V 载荷是三 MiB。按上述暂存路径,一次 gather 的额外读写量约六 MiB;并行暂存多个任务还需要相应的缓冲空间。这个数字来自夹具尺寸,不能拿去当真实模型每次请求的搬运量。
第四种方向是调整缓存分配,让逻辑页从生产端就符合连续布局。这样可能简化卸载,却会触及注意力或状态算子的布局假设、对齐和后端接口。零拷贝收益与算子访问效率也可能发生取舍,需要目标硬件验证,不能凭一个 CPU 视图实验决定整个模型后端应该如何分配。
为什么现在不应宣布某个方向最快
分段方案可能受小任务提交开销影响,暂存方案可能受整理复制与显存峰值影响,完整页方案可能搬入更多原本不需要的数据。若用串行近似描述,时间包含片段提交开销与有效传输时间;而真实运行还有批处理、异步重叠和依赖等待。这些因素没有实测参数时,不应代入随意的带宽数字给出提速比例。
本次 CPU 对照回答了哪些表示可以保留正确数据,尚未回答 NPU 上哪种方案更快。选择修复方向之前,应先把候选的有效载荷、额外整理读写、暂存峰值、描述数量和同步位置列清楚,再设计同条件对照。
五、双向卸载的验收,需要把数据、状态和流依赖连起来
保存与恢复各自有一条完整依赖链
保存方向首先要确定源页仍然属于被保存的缓存版本,并等待本页最后一次有效写入完成。随后才能收集或复制;传输确认完成后,主机副本才能作为可加载缓存对外发布。在这段时间里,源页及必要的暂存区不能提前释放后被复用。
如果原计算路径还可能继续改写同一页,仅记录一个完成事件也不够:它约束的是此前的写入,不能阻止之后的写入与复制竞争。需要固定已完成块的版本、建立写入排他,或使用一致快照等机制,保证实际搬走的数据确实属于要发布的缓存版本。
恢复方向先取得目标页及其映射,再进行 H2D 和必要散写。只有写入完成,使用该页的计算才能继续。把“已经提交复制任务”当成“恢复完成”,会让计算与写入竞争;只在主机函数外加一个锁,也不一定建立了设备流之间的依赖。
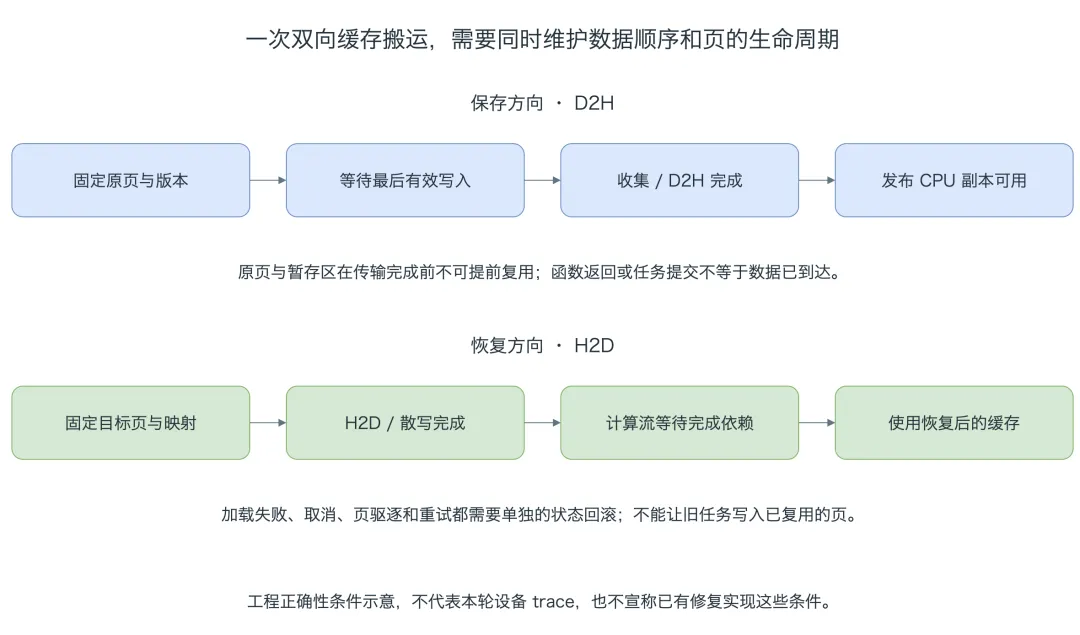
图 5:保存、恢复的工程正确性条件示意,不是目标设备 trace,也不代表已有候选补丁完成这些条件。CPU 保存恢复只验证同步张量操作,不能替代此图中的设备依赖验证。
生命周期还涉及取消与重试。一条传输尚未结束时,请求可能取消,缓存页也可能进入驱逐流程。如果旧任务随后写入已经分配给另一请求的目标页,就算字节映射本身完全正确,仍然会破坏新数据。因此,页标识、版本、引用保护与完成通知必须一起设计。
上游卸载接口也区分准备、完成和查找状态,缓存处于传输中与已可使用并不是同一个状态。修复布局时若绕过这些状态边界,可能得到一个单次复制通过、并发压力下却不可靠的实现。卸载状态抽象[3]
目标环境首先缺少哪些诊断字段
这次日志缺少的是出错层的实际页描述。一次有效补采应关联缓存组、层名、后端与运行器版本,记录部件的 shape、各维 stride、元素大小、storage offset、P、所选部件合计 C 和计算得到的 q。只打印 B 与 S,能够解释最后一个条件,却无法复原上游选择过程。
还需要记录返回的规范视图数量、每份视图的有效复制长度,以及它与原部件是否共享存储。这些元数据可以帮助核对地址契约;没有必要为了判断 stride 就把整份 KV 内容复制到主机并打印出来,那会引入额外开销,也无法代替结构分析。
版本信息也应与实际运行器对应。模型配置、后端、图模式、MTP 和缓存布局组合改变时,另一套模型启动成功不能证明当前组合已覆盖。公开提交可以固定源码讨论,目标镜像的库与源码对应关系则需要单独核验。
怎样把 CPU 结果推进成目标 NPU 的结论
先保留同一模型、输入、输出预算和采样条件的基础路径,再分别验证保存、恢复命中与缓存未命中。不能只看到前缀命中计数上升就认为 CPU 卸载有效,因为命中可能发生在设备本地。需要对应的 store/load 事件、搬运字节和关联请求,才能证明走过预期路径。
正确性比较也不止于一次请求返回非空文本。缓存页回环应逐部件检查,模型输出比较则要明确确定性设置与允许的数值差异;使用随机生成或不同执行算法时,不能把字符串偶然不同直接当成复制错误,也不能把碰巧生成相同短答案当成缓存完全一致。
然后再扩大到多页、非零偏移、多个缓存组、连续保存恢复,以及取消、驱逐与重试交错的情况。要特别保留旧任务完成时目标页已经变化的对照,检查是否有版本保护。前面那些局部张量断言,是这套验证的起点,不是终点。
性能阶段应同时观察端到端首段与输出间隔、命中收益、整理与复制时间、设备与主机暂存峰值。若收益来自免去 Prefill,而代价来自 H2D 和整理,应在相同工作负载下比较完整关键路径;只展示一段复制带宽,无法证明用户请求真的更快。
当目标环境尚未完成这些验证时,可以明确保留已确认的直接失败原因,以及 CPU 上得到的表示约束和反例。本次没有重新运行 NPU,也没有验证任何候选补丁。绕过卸载路径后恢复基础服务,即使另行验证通过,也只能登记为隔离失败路径的处置,不能登记为卸载功能修复。
结论:真正要对齐的,是一页数据的完整含义
对归档旧案例,直接失败条件已经有日志、源码和真实 PyTorch 对照共同支撑:多块合并时,部件块间距大于有效块大小,当前连续页表示不能保持正确地址。17.96 GiB 的容量报告并不能回答这个布局问题。
社区当前 main、旧 release 与未合并 PR 已经走到不同阶段,本文没有把它们混成一个运行版本。进一步追踪后,问题也不再只是“把 stride 改小”。逻辑页由 spec 定义,合并因子来自所选部件内容,完整视图必须是真实别名,保存与恢复还必须维持数据版本和流依赖。任何修复都要让这些约定同时成立。
数据放得下、页描述正确、双向传输可靠、缓存复用有收益,是四个需要分别验证的条件。把它们连成一条可复核的证据链,才能从一次启动报错走向可信的推理基础设施修复。
参考链接
- 页描述定义: https://github.com/vllm-project/vllm/blob/ced6857afa0ea7b2e3f0846a62e1394e90f15607/vllm/v1/kv_cache_interface.py
- 分离部件规范化: https://github.com/vllm-project/vllm-ascend/blob/c09d3e20b9c45c80b34ae3781440d90904a44023/vllm_ascend/distributed/kv_transfer/kv_pool/kv_offload/native/offloading_connector.py#L94
- 规范缓存表示: https://github.com/vllm-project/vllm/blob/ced6857afa0ea7b2e3f0846a62e1394e90f15607/vllm/v1/kv_offload/base.py
- PyTorch 视图语义: https://docs.pytorch.org/docs/2.10/generated/torch.as_strided.html
- Issue #20229: https://github.com/vllm-project/vllm-ascend/issues/20229
- #14340: https://github.com/vllm-project/vllm-ascend/pull/14340
- #18004: https://github.com/vllm-project/vllm-ascend/pull/18004
- #20097: https://github.com/vllm-project/vllm-ascend/pull/20097
- #20559: https://github.com/vllm-project/vllm-ascend/pull/20559
- #21592: https://github.com/vllm-project/vllm-ascend/pull/21592
- #17539: https://github.com/vllm-project/vllm-ascend/pull/17539
- #21919: https://github.com/vllm-project/vllm-ascend/pull/21919
- 当前 main 固定快照: https://github.com/vllm-project/vllm-ascend/blob/c6857b4d3a311de571cd36ee3cd5c1793a6f5844/vllm_ascend/distributed/kv_transfer/kv_pool/kv_offload/native/offloading_connector.py
- vLLM-Ascend 固定提交:布局适配与注册函数: https://github.com/vllm-project/vllm-ascend/blob/c09d3e20b9c45c80b34ae3781440d90904a44023/vllm_ascend/distributed/kv_transfer/kv_pool/kv_offload/native/offloading_connector.py
- vLLM 固定提交:卸载 worker 注册路径: https://github.com/vllm-project/vllm/blob/ced6857afa0ea7b2e3f0846a62e1394e90f15607/vllm/distributed/kv_transfer/kv_connector/v1/offloading/worker.py