ARTICLE · 1367157
DeepSeek把整个App,做成了一个参数
DeepSeek把整个App,做成了一个参数
11月13日,DeepSeek 更新了一篇公告,标题很朴素:《DeepSeek 发布全家桶应用 API》。
在一堆模型跑分、融资消息和发布会里,这条几乎没有激起水花。
我读完官方文档和定价表,判断是:这是今年国内最被低估的一次 API 更新。
原因不是它功能多,而是它悄悄改了一件事——做一个 AI 应用,现在只需要一个参数。
一、先看清它到底发了什么
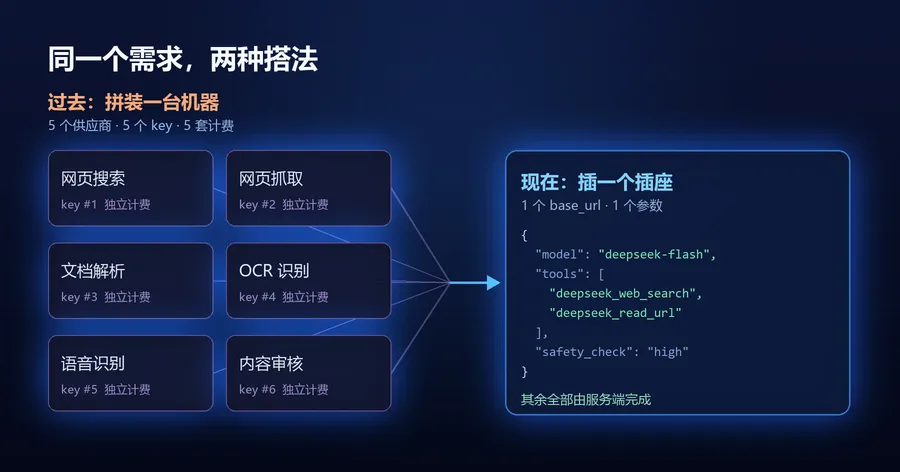
过去你想做一个"像 DeepSeek 那样的对话产品",要做多少事?
接模型 API,这是最简单的部分。然后:接一个搜索引擎、处理网页抓取、解析 PDF 和 Office 文档、接 OCR、接语音识别、接语音合成、写一套内容审核、再把这些东西的上下文拼装逻辑自己写一遍。
五六个供应商,五六个 key,五套计费,五种错误码,还有它们之间无穷无尽的衔接问题。
11月13日之后,这些活被收进了一个地方。
DeepSeek 把官方 App 的交互能力,直接整合进了原有 API。开启对应参数,工具调用和上下文拼接全部由服务端自动完成。目前 deepseek-flash 模型在三套协议下都支持:
联网搜索:非思考模式下打开 deepseek_web_search,模型自动发起网页或图片搜索,并附引用作答。
深度思考搜索:思考模式下打开同一个工具,模型可以在多步推理过程中自主搜索、自主阅读链接。
文件输入:PDF、Word、PowerPoint、图片,解析后拼进上下文。
阅读链接:打开 deepseek_read_url,用户消息里的链接会被自动抓取。
模型安全:开启校验参数后提供基础风控,审核输入输出,命中风险时返回拒答标识。
与此同时,这些底层能力还能拆开单卖——Search、Fetch、OCR、ASR、TTS 五个独立接口,可以接进你自己的任何工作流。
还有几项在公告里一笔带过、但开发者会立刻用上的小能力:把当前日期、用户所在地、界面语言作为"用户元信息"告诉模型;根据对话内容自动生成会话标题;把回答直接合成语音朗读;把用户语音识别成文字发出去。
这些零碎功能凑在一起,才叫"完整的 App 体验"。少一样,用户就会觉得"差点意思"。
支持范围也给得很足:三套协议(Messages、Responses、Chat Completions)、1M 上下文、最大 384K 输出、2500 并发。对绝大多数应用来说,这不是"够用",是"用不完"。
官方在公告里写了一句很实在的话:开发者"甚至 1:1 复刻出完整的 DeepSeek App"。
这句话不是修辞。他们同时开源了一个前端 Demo,支持导入 DeepSeek 历史对话。
我查了一下这个仓库的数据:11月12日建仓,11月16日上午已经 3764 star、785 fork,MIT 协议。
四天。
一个"复刻官方 App"的样板间,四天拿到三千七百个 star。这个数字比任何宣传都更能说明开发者在等什么。
更值得注意的是 Demo 的一个小功能:支持导入从 DeepSeek 网页端导出的历史对话。
这是个暗手。它意味着一个用户从官方 App 迁移到第三方应用,几乎不需要付出成本——聊天记录能带走,上下文能延续,感觉像换了个皮肤,而不是换了个产品。
对开发者来说,这是最容易冷启动的一批用户。对 DeepSeek 来说,这是把"用户属于谁"这个问题,主动交了出去——它赌的是:用户流到哪儿都行,只要还在用我的模型。
二、最值钱的一句话,藏在指南里
技术文档通常很枯燥,但这份构建指南里有一句话,我认为是整篇的核心:
"搜索和阅读链接都由服务端完成。客户端只需要展示返回的内容块,并在下一轮把它们原样回传。"
翻译成业务语言就是:客户端从"系统集成商",降级成了"显示器"。
这句话的分量在哪里?
过去做一个 AI 产品,真正的门槛不在模型,而在集成。模型都差不多,差的是你有没有能力把搜索、解析、语音、审核这堆零件拼成一台能转的机器。这活既不好干,也不好招人,更不好维护。
现在服务端把机器装好了,只给你一个插座。
你要做的,是在 tools 里写两个名字,配一个 safety_check,然后在界面上把返回的内容块画出来。
这就是"折叠"——把一整个应用层的复杂度,折叠进了一个参数。
三、定价才是真正的信号
比功能更值得琢磨的,是价格表。
DeepSeek 这次的收费模式变了:除了 token 费,还要收"工具调用费"。
具体是:文字与图片搜索、网页抓取,各 5 元/千次;文件解析与 OCR,1.5 元/千页;语音识别 0.39 元/小时(限时五折,原价 0.78);语音合成 1.5 元/万字符(限时五折,原价 3.0)。
单看数字没感觉。我把官方示例里那一次真实请求的用量拿来算了一遍。
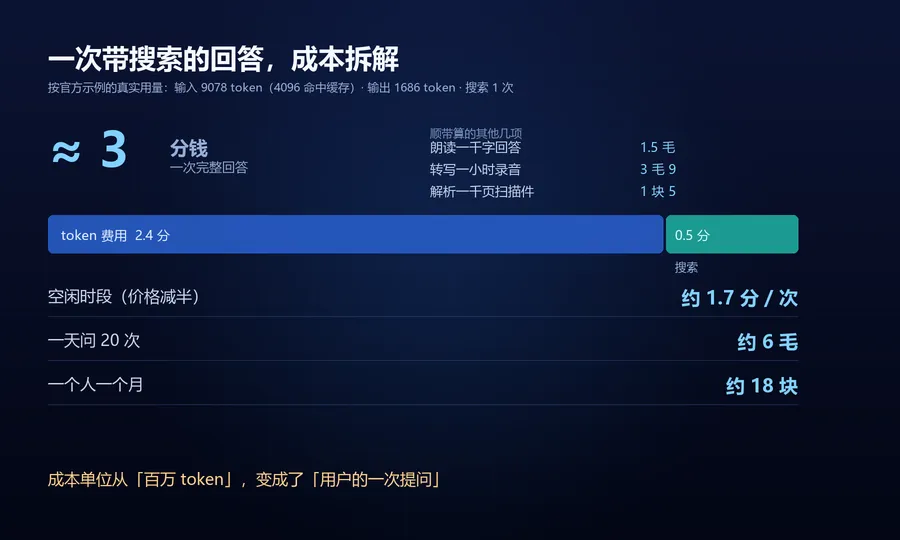
那次请求:输入 9078 个 token,其中 4096 命中缓存,输出 1686 个 token,模型发起了 1 次搜索。
按 deepseek-flash 高峰时段价格(缓存未命中 2 元/百万输入、命中 0.04 元/百万、输出 8 元/百万):
token 部分大约 2.4 分钱,搜索 0.5 分钱,合计不到 3 分钱。如果放在空闲时段(价格减半),大约 1.7 分钱。
一次带联网搜索、带引用的完整回答,三分钱。
其他几项也顺手算了算:朗读一千字回答,1.5 毛;把一小时录音转成文字,3 毛 9;解析一千页扫描件,1 块 5。
这些数字放在传统软件采购里,是很荒谬的。过去接一家语音识别供应商,商务谈判、合同审批、月度对账,光是流程成本就比这一年的调用费高。
这就是我为什么说"定价才是信号"。
AI 应用的成本单位,从"百万 token"变成了"用户的一次提问"。
以前做预算,产品经理对着一堆 token 账单发懵,因为输入输出比例、缓存命中率、思考长度,每一项都在动。现在你可以直接算:一个用户一天问 20 次,一次 3 分钱,一天 6 毛,一个月 18 块。
单位经济模型终于能算了。能算,生意才成立。
但这里还有个反直觉的推论,很多团队会踩坑。
想省钱,重点不在压缩提示词,而在控制工具调用次数。因为一次搜索半分钱听起来像白送,乘上一亿次就是 50 万;一次深度思考搜索可能要发起三五次搜索加若干次抓取,成本立刻翻几倍。
工具是便宜的,工具乘以规模不便宜。
四、代价:四个必须看清的地方
天下没有只涨不跌的好事。这套方案的代价,文档里写得挺坦白,但容易被跳过。
第一,你的参数被服务端接管了。
声明了 deepseek_web_search、把 safety_check 设为 high、或者开了自动标题,temperature、top_p、seed、n、stop 这些参数会被直接忽略——服务端说了算。
你要可预测的体验,就得交出可调的空间。这是个明确的交换。
第二,链路是黑盒。
搜索结果怎么排序、抓取抓到多深、什么算"命中风险",你既调不了,也看不到细节。出了问题,你唯一能做的是重试。对做搜索质量的产品团队来说,这一条可能是致命的。
第三,责任没有跟着能力一起转移。
官方公告说得很清楚:如你对外提供服务,请务必开启安全校验参数,并承担内容安全审核、大模型登记、AI 标识等义务。
意思是:风控我提供基础版,出了事你负责。
而且模型命中风险时返回的是一个 refusal 停止原因,那句"我不能回答"的文案,还得你自己写、自己替换。
第四,目前只有 deepseek-flash 这一个模型支持全套能力。
配上 1M 上下文、最大 384K 输出、2500 并发的规格,性能够用;但如果你需要更强的推理模型来做复杂任务,这套全家桶暂时还接不上 pro 档。
顺带一个容易被忽略的细节:它支持的三套协议里,Messages 那套走的是 api.deepseek.com/anthropic 路径。
这意味着,跑在 Claude 生态上的代码,改个 base_url 就能迁过来。
这是便利,也是信号——兼容对手的接口,从来都是为了让对手的开发者少一点心理负担。
五、接口战争:兼容是最便宜的进攻
我想把一个细节单独拎出来讲,因为它比功能列表更能说明战略意图。
这次新增的 Messages 协议,路径是 /anthropic/v1/messages。也就是说,DeepSeek 在自己的域名下,原样实现了一套 Anthropic 的接口规范。
一套代码,只要把 base_url 从 Anthropic 换成 DeepSeek,模型就从 Claude 换成了 deepseek-flash,工具调用、思考块、引用角标、拒答标识,格式全都对得上。
这套打法,历史上出现过太多次。
微软当年让 Office 完美打开 WPS 文件,是为了把用户留在自己的生态里;安卓早期疯狂兼容 Java 生态,是为了让开发者零成本迁移;国内的协同办公软件,第一批功能永远是"兼容 Excel 公式"。
兼容的从来不是技术,是迁移成本。
一个开发者从 A 平台迁到 B 平台,理论上要评估一周、改造三天、上线验证两天。现在你把这段时间压缩到"改一行配置",迁移就从"项目"变成了"实验"。
实验的门槛,低到没有理由不做。
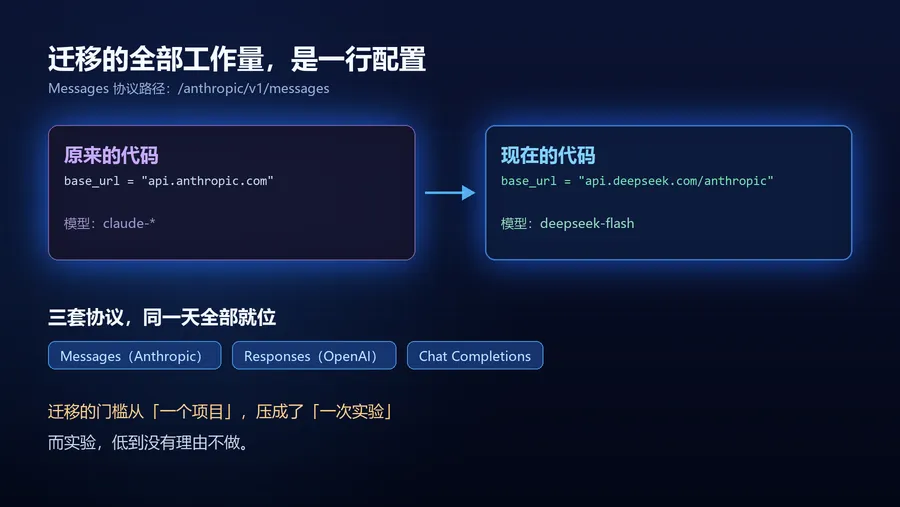
同一天里,OpenAI 格式的 base_url 依然在,Anthropic 格式新开一路,加上 Responses 协议——三家主流协议的形状,它都支持了。
这就不是"我要锁住你",而是"我不拦着你来"。
对开发者是好事,对生态是狠招。
对做应用的人来说,这里有一条隐含建议:架构上把模型层做成可替换的,成本很低的。 既然平台都在打兼容牌,你就没必要把自己钉死在某一家的 SDK 里。
接口越标准化,你的议价权越高。
六、谁该立刻上,谁该再等等
我的建议很具体。
立刻上手:做客服机器人、内部知识库、文档处理、语音转写与朗读、以及任何需要"带引用的回答"的产品。这些场景原本要花两三个月对接的活,现在能压到两周。省下的不是钱,是窗口期。
再等等:检索策略必须自己掌控的搜索型产品、合规要求极高的金融医疗、需要多模型路由来压成本的团队。你们的护城河恰恰在"自己能调"这件事上,交出去就没了。
试探性使用:先跑一周真实流量。官方响应里带了 server_tool_use 的计数(搜索几次、抓取几次),按你真实的调用结构算成本,别按 demo 算。demo 永远只用一次搜索,真实的用户会问出让模型搜八次的问题。
总结
模型是大脑,工具是手脚。
过去两年,所有公司都在比大脑——参数、跑分、上下文长度。DeepSeek 这次卖的东西不一样:它把"完整的身体"打包卖了。
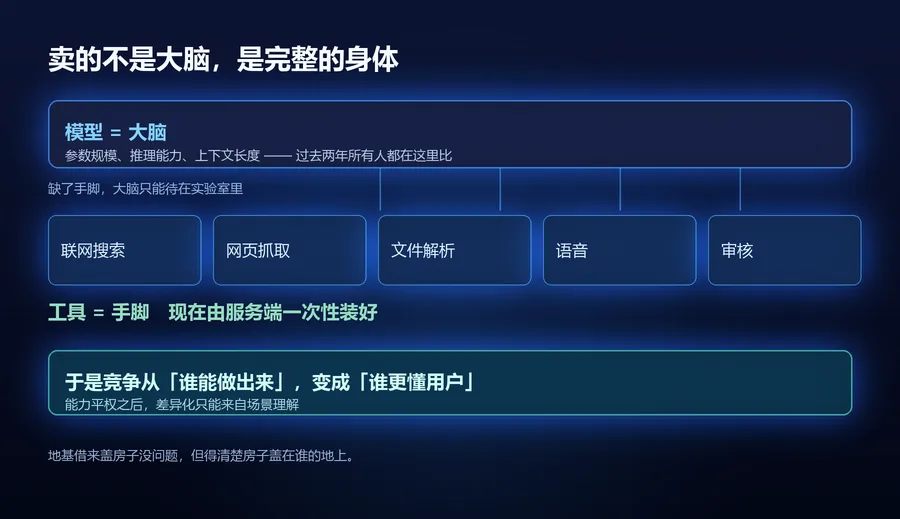
一句话概括我的判断:当一个 AI 应用的生产成本降到"一个参数",竞争就从"谁能做出来",变成"谁更懂用户"。
能力平权之后,差异化只能来自场景理解。
给三条建议。
给开发者:今天就去读 build_a_chatbot 那份指南,把开源 Demo 跑起来。亲手感受一次"客户端只做显示器",比看十篇评测有用。
给产品负责人:拿新的价格表,把你手上的产品重算一遍单位经济模型。很多过去算不过账的 AI 功能,现在能算过了——这是重新立项的最好时机。
给决策者:记住一件事,你省下的每一分对接成本,都在加深对一家公司的依赖。地基借来盖房子没问题,但得清楚房子盖在谁的地上。
至于那句官方的话,我觉得说得挺好:现有的对话产品,只是较为基础的一种形态。
真正好玩的部分,现在才轮到开发者。