ARTICLE · 1369138
50 页合同 5 分钟找出风险点:长文档怎么喂给 AI 才不漏读
一、先看效果
供应商发来一份 47 页的框架协议,抄送里写着"本周内确认,无异议视为同意"。
你知道里面有问题,但没时间逐字读。法务排期三天后,你翻到付款和违约责任看了两眼,签了。
半年后出问题,翻回去发现第 31 页第 8.4 款:"甲方单方终止需支付剩余合同期全部服务费"。
做法:提取 → 切条款 → 逐片提取 → 汇总成带页码的风险表。首轮 5 分钟。
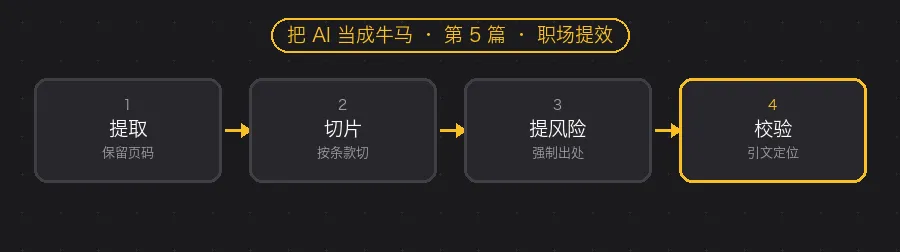
插图1 长文档处理管线:提取 → 切片 → 逐片提取 → 汇总定位
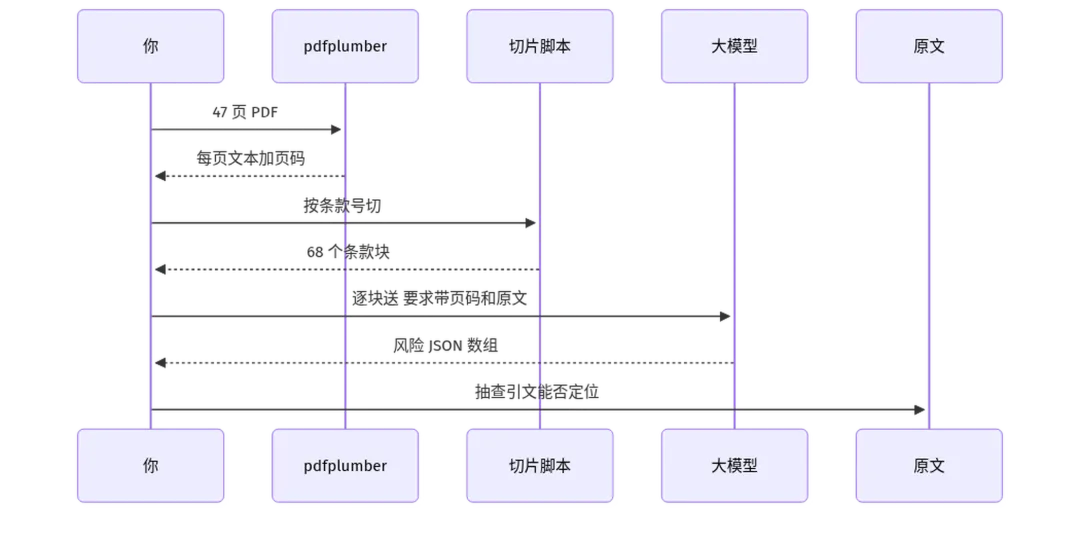
流程图
二、为什么整本丢进去一定漏
多数人的做法是把 50 页全塞进对话框,说"帮我看看有什么风险"。两个问题:中间会被稀释,上下文越长,模型对中段的注意力越弱,这是"lost in the middle";它也不会告诉你它漏了,你拿到一份很像样的总结,缺的那条恰恰最要命。
正确做法是强制逐段处理,每条结论带出处。只要"出处"是硬要求,漏读就会暴露——它没法给没读过的条款编页码,编了也能查。
工程本质是把"摘要"换成"检索 + 标注":摘要不可验证,标注可验证。要担责任的事,走可验证的路。
三、动手
第 1 步:提取文本,保留页码前置条件
扫描件先 OCR,文字版直接抽。用 pdfplumber,它能把页码带出来:
# extract.py —— pip install pdfplumberimport sys, json, pathlib, pdfplumberwith pdfplumber.open(sys.argv[1]) as pdf: pages = [{"page": i, "text": (p.extract_text() or "").strip()} for i, p in enumerate(pdf.pages, 1)]out = pathlib.Path(sys.argv[1]).with_suffix( ".pages.json")out.write_text(json.dumps(pages, ensure_ascii=False), "utf-8")print(f"{len(pages)} 页,{sum(len(p[ 'text']) for p in pages)} 字")
python
$ python extract.py 框架协议.pdf✅ 47 页,28461 字 → 框架协议.pages.json
bash
双栏合同先按栏切,否则左右栏会串成一行。
工程三个坑:双栏合同 extract_text 会把左右栏串成一行,用 layout=True 或先按栏切;页眉页脚每页重复会污染切片,提取后去掉重复率最高的两行;扫描件抽出来是空串,先上 OCR。
第 2 步:按条款切片,不要按字数切重点
按 3000 字硬切会把一条条款切成两半,风险点落在断点上就丢了。按结构切:
切法不复杂:逐行扫,命中 第X条 或 8.4 这类编号就开一个新块,其余行追加到当前块,页码跟着记录。切不出来就退化为按页。这份合同切出 68 块,最长 1240 字。
编号不统一的合同,先把"第八条"归一成"第8条"再切。
第 3 步:提示词,核心是"必须带出处"
# 角色你是甲方的合同审核助理。你的判断会被法务复核,所以宁可漏报也不要误报,但每一条报出来的都必须能在原文里定位。# 素材一段合同条款原文,附页码范围。只分析这一段,不要推测其他条款的内容。【粘贴你的条款文本与页码】# 输出结构只输出 JSON,不要解释文字。格式:{"risks":[...]},每项包含level 高|中|低、type 付款|违约|知识产权|保密|期限|终止|责任限制|其他、clause 条款号、page 页码、quote原文逐字摘录不超过 60 字、why 对我方的具体不利后果、suggest可谈判的修改方向。没有风险就返回 {"risks": []}。# 质量约束quote 必须能在原文逐字找到,找不到就不要输出这一条。不要写"建议仔细阅读""请注意风险"这类空话。level 判定:金额无上限、单方解除权、无限责任、自动续期算高;义务不明确、期限模糊、验收标准主观算中;其余算低。# 澄清机制如果这段明显是目录、页眉、附件清单,返回空数组,不要硬找风险。
text
产品level 的四条"高"标准我写死了,没让它自由发挥。分级如果不能复现,就没法拿它做决策——今天判"高"、明天同一句判"中",比不分级更糟。
第 4 步:批量跑 + 汇总避坑
# scan.py —— pip install openai>=1.30import json, os, pathlibfrom openai import OpenAIcli = OpenAI(api_key=os.environ[" LLM_API_KEY"], base_url=os.environ.get(" LLM_BASE_URL", "https://api.deepseek.com/v1" ))prompt = pathlib.Path("prompt_contract.txt" ).read_text("utf-8")chunks = json.loads(pathlib.Path(" chunks.json").read_text("utf-8"))risks = []for i, c in enumerate(chunks, 1): msg = f"页码:{c['pages'][0]}-{c[ 'pages'][-1]}\n条款:{c['title']}\n\n{ c['text']}" try: r = cli.chat.completions.create( model="deepseek-chat", temperature=0, response_format={"type": "json_object"}, messages=[{"role": "system", "content": prompt}, {"role": "user", "content": msg}]) risks += json.loads(r.choices[ 0].message.content).get("risks", []) except Exception as e: print(f"[{i}] {c['title']}: {e}")risks.sort(key=lambda x: ({"高": 0, "中": 1, "低": 2}.get(x.get("level"), 9), x.get("page", 0)))pathlib.Path("risks.json").write_text( json.dumps(risks, ensure_ascii=False), "utf-8")print(f"合计 {len(risks)} 条")
python
$ python scan.py✅ 合计 31 条,高 9 条
bash
temperature=0 保证同一份合同跑两次结果一致,json_object 保证可解析。第一次跑,模型在 JSON 前加了句"以下是分析结果:",json.loads 直接炸,后来用 raw.find('{') 到 rfind('}') 兜底。
第 5 步:抽查出处
这步别跳。 抽 3 条,去原文里搜 quote,搜得到才信:
$ grep -c "甲方提前终止本协议的" 框架协议.pages.json✅ 1
bash
引文定位失败率超过 10%,多半是双栏串行。停下来修管道,别继续看结论。
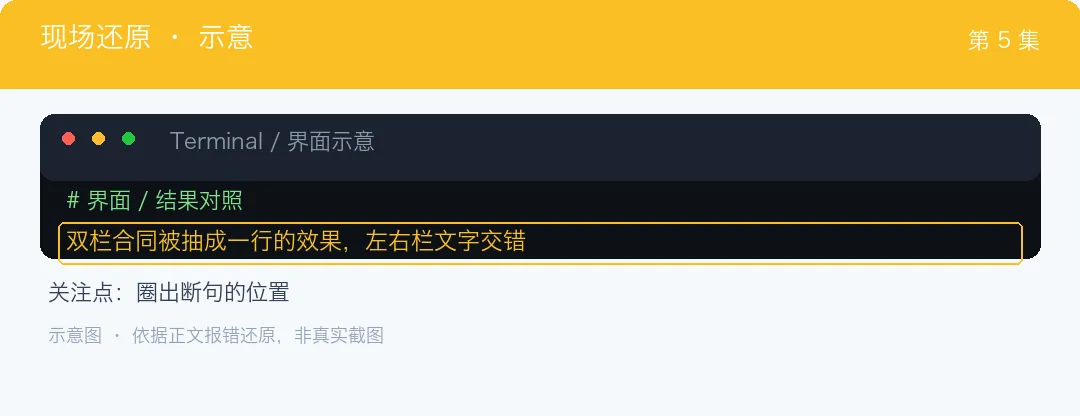
现场还原示意:双栏合同被抽成一行的效果 左右栏文字交错 圈出断
quote 对不上就丢掉这条,别改几个字凑——凑出来的引文比漏报更危险。四、成品长什么样
第 2 条是 SaaS 合同的核心博弈点,AI 能揪出来,是因为提示词把"责任限制"列为必查。
五、验收、风险与成本
产品验收标准(四条)
[ ] 每条都有页码、逐字引文、具体后果 [ ] 引文抽查定位成功率 ≥ 90% [ ] 高危项逐条看过,中低危扫一遍标题 [ ] 输出按"高→中→低"排,同级按页码
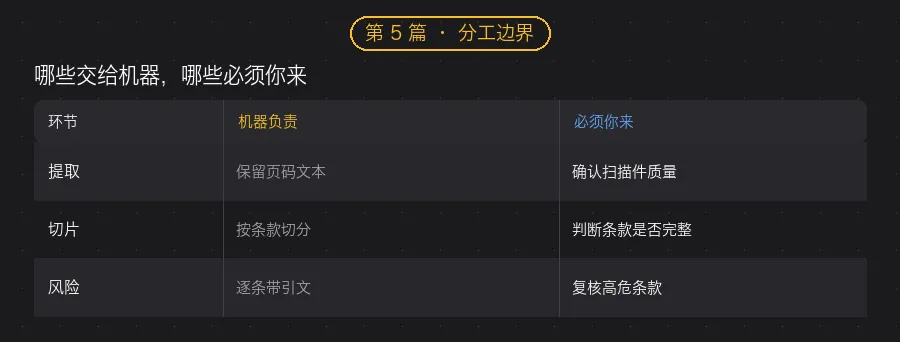
插图2 四类必查条款:AI 该查什么、法务该看什么
经理什么不能交给 AI
- "AI 说没问题"不能当成没问题。
它漏一条,责任还是签字的人。这套流程只是把 47 页压到 9 条,不是替代法务。 - 合同原文不能随便上云。
金额、客户、商业条款,用企业版或有数据协议的 API;金融、医疗、政务合同走本地加内网。 - 不要让它给法律结论。
它说"该条款无效"没有效力,让它在 why里写事实。 - 保留复核记录。
谁看了、为什么接受风险,要留痕。出了事,流程记录比结论重要。
经理算笔账:47 页合同,人工首轮 2–3 小时,法务精读 4 小时;这套 5 分钟加复核 40 分钟。一年 30 份,省 60 多小时。
但真正的价值是它每次都查同一套项,不会像人一样今天累了就少看两页。
工程成本:68 块 × 约 1200 token,一次全量扫描约 8 万 token,几毛钱。按条款文本 hash 缓存能省 80% 重复调用,改一版只有几处变动。并发控制在 5 以内。
边界条件
20–80 页文字版正好,68 块一次扫完;200 页以上要先分章,否则块数过百,成本和复核时间都上来;扫描件先 OCR,抽不出字后面全白搭;手写批注、附件表格会漏,它们不在正文流里。
变体迁移
NDA 把 type 换成"保密期限、披露范围、违约责任";劳动合同换成"竞业限制、试用期、解除条件"。切片规则不用改,只换提示词里的必查类型和 level 标准。
六、写在最后
AI 真正改变的不是"读得快",是它愿意一行一行读完。人会跳读,然后带着"应该没什么问题"的错觉签字。
明天第六篇:那封不知道怎么回的邮件。轻一点,但会给一套"三档语气"的回复模板——同一件事,怎么跟老板说、怎么跟客户说、怎么跟同事说。
⚠️ 免责提醒:这份风险表是提词器,不是法律意见。签字前让法务看一眼,责任是你的。
觉得有用的话,点个赞和在看,关注一下,21 天连更不掉队。
—— 把 AI 当成牛马的那个人
📌 顺便说一句
这篇文章的方法,出自 51CTO 学堂的《Codex 从入门到实战 · 全流程实战课》(零基础可学):
- 20 个实战项目
:文案、图片、音视频、Word / Excel / PPT / PDF 处理、爬虫、浏览器与电脑自动化……一个项目一个能跑的成品 - 8 大模块
:实战项目 / 技能 / 自动化 / 模型上下文协议(MCP)/ 规则文件 / 钩子 / 工作树 / 命令行 零基础可学,跟着做就能跑起来
👉 课程入口: