ARTICLE · 1370781
微软开源插件读完仓库历史:AI 干活成本降 31%,省的不是聪明是记性
01|每 10 块钱里,有 3 块买的是旧知识
每花 10 块钱让 AI 干活,有 3 块买的是它上周就知道的事。
这是微软研究院上周拆出来的账。他们盯着一群编码智能体干了 277 个真实任务,把每一笔 token 花费摊开看,发现重复消费高得离谱。
你可能也似曾相识。昨天让它改一下配置,它把项目结构重新摸了一遍;今天换个任务,它又把同一批文件读了一遍。每次你都付全价,它每次都像头一年来上班。
那 3 块钱,微软管它叫浪费,我给它起了个名字,叫从零税。
这篇接着昨天说。昨天写配方资产,结论是存规则不存像素。今天往钱的方向再走一步:你的 AI 账单里,最贵的一项可能不是模型,是它每天白手起家。
02|微软把 277 个任务的账单拆开了
先交代出处。这份研究来自加州大学伯克利分校和微软研究院、微软安全团队,开源插件叫 TokenEconomizer,论文和代码都公开。
他们的做法不复杂。把 6 个代码仓库、277 个真实的修 bug 任务,交给 5 种不同的智能体和模型组合,一组装插件,一组不装,别的都不动。
结果是 18.4% 到 30.9% 的成本下降,30 组仓库加模型的配对全部省钱,没有一组性能变差。5 个组合里,有 4 个的任务成功率反而涨了。
钱浪费在哪,他们拆出三笔账。
重复摸底 仓库攒够 5 个任务之后,30% 的工具调用在重复早前任务里做过的动作,比如重新跑一遍测试命令
白付工具钱 智能体每一轮都收到 23 个工具的说明书,其中 16 个从头到尾没被用过一次
失败最烧钱 17% 没做成的任务,吃掉了 32% 的总花费
03|这三笔钱有一个共同的名字
三笔账看着分散,根子是同一个:每个新会话都从零开始。
模型本身有知识,但没有你仓库的记忆。测试命令是什么、哪个文件是雷区、哪条路走不通,这些事上个会话刚刚发生过,下个会话照样要重新发现一遍。每一次重新发现,你都在付钱。
更有意思的是另一个数字。同样的动作,在同一个仓库的历史里重复的占 30%,放到别的仓库就只剩 7%。
这说明从零税是按项目收的。经验留在仓库里,换一个项目就清零。
那你说,这税有没有免掉的办法?
微软试过一个最常见的思路,把模型的推理档位调低。省下来的钱差不多,但任务表现明显掉了一截。单价是降了,活也干砸了。
而读历史这条路,30 组配对没有一个掉性能,还有 4 组成功率上升。这就是两条路的分岔口。
04|换模型省的是单价,读历史省的是学费
有人会想到另一条路:换个更便宜的模型。
巧了,就在昨天,阿里发布了 Qwen4-Max,2.4 万亿参数的旗舰,官方口径说内部测试里单任务成本从 4.43 美元降到 1.67 美元,降了六成多。按单价算,这比读历史省得多。
但这两笔钱不是一笔钱。
换模型砍的是每一个字的单价。从零税砍不掉,因为不管模型多便宜,它进你的仓库还是要重新摸一遍结构、重新试一遍命令。便宜的单价乘以同样冗长的过程,账单只是从小贵变成中贵。
真正的组合拳是两层都动。单价上,昨天写过降档,该降就降。浪费上,就是今天这篇的事。
一个判断给你:模型决定每个字多少钱,记性决定你要买多少个字。大部分人只盯着前者,因为价签明晃晃挂在官网。后者藏在你的会话日志里,看不见,所以没人管。
看不见的账,才是最贵的账。
05|它的三个机制,一个都不聪明
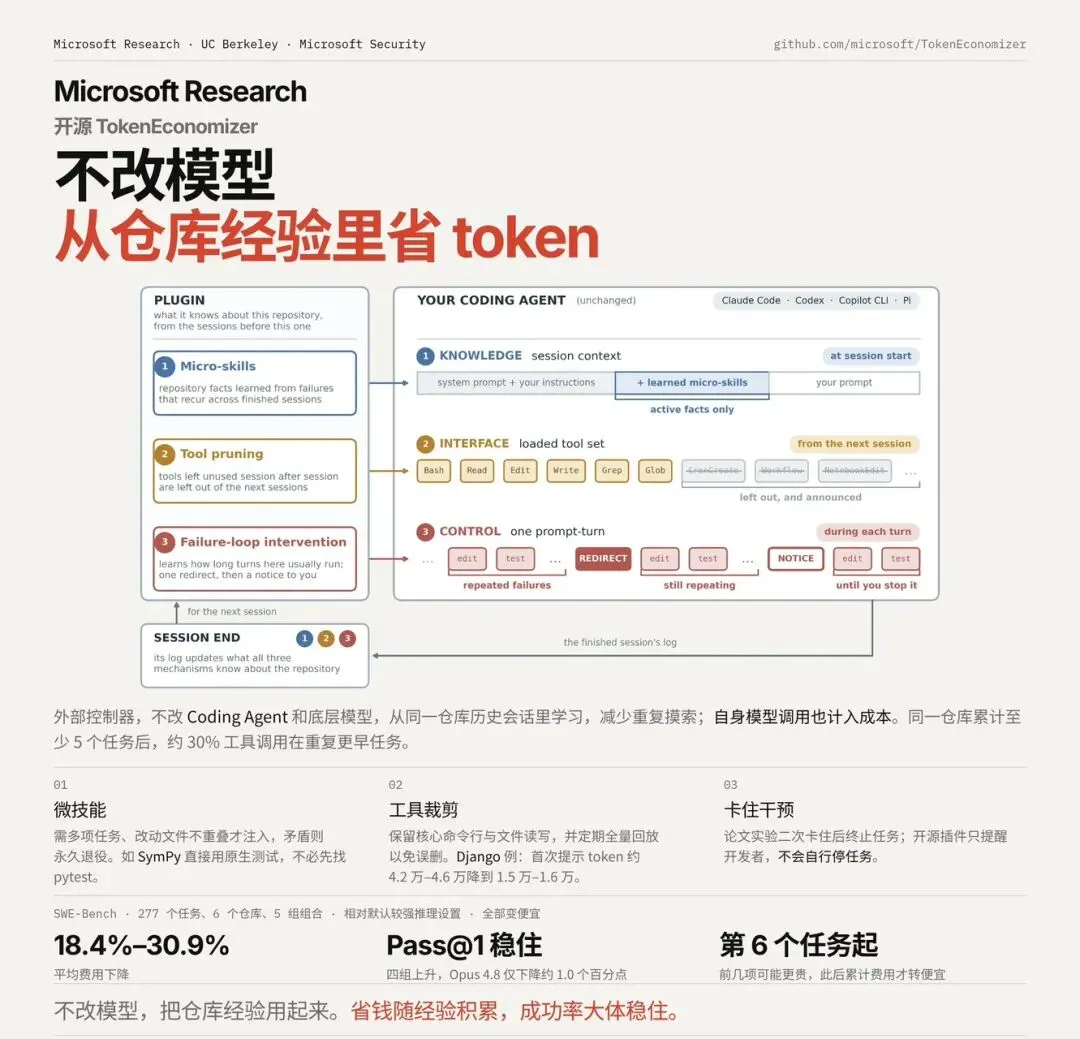
TokenEconomizer 怎么做到的?拆开看,三个机制,没有一个用到了什么高深技术。
一行笔记 每个会话结束后读日志,把重复出现的规律写成一行话,比如测试命令是什么。注意它不急着写,要好几个会话都验证过同一条规律才放进上下文,后面证据反了就自动撤掉
裁工具 23 个工具说明书里,历史显示从没碰过的 16 个,后面不发。核心的跑命令和改文件工具永远保留,误删了一条命令就能恢复
卡死改道 智能体反复撞同一个错误时,一个小裁判模型判断它是真卡住了还是在正常试错。真卡住,就塞一张纸条建议换条路。开源版只提醒你,不会替你叫停
但这里有个问题:这跟我自己给项目写一份说明文档有啥区别?
区别在退役机制。你手写的笔记,只会越加越多,错的那条永远躺在里面,下个月还在误导你。它那条笔记是活的,证据一变就撤。我自己的 CLAUDE.md 里就躺着几条半年没更新过的旧规矩,我现在都不敢确定还对不对。
另一个细节值得单独说:回本点。插件刚装上没有任何历史,前几个任务省不了钱甚至多花,微软的口径是累计成本从第 6 个任务起低于不装的状态。
06|我拿自己的流水线验了一遍
光看论文不算数,我昨天承诺了要拿自己的活验一遍。
昨天的文章预告了今天要做 10 张封面实测:用固定的模板提示词,只换主题物,给我的文章生成 10 张封面,记三个数,一次过几张、废几张、总共多少分钟。
今天上午跑完了。数字如下。
一次过 9 张
废 1 张
总耗时 5 分 02 秒,其中生成 2 分 53 秒,逐张目检 2 分钟
废的原因 那张画了一根贯穿全图的长账单,画面上下全被吃掉,没有留白放标题
先说好,判废标准是提前定的,不是事后挑毛病:无乱码文字、主体完整不畸形、上三分之一留白放标题、水印不遮主体。四条全过才算过。
跟一个月前比一下。上个月我做 3D 数据看板,六个版本全废,四个小时打了水漂。今天 10 张里活 9 张,成本 5 分钟。
差别不在模型变强了。差别在模板里存着规则:无外部素材、主体拆组件、上三分之一留白。昨天那篇文章管这个叫配方资产,今天微软的研究给了它一个更贴切的学名,叫经验复用。
07|废掉的那张,改了模板一条规则
那你说,10 张的样本是不是太小了?
太小,我承认。统计上说明不了什么。但这件事的重点不在 90% 这个数,在废掉的那一张做了什么。
它没有白白废掉。跑完我就往模板里加了一条:物体高度不超过画面三分之二,上下各留出空白。下回再跑,这类废法就绝种了。
你发现没有,这就是刚才微软那三个机制里第一个的活人版:从失败的会话里提炼一行规则,验证之后放进下次的上下文。我花了一个月零几天,手工长出了一个小号的 TokenEconomizer。
今天用的封面就是这次实验的第 8 张,计数器归零那幅。实验产物直接上了岗,零额外成本。
一条规则只救一张图,看着不起眼。可你的流水线每天跑,一条规则乘以 365 天,就是一笔实打实的钱和时间。这也是我 11 月 12 号写错误资产化时说的那条老路:错一次不可怕,错完不变成规则才可怕。
08|这笔账,列成一张表
下面五行是我建议你截图存下来的,选型的时候照着比。
微软实测 277 个任务、6 仓库、5 种组合,成本降 18.4% 到 30.9%,30 组配对全部省钱且无一掉性能
对照组 把推理档位调低,省得差不多,但任务表现明显变差,这条路微软帮你排除了
换模型 阿里 Qwen4-Max 官方口径,单任务 4.43 美元降到 1.67 美元,砍的是单价,砍不掉浪费
回本点 插件从零开始攒经验,累计成本从第 6 个任务起反超默认配置
经验边界 经验只在同一个仓库里有效,30% 的重复发生在这里,跨仓库只剩 7%,换项目要重新攒
注意两点风险,不然像卖课。这是研究阶段的项目,还没有正式版本,实验性的接入别直接上生产。另外它读的是你的会话日志,数据留在本机,但企业代码库要不要让插件读日志,这个决定得你自己过合规。
09|今天下午就能做的三步
不装插件也能先自检,装了插件更好,两套都给你。
装插件的三条命令,我放在这,直接复制:
git clone https://github.com/microsoft/TokenEconomizer.gitcd TokenEconomizer && claude plugin marketplace add "$PWD"claude plugin install tokeneconomizer@tokeneconomizer
装完启动你的编码智能体,跑一次状态命令确认生效,临时不想要就设一个环境变量单次关闭。
不装插件的,把这三个问题问一遍你自己的 AI 工作流:
1. 我的 AI 每天在重复执行哪些上个会话已经做过的动作?2. 我的每次请求里,有没有从来没被用到过的工具和说明?3. 我最近一次失败的任务,失败原因有没有变成一条固定规则?
三个问题里有任何一个答不上来,你的从零税就在照常征收。
10|三句话
定义 从零税是 AI 每个新会话重新发现旧事实的成本,占你账单的三成上下,模型越忙交得越多。
机制 单价由模型决定,浪费由记性决定。省钱靠让经验进上下文,不靠换更便宜的大脑。
我怎么做 封面模板已经补上第 5 条规则,明晚跑第二批 10 张验证;编码智能体装上插件,第 6 个任务后开始对账。
下期预告两件事。明天的文章交封面第二批的账,看新规则能不能把一次过率从 9 抬到 10。这周日在日更流水线复盘里,交自动回退连跑 7 天的账,今天第 2 天,日志在记,跑不出来我照实说。
轮到你了。你的 AI 每天干多少活是它上一次已经干过的?不用精确,报个大概数,我按今天的算法帮你折成钱。
关注「李大嘴在用 AI」,每天一篇能算账的 AI 观察。
我是李大嘴,一个靠 AI 干活、也替 AI 交学费的打工人。